
Comment remplacer les valeurs manquantes (NA) dans R : na.omit et na.rm
 Evelyn Clarke
⚡ Résumé intelligent
Ce tutoriel sur le remplacement des valeurs manquantes dans R explique comment détecter les valeurs NA, supprimer les lignes incomplètes avec `na.omit()` et les imputer avec la moyenne ou la médiane grâce à `mutate()`. Il utilise le jeu de données Titanic, où les variables `age` et `fare` comportent des valeurs manquantes.
Que sont les valeurs manquantes en R ?
Les valeurs manquantes apparaissent lorsqu'aucune valeur n'est enregistrée dans une colonne pour une observation donnée, ou lorsqu'une valeur non numérique remplace un nombre. Elles doivent être supprimées ou remplacées avant tout calcul, car la plupart des fonctions R renvoient NA dès qu'une valeur manquante est présente.
Ce tutoriel explique comment gérer les valeurs manquantes avec la bibliothèque dplyr, qui fait partie de l'écosystème tidyverse pour l'analyse de données.
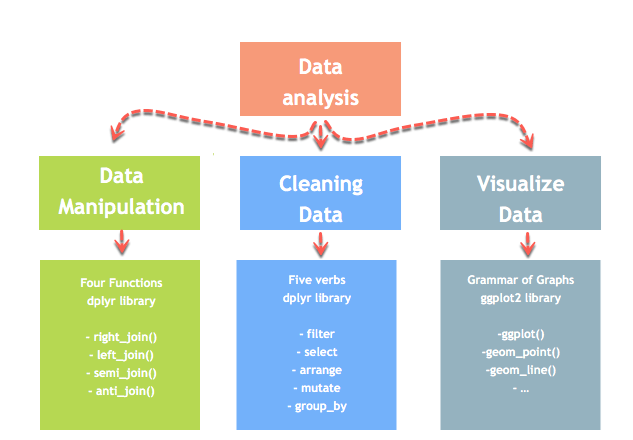
La première étape consiste toujours à déterminer combien de valeurs sont manquantes et où.
Comment détecter et compter les valeurs manquantes en R
Avant de décider comment traiter les valeurs manquantes, il est nécessaire de connaître leur nombre et leur emplacement. R propose quatre méthodes de vérification, allant d'une simple réponse par oui ou par non à un décompte complet par colonne.
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
En pratique, c'est la fonction `colSums()` qu'il faut privilégier. Elle renvoie un vecteur nommé avec un comptage par colonne, ce qui permet de voir immédiatement si une variable comporte quelques valeurs manquantes ou si elle est presque vide.
Comptage des lignes complètes. La fonction `complete.cases()` renvoie `TRUE` pour les lignes ne contenant aucune valeur manquante, ce qui vous indique à l'avance la quantité de données que `na.omit()` supprimerait :
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
Avertissement concernant les espaces réservés. R ne reconnaît que les valeurs manquantes (NA). Les jeux de données encodent fréquemment les valeurs manquantes sous forme de chaîne vide, d'espace, de « N/A », de tiret (« - ») ou d'un nombre sentinelle tel que -99 ou 999. Ces valeurs passent inaperçues lors des vérifications précédentes. Il est donc nécessaire de les convertir lors de l'importation afin d'assurer le bon fonctionnement du reste du flux de travail.
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
Après l'importation, vérifiez toujours la plage de valeurs de chaque colonne numérique. Une valeur d'âge de -99 ou un tarif de 9999 sont bien plus problématiques qu'une valeur NA légitime, car aucune fonction ne vous avertira.
Types de données manquantes : MCAR, MAR et MNAR
La raison pour laquelle une valeur est manquante détermine si son imputation est sans risque. Les statisticiens identifient trois mécanismes.
- MCAR, manquant de manière totalement aléatoire. La probabilité de disparition est indépendante de tout facteur, observé ou non, par exemple un capteur qui tombe en panne de façon aléatoire.ping ou l'imputation de ces lignes n'introduit aucun biais, seulement une perte de précision.
- MAR, manquant au hasard. La probabilité dépend d'autres variables observées, mais pas de la valeur manquante elle-même. Si l'âge des passagers plus âgés était moins susceptible d'être enregistré, l'âge est considéré comme MAR (moyenne aberrante) compte tenu des autres colonnes. L'imputation utilisant ces colonnes permet de gérer efficacement ce cas.
- MNAR, manquant non aléatoirement. La probabilité dépend de la valeur non observée elle-même ; par exemple, les personnes à hauts revenus peuvent refuser de déclarer leurs revenus. Aucune méthode d’imputation ne peut corriger ce problème à partir des seules données, et l’absence de données recèle des informations qu’il est pertinent d’enregistrer dans une colonne d’indicateur.
L'imputation par la moyenne, telle qu'utilisée dans ce tutoriel, n'est acceptable que dans le cas d'une imputation MCAR (MCAR) et d'une imputation MAR (Marginal Added Rate) simple. Même dans ces cas, elle présente un inconvénient majeur : remplacer chaque valeur manquante par la même valeur réduit la variance de la colonne et affaiblit sa corrélation avec toutes les autres. Pour des applications plus rigoureuses, il est recommandé d'utiliser une méthode basée sur un modèle, comme celle proposée par le package mice, et de toujours conserver une colonne d'indicateurs signalant les valeurs imputées.
subir une mutation()
mutate() est le déplyr verbe qui crée une nouvelle variable ou écrase une variable existante, ce qui en fait l'outil naturel pour construire une copie propre d'une colonne.
Nous procéderons en deux parties. Nous apprendrons comment :
- exclure les valeurs manquantes d'un bloc de données
- imputer les valeurs manquantes avec la moyenne et la médiane
Le verbe mutate() est très simple à utiliser. Nous pouvons créer une nouvelle variable en suivant cette syntaxe :
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
Exclure les valeurs manquantes (NA)
La fonction `na.omit()` est une fonction de base de R, et non une fonction de dplyr, mais elle s'utilise tout aussi bien. Elle supprime toutes les lignes contenant au moins une valeur manquante (NA). C'est l'option la plus rapide, mais rarement la meilleure, car une seule valeur manquante suffit à invalider l'observation entière.
Pour résoudre le problème des observations manquantes, nous utiliserons l’ensemble de données titanesque. Dans cet ensemble de données, nous avons accès aux informations des passagers à bord lors du drame. Cet ensemble de données contient de nombreuses NA qui doivent être prises en compte.
Chargez le fichier CSV depuis Internet, puis listez les colonnes contenant des valeurs NA :
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
Sortie :
## [1] "age" "fare"
Ici,
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
renvoie les noms des colonnes contenant au moins une valeur manquante.
Les colonnes âge et tarif comportent des valeurs manquantes.
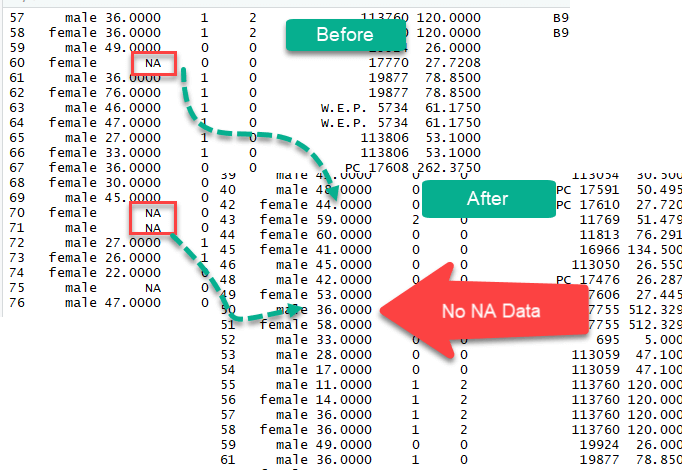
Nous pouvons les supprimer avec na.omit().
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
Sortie :
## [1] 1045 13
Le nouvel ensemble de données contient 1045 1309 lignes, contre pour l’ensemble de données d’origine.
Imputer les données manquantes avec la moyenne et la médiane
Il est également possible d'imputer, c'est-à-dire de remplacer les valeurs manquantes par la moyenne ou la médiane. Il est recommandé de créer deux variables distinctes pour la moyenne et la médiane. Une fois ces variables créées, on peut remplacer les valeurs manquantes par celles-ci.
Nous utiliserons la méthode apply pour calculer la moyenne de la colonne avec NA. Voyons un exemple
Étape 1) Plus tôt dans le didacticiel, nous avons stocké le nom des colonnes avec les valeurs manquantes dans la liste appelée list_na. Nous utiliserons cette liste
Étape 2) Calculez la moyenne avec l'argument na.rm = TRUE. Cet argument est obligatoire car les colonnes contiennent des données manquantes ; il indique à R de les ignorer.
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code Explication:
Nous passons 4 arguments dans la méthode apply.
- df : df_titanic[,colnames(df_titanic) %in% list_na]. Ce code renverra le nom des colonnes de l'objet list_na (c'est-à-dire « âge » et « tarif »)
- 2 : Calculer la fonction sur les colonnes
- moyenne : Calculer la moyenne
- na.rm = TRUE : ignorer les valeurs manquantes
Sortie :
##      age     fare
## 29.88113 33.29548
Nous avons réussi à créer la moyenne des colonnes contenant les observations manquantes. Ces deux valeurs serviront à remplacer les observations manquantes.
Étape 3) Remplacer les valeurs NA
Le verbe muter de la bibliothèque dplyr est utile pour créer une nouvelle variable. Nous ne voulons pas nécessairement changer la colonne d'origine pour pouvoir créer une nouvelle variable sans le NA. mutate est facile à utiliser, il suffit de choisir un nom de variable et de définir comment créer cette variable. Voici le code complet
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code Explication:
Nous créons deux variables, replace_mean_age et replace_mean_fare comme suit :
- replace_mean_age = ifelse(is.na(age), Average_missing[1], age)
- replace_mean_fare = ifelse(is.na(tarif), Average_missing[2],tarif)
Si la colonne age a des valeurs manquantes, remplacez-la par le premier élément de Average_missing (moyenne de l'âge), sinon conservez les valeurs d'origine. Même logique pour le tarif
sum(is.na(df_titanic_replace$age))
Sortie :
## [1] 263
Après le remplacement, la nouvelle colonne ne contient plus aucune valeur manquante :
sum(is.na(df_titanic_replace$replace_mean_age))
Sortie :
## [1] 0
La colonne d'âge d'origine contient 263 valeurs manquantes, tandis que la nouvelle colonne replace_mean_age les a toutes remplies avec l'âge moyen.
Étape 4) Nous pouvons également remplacer les observations manquantes par la médiane.
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
Sortie :

Étape 5) Sur un vaste ensemble de données, la méthode pas à pas devient fastidieuse. La fonction `sapply()` condense toute la procédure en une seule instruction, au prix de ne jamais visualiser les valeurs imputées.
sapply ne crée pas de trame de données, nous pouvons donc envelopper la fonction sapply() dans data.frame() pour créer un objet de bloc de données.
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
Imputation moderne avec replace_na() et across()
Les approches apply() et sapply() ci-dessus fonctionnent toujours, mais tidyr et dplyr expriment désormais les mêmes opérations de manière plus sûre et plus lisible.
replace_na() pour les valeurs fixes. tidyr::replace_na() prend une liste nommée de colonnes et leurs remplacements :
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
Pour chaque colonne numérique, utilisez la fonction across(). Il s'agit du remplacement direct et sûr en termes de types pour la fonction sapply() en une seule ligne, et contrairement à sapply(), elle ne touche jamais aux colonnes de caractères ou de facteurs :
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ Pourquoi le raccourci sapply() est risqué : l'exemple sapply() en une seule ligne s'exécute sur chaque La colonne, y compris les colonnes de type caractère et facteur, est affectée par la fonction mean() qui renvoie NA avec un avertissement. La fonction sapply() convertit ensuite l'ensemble du résultat en caractère. La version across(where(is.numeric), …) présentée ci-dessus évite complètement ce problème.
coalesce() pour les colonnes de repli. Lorsqu'une deuxième colonne peut fournir la valeur manquante, coalesce() renvoie la première entrée non manquante parmi ses arguments :
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
Notez ce que vous avez modifié. Ajoutez un indicateur avant l'imputation, afin que tout modèle ultérieur puisse tirer des enseignements du fait qu'une valeur était manquante :
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
Gestion des valeurs manquantes en R : Référence de la méthode
Ce tutoriel aborde trois approches :
- Exclure toutes les observations manquantes
- Imputer avec la moyenne
- Imputer avec la médiane
Le tableau ci-dessous récapitule la détection et la suppression :
| Bibliothèque | Objectif | Code |
|---|---|---|
| base | Liste des observations manquantes |
colnames(df)[apply(df, 2, anyNA)] |
| base | Supprimez toutes les lignes contenant NA. |
na.omit(df) |
L'imputation avec moyenne ou médiane peut être effectuée de deux manières
- Utiliser Appliquer
- Utiliser sapply
| Méthode | DÉTAILS | Avantages | Désavantages |
|---|---|---|---|
| Étape par étape avec postuler | Vérifiez les colonnes manquantes, calculez la moyenne/médiane, stockez la valeur, remplacez par mutate() | Vous pouvez voir la moyenne ou la médiane imputée | Plus de temps d'exécution. Peut être lent avec un grand ensemble de données |
| Méthode rapide avec sapply | Utilisez sapply() et data.frame() pour rechercher et remplacer automatiquement les valeurs manquantes par la moyenne/médiane | Code court et rapide | Les valeurs imputées ne sont jamais affichées. |
