
Fonctions dans la programmation R avec exemple
 Evelyn Clarke
⚡ Résumé intelligent
Dans R, les fonctions regroupent un ensemble d'instructions sous un même nom, permettant ainsi d'exécuter une tâche répétitive en un seul appel. R propose des fonctions intégrées pour les mathématiques et les statistiques, des fonctions définies par l'utilisateur et des variables d'environnement.pingLes arguments conditionnels et les arguments conditionnels sont abordés ici avec des exemples concrets.
Qu’est-ce qu’une fonction dans R ?
A fonction, dans un environnement de programmation, est un ensemble d'instructions. Un programmeur construit une fonction pour éviter répéter la même tâche, ou réduire complexité.
Une fonction doit être
- écrit pour accomplir une tâche spécifique
- peut ou non inclure des arguments
- contenir un corps
- peut renvoyer une ou plusieurs valeurs.
Une approche générale d'une fonction consiste à utiliser la partie argument comme entrées, nourrissez le corps partie et enfin retourner un sortie. La syntaxe d'une fonction est la suivante :
function (arglist)  {
  #Function body
}
R fonctions intégrées importantes
Il existe de nombreuses fonctions intégrées dans R. R fait correspondre vos paramètres d'entrée avec ses arguments de fonction, soit par valeur, soit par position, puis exécute le corps de la fonction. Les arguments de la fonction peuvent avoir des valeurs par défaut : si vous ne spécifiez pas ces arguments, R prendra la valeur par défaut.
Note:
Il est possible de voir le code source d'une fonction en exécutant le nom de la fonction elle-même dans la console.
Typing Un nom de fonction sans crochets affiche son code source, comme le montre la console ci-dessous.

Nous verrons trois groupes de fonctions en action
- Fonction générale
- Fonction mathématique
- Fonction statistique
Fonctions générales
Nous connaissons déjà les fonctions générales telles que cbind(), rbind(), range(), sorte()`order()` et `order()`. Chacune de ces fonctions a une tâche spécifique, prend des arguments et renvoie un résultat. Voici quelques fonctions importantes à connaître :
fonction diff()
Si vous travaillez sur des séries chronologiques, il faut arrêter la série en prenant leur valeurs de décalage. A processus stationnaire Permet de maintenir la moyenne, la variance et l'autocorrélation constantes au fil du temps. Ceci améliore principalement la prédiction d'une série temporelle. On peut réaliser cela avec la fonction `diff()`. On peut créer une série temporelle aléatoire avec une tendance, puis utiliser la fonction `diff()` pour la rendre stationnaire. La fonction `diff()` accepte un argument, un vecteur, et renvoie les différences décalées et itérées appropriées.
NoteNous devons souvent générer des données aléatoires, mais pour l'apprentissage et la comparaison, nous souhaitons que les nombres soient identiques d'une machine à l'autre. Afin de garantir la génération de données identiques, nous utilisons la fonction `set.seed()` avec des valeurs arbitraires de 123. `set.seed()` fixe le point de départ du générateur de nombres pseudo-aléatoires, de sorte que chaque machine produise la même séquence. Sans `set.seed()`, chaque exécution renverrait une séquence différente.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
Les deux graphiques ci-dessous placent la série cumulative originale à côté de la série différenciée, qui fluctue désormais autour d'une moyenne constante.

fonction longueur()
Dans de nombreux cas, nous avons besoin de connaître la longueur d'un vecteur pour effectuer des calculs ou l'utiliser dans une boucle `for`. La fonction `length()` compte le nombre de lignes du vecteur `x`. Les exemples de code suivants importent le jeu de données `cars` et renvoient le nombre de lignes.
NoteLa fonction `length()` renvoie le nombre d'éléments d'un vecteur. Si la fonction est passée en argument à un vecteur, elle renvoie le nombre d'éléments d'un vecteur. matrice ou un cadre de données, le nombre de colonnes est renvoyé.
dt <- cars
## number columns
length(dt)
Sortie :
## [1] 1
## number rows
length(dt[,1])
Sortie :
## [1] 50
Fonctions mathématiques
Au-delà des fonctions d'assistance générales, R dispose d'un ensemble de fonctions mathématiques qui opèrent élément par élément sur un vecteur.
| Opérateur | Description |
|---|---|
| abs (x) | Prend la valeur absolue de x |
| journal(x,base=y) | Prend le logarithme de x de base y ; si la base n'est pas spécifiée, renvoie le logarithme népérien |
| exp (x) | Renvoie l'exponentielle de x |
| sqrt (x) | Renvoie la racine carrée de x |
| factorielle(x) | Renvoie la factorielle de x (x !) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
Sortie :
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
Sortie :
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
Sortie :
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
Fonctions statistiques
Là où les fonctions mathématiques transforment les valeurs, les fonctions statistiques les résument. L'installation standard de R contient un large éventail de fonctions statistiques. Dans ce tutoriel, nous aborderons brièvement les plus importantes.
Fonctions statistiques de base
| Opérateur | Description |
|---|---|
| moyenne(x) | Moyenne de x |
| médiane(x) | Médiane de x |
| variable(x) | Variation de x |
| sd(x) | Écart type de x |
| échelle(x) | Scores standards (z-scores) de x |
| quantile(x) | Les quartiles de x |
| résumé(x) | Résumé de x : moyenne, min, max etc. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
Sortie :
## [1] 15.4
# Median speed of cars dataset
median(speed)
Sortie :
## [1] 15
# Variance speed of cars dataset
var(speed)
Sortie :
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
Sortie :
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
Sortie :
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
Sortie :
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
Sortie :
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
Jusqu’à présent, nous avons appris beaucoup de fonctions intégrées de R.
NoteFaites attention au classe de l'argument, c’est-à-dire numérique, booléen ou chaîne de caractères. Par exemple, si nous devons transmettre une valeur de type chaîne de caractères, nous devons l’entourer de guillemets : « ABC ».
Fonction d'écriture dans R
Dans certains cas, nous devons écrire notre propre fonction car nous devons accomplir une tâche particulière et aucune fonction toute faite n'existe. Une fonction définie par l'utilisateur implique un Le nom, arguments , l’aspect économique corps.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
Note: Une bonne pratique consiste à nommer une fonction définie par l'utilisateur différente d'une fonction intégrée. Cela évite toute confusion.
Fonction à un argument
Dans l’extrait suivant, nous définissons une simple fonction carrée. La fonction accepte une valeur et renvoie le carré de la valeur.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code Explication
- La fonction est nommée square_function ; on peut l'appeler comme on veut.
- Il reçoit un argument « n ». Nous n'a pas précisé le type de variable pour que l'utilisateur puisse passer un entier, un vecteur ou une matrice
- La fonction prend l'entrée « n » et renvoie le carré de l'entrée. Lorsque vous avez fini d'utiliser la fonction, nous pouvons la supprimer avec la fonction rm().
# après avoir créé la fonction
rm(square_function)
square_function
Sur la console, on peut voir un message d'erreur :Error: object 'square_function' not found indiquant que la fonction n'existe pas.
Environnement Scoping
Dans R, le convivial est une collection d'objets tels que des fonctions, des variables, des cadres de données, etc.
R ouvre un environnement à chaque démarrage de RStudio.
L'environnement de niveau supérieur disponible est le environnement global, appelé R_GlobalEnv. Et nous avons le environnement local.
Nous pouvons lister le contenu de l'environnement actuel.
ls(environment())
Sortie
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
Vous pouvez voir toutes les variables et fonctions créées dans R_GlobalEnv.
La liste ci-dessus variera pour vous en fonction du code historique que vous exécutez dans RStudio.
Notez que n, l'argument de la fonction square_function ne se trouve pas dans cet environnement global.
Un nouvel environnement est créé pour chaque fonction. Dans l'exemple ci-dessus, la fonction square_function() crée un nouvel environnement à l'intérieur de environnement global.
Pour clarifier la différence entre de défis et locales Dans cet environnement, étudions l'exemple suivant.
Ces fonctions prennent une valeur x comme argument et l'ajoutent à y définir à l'extérieur et à l'intérieur de la fonction

La fonction f renvoie la sortie 15. En effet, y est défini dans l'environnement global. Toute variable définie dans l'environnement global peut être utilisée localement. La variable y a la valeur 10 lors de tous les appels de fonction et est accessible à tout moment.
Voyons ce qui se passe si la variable y est définie à l'intérieur de la fonction.
Nous devons supprimer `y` avant d'exécuter ce code en utilisant rm r
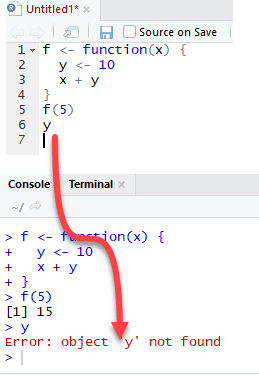
La sortie est également 15 lorsque nous appelons f(5) mais renvoie une erreur lorsque nous essayons d'imprimer la valeur y. La variable y n'est pas dans l'environnement global.
Enfin, R utilise la définition de variable la plus récente pour passer à l’intérieur du corps d’une fonction. Considérons l'exemple suivant :

R ignore les valeurs y définies en dehors de la fonction car nous avons explicitement créé une variable y à l'intérieur du corps de la fonction.
Fonction multi-arguments
Nous pouvons écrire une fonction avec plus d'un argument. Considérons la fonction appelée « fois ». C'est une fonction simple multipliant deux variables.
times <- function(x,y) {
  x*y
	}
times(2,4)
Sortie :
## [1] 8
Quand devons-nous écrire une fonction ?
Les data scientists doivent effectuer de nombreuses tâches répétitives. La plupart du temps, ils copient et collent des portions de code de manière répétée. Par exemple, la normalisation d'une variable est fortement recommandée avant d'exécuter une analyse. machine learning algorithme. La formule pour normaliser une variable est la suivante :

Nous savons déjà comment utiliser les fonctions min() et max() dans R. Nous utilisons la bibliothèque tibble pour créer le bloc de données. Tibble est jusqu'à présent la fonction la plus pratique pour créer un ensemble de données à partir de zéro.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
Nous allons procéder en deux étapes pour calculer la fonction décrite ci-dessus. Dans un premier temps, nous créerons une variable appelée c1_norm qui correspondra au facteur de mise à l'échelle de c1. Dans un second temps, nous copierons et collerons simplement le code de c1_norm et le remplacerons par c2 et c3.
Détail de la fonction avec la colonne c1 :
Nominateur : : data_frame$c1 -min(data_frame$c1))
Dénominateur : max(data_frame$c1)-min(data_frame$c1))
Par conséquent, nous pouvons les diviser pour obtenir la valeur normalisée de la colonne c1 :
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Nous pouvons créer c1_norm, c2_norm et c3_norm :
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
Sortie :
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
Ça marche. Nous pouvons copier et coller
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
puis changez c1_norm en c2_norm et c1 en c2. On fait de même pour créer c3_norm
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
Nous avons parfaitement redimensionné les variables c1, c2 et c3.
Cependant, cette méthode est sujette aux erreurs. On peut copier et oublier de modifier le nom de la colonne après le collage. Par conséquent, il est recommandé d'écrire une fonction chaque fois que le même code doit être collé plus de deux fois. On peut ensuite réorganiser le code en une formule et l'appeler au besoin. Pour écrire notre propre fonction, il nous faut fournir :
- Nom : normaliser.
- le nombre d'arguments : nous n'avons besoin que d'un seul argument, qui est la colonne que nous utilisons dans notre calcul.
- Le corps : c’est tout simplement la formule à laquelle nous souhaitons revenir.
Nous allons procéder étape par étape pour créer la fonction normaliser.
Étape 1) On crée le numérateur, qui est x – min(x). En R, on peut stocker le numérateur dans une variable comme ceci :
nominator <- x-min(x)
Étape 2) Nous calculons le dénominateur : max(x) – min(x). Nous pouvons reproduire l’idée de l’étape 1 et stocker le calcul dans une variable :
denominator <- max(x)-min(x)
Étape 3) Nous effectuons la division entre le nominateur et le dénominateur.
normalize <- nominator/denominator
Étape 4) Pour renvoyer la valeur à la fonction appelante, nous devons passer normalize dans return() pour obtenir la sortie de la fonction.
return(normalize)
Étape 5) Nous sommes prêts à utiliser la fonction par wrapping Tout ce qui se trouve à l'intérieur des parenthèses.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
Testons notre fonction avec la variable c1 :
normalize(data_frame$c1)
Cela fonctionne parfaitement. Nous avons créé notre première fonction.
Une fonction est une méthode plus complète pour effectuer une tâche répétitive. Nous pouvons utiliser la formule de normalisation sur différentes colonnes, comme ci-dessous :
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
Bien que l'exemple soit simple, on peut en déduire la puissance d'une formule. Le code ci-dessus est plus lisible et évite les erreurs liées au copier-coller.
Fonctions avec condition
La fonction normalize() fait toujours la même chose. Parfois, il est nécessaire d'inclure des conditions dans une fonction pour permettre au code de renvoyer des résultats différents.
Dans les tâches d'apprentissage automatique, nous devons diviser l'ensemble de données entre une rame et un ensemble de test. La rame permet à l’algorithme d’apprendre à partir des données. Afin de tester les performances de notre modèle, nous pouvons utiliser l'ensemble de test pour renvoyer la mesure de performance. R n'a pas de fonction pour créer deux ensembles de données. Nous pouvons écrire notre propre fonction pour faire cela. Notre fonction prend deux arguments et s'appelle split_data(). L'idée derrière est simple, nous multiplions la longueur de l'ensemble de données (c'est-à-dire le nombre d'observations) par 0.8. Par exemple, si nous voulons diviser l'ensemble de données 80/20 et que notre ensemble de données contient 100 lignes, alors notre fonction multipliera 0.8*100 = 80. 80 lignes seront sélectionnées pour devenir nos données d'entraînement.
Nous utiliserons l'ensemble de données sur la qualité de l'air pour tester notre fonction définie par l'utilisateur. L'ensemble de données sur la qualité de l'air comporte 153 lignes. On peut le voir avec le code ci-dessous :
nrow(airquality)
Sortie :
## [1] 153
Nous procéderons de la manière suivante :
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
Notre fonction a deux arguments. Le train d’arguments est un paramètre booléen. S'il est défini sur TRUE, notre fonction crée l'ensemble de données de train, sinon, elle crée l'ensemble de données de test.
Nous pouvons procéder comme pour la fonction normalize(). Nous écrivons le code comme s'il n'était exécuté qu'une seule fois, puis nous intégrons la condition dans le corps de la fonction.
Étape 1 :
Nous devons calculer la longueur de l'ensemble de données. Cela se fait avec la fonction nrow(). Nrow renvoie le nombre total de lignes dans l'ensemble de données. Nous appelons la longueur variable.
length<- nrow(airquality)
length
Sortie :
## [1] 153
Étape 2 :
On multiplie la longueur par 0.8. Il renverra le nombre de lignes à sélectionner. Il devrait être 153*0.8 = 122.4
total_row <- length*0.8
total_row
Sortie :
## [1] 122.4
Nous souhaitons sélectionner 122 lignes parmi les 153 lignes de l'ensemble de données sur la qualité de l'air. Nous créons une liste contenant des valeurs de 1 à total_row. Nous stockons le résultat dans la variable appelée split
split <- 1:total_row
split[1:5]
Sortie :
## [1] 1 2 3 4 5
split choisit les 122 premières lignes de l'ensemble de données. Par exemple, nous pouvons voir que notre répartition variable rassemble les valeurs 1, 2, 3, 4, 5 et ainsi de suite. Ces valeurs constitueront l'index lorsque nous sélectionnerons les lignes à renvoyer.
Étape 3 :
Nous devons sélectionner les lignes de l'ensemble de données sur la qualité de l'air en fonction des valeurs stockées dans la variable fractionnée. Cela se fait comme ceci :
train_df <- airquality[split, ]
head(train_df)
Sortie :
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
Étape 4 :
Nous pouvons créer l'ensemble de données de test en utilisant les lignes restantes, 123:153. Cela se fait en utilisant – devant split.
test_df <- airquality[-split, ]
head(test_df)
Sortie :
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
Étape 5 :
Nous pouvons créer la condition à l’intérieur du corps de la fonction. N'oubliez pas que nous avons un train d'arguments qui est un booléen défini sur TRUE par défaut pour renvoyer la rame. Pour créer la condition, nous utilisons la syntaxe if :
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
Ça y est, nous pouvons écrire la fonction. Nous devons seulement changer la qualité de l'air en df parce que nous voulons essayer notre fonction sur n'importe quel trame de données, pas seulement la qualité de l'air :
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
Testons notre fonction sur l'ensemble de données sur la qualité de l'air. Nous devrions avoir un ensemble d'entraînement de 122 lignes et un ensemble de test de 31 lignes.
train <- split_data(airquality, train = TRUE)
dim(train)
Sortie :
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
Sortie :
## [1] 31 6
