
Comment exporter des données de R vers CSV et Excel
 Evelyn Clarke
⚡ Résumé intelligent
L'exportation de données depuis R explique comment écrire un cadre de données aux formats CSV, Excel, SPSS, SAS, STATA et R natif, puis comment transférer ce même fichier vers Google Drive or DropboxChaque exportation suit un modèle précis : une fonction, un cadre de données et un chemin de destination.
Comment exporter des données depuis R
Dans ce tutoriel, nous apprendrons comment exporter des données de l'environnement R vers différents formats.
Pour exporter des données sur le disque dur, vous avez besoin du chemin du fichier et d'une extension. Tout d’abord, le chemin est l’emplacement où les données seront stockées. Dans ce tutoriel, vous verrez comment stocker des données sur :
- Le disque dur
- Google Drive
- Dropbox
Deuxièmement, R peut exporter les données dans de nombreux formats. Ce tutoriel aborde les extensions de fichiers essentielles :
- csv
- XLSX
- RDS
- SAS
- SPSS
- STATUE
Chaque exportation suit la même structure : un appel de fonction, un cadre de données et un chemin de destination.
Exporter vers le disque dur
Pour commencer, vous pouvez enregistrer les données directement dans le répertoire de travail. Le code suivant imprime le chemin de votre répertoire de travail :
directory <- getwd()
directory
Sortie :
## [1] "/Users/15_Export_to_do"
Sauf indication contraire, chaque fichier sera enregistré dans ce répertoire de travail. Le répertoire par défaut varie selon le système ; il s’agit généralement du répertoire personnel de l’utilisateur. macOS et Linux et le dossier Documents sur WindowsCependant, getwd() renvoie toujours la valeur actuelle. Modifiez-la avec setwd(), ou bien transmettez simplement le chemin complet à la fonction d'écriture.
setwd("/Users/USERNAME/Downloads")
Créer un bloc de données
Tout d'abord, créez un petit cadre de données : la moyenne des mpg et de la disp regroupée par vitesse à partir de l'ensemble de données mtcars.
library(dplyr)
df <-mtcars %>%
    select(mpg, disp, gear) %>%
    group_by(gear) %>%
    summarize(mean_mpg = mean(mpg), mean_disp = mean(disp))
df
Sortie :
## # A tibble: 3 x 3
##	gear mean_mpg mean_disp
##	<dbl>	<dbl>	<dbl>
## 1	3 16.10667  326.3000
## 2 	4 24.53333  123.0167
## 3	5 21.38000  202.4800
Le tableau contient trois lignes et trois colonnes. Vous pouvez créer un fichier CSV avec la fonction write.csv dans R.
Comment exporter un DataFrame vers un fichier CSV dans R
La syntaxe de base de write.csv dans R pour exporter le DataFrame au format CSV dans R :
write.csv(df, path)
arguments
-df: Dataset to save. Need to be the same name of the data frame in the environment.
-path: A string. Set the destination path. Path + filename + extension i.e. "/Users/USERNAME/Downloads/mydata.csv" or the filename + extension if the folder is the same as the working directory
Exemple :
write.csv(df, "table_car.csv")
Code Explication
- write.csv(df, « table_car.csv ») : Créez un fichier CSV sur le disque dur :
- df : nom de la trame de données dans l'environnement
- « table_car.csv » : nommez le fichier table_car et stockez-le au format csv
Note: write.csv2() écrit le même fichier en utilisant un point-virgule comme séparateur de champs et une virgule comme séparateur décimal, ce qui est la convention dans une grande partie de l'Europe continentale.
write.csv2(df, "table_car.csv")
NoteÀ des fins pédagogiques uniquement, nous avons créé une fonction appelée `open_folder()` pour ouvrir le dossier. Il vous suffit d'exécuter le code ci-dessous pour voir où se trouve le fichier CSV. Vous devriez y trouver un fichier nommé `table_car.csv`.
# Run this code to create the function
open_folder <-function(dir){
	if (.Platform['OS.type'] == "windows"){
	shell.exec(dir)
	} else {
	system(paste(Sys.getenv("R_BROWSER"), dir))
  }
}
# Call the function to open the folder
open_folder(directory)
Comment exporter un DataFrame vers un fichier Excel avec R
L'exportation vers Excel est simple sur Windows et un peu plus délicat sur macOSLes deux utilisent la bibliothèque xlsx, et la différence réside uniquement dans l'installation, car xlsx dépend de Java. Java doit être présent sur la machine avant que le paquet ne soit chargé.
Windows des opportunités
On WindowsInstallez la bibliothèque directement avec conda :
conda install -c r r-xlsx
Une fois la bibliothèque installée, write.xlsx() crée un nouveau classeur Excel dans le répertoire de travail :
library(xlsx)
write.xlsx(df, "table_car.xlsx")
Si vous êtes un utilisateur Mac OS, vous devez suivre ces étapes :
- Étape 1 : Installez la dernière version de Java
- Étape 2 : Installer la bibliothèque rJava
- Étape 3 : Installer la bibliothèque xlsx
Étape 1) Vous pourriez télécharger Java de l'officiel Oracle site et installez-le.
Vous pouvez revenir à Rstudio et vérifier quelle version de Java est installé.
system("java -version")
Des récents Java La version finale fonctionne. Si la commande ne renvoie aucun résultat, Java n'est pas installé et le package xlsx ne pourra pas être chargé.
Étape 2) Vous devez installer rjava dans R. Nous vous recommandons d'installer R et Rstudio avec Anaconda. Anaconda gère les dépendances entre les bibliothèques. En ce sens, Anaconda gérera les subtilités de rJava installation.
Tout d'abord, vous devez mettre à jour conda, puis installer le bibliothèque math. Vous pouvez copier et coller les deux lignes de code suivantes dans le terminal.
conda update conda
conda install -c r r-rjava
Ensuite, ouvrez rjava dans Rstudio
library(rJava)
Étape 3) Enfin, il est temps d'installer xlsx. Encore une fois, vous pouvez utiliser compter pour le faire:
conda install -c r r-xlsx
Tout comme les utilisateurs de Windows, vous pouvez sauvegarder des données avec la fonction write.xlsx()
library(xlsx)
Sortie :
## Loading required package: xlsxjars
write.xlsx(df, "table_car.xlsx")
Exportation de données de R vers différents logiciels
Exporter des données vers différents logiciels est aussi simple que de les importer. La bibliothèque «haven» offre un moyen pratique d'exporter des données vers
- spss
- sas
- stata
Tout d'abord, importez la bibliothèque. Si vous n'avez pas de « refuge », vous pouvez y aller ici pour l'installer.
library(haven)
Fichier SPSS
Vous trouverez ci-dessous le code pour exporter les données vers le logiciel SPSS :
write_sav(df, "table_car.sav")
fichier SAS
Aussi simple que spss, vous pouvez exporter vers sas
write_sas(df, "table_car.sas7bdat")
fichier STATA
Enfin, la bibliothèque Haven permet d'écrire un fichier .dta.
write_dta(df, "table_car.dta")
Comment exporter des données vers des formats natifs R
Si vous souhaitez conserver l'objet dans R plutôt que de le transmettre à un autre programme, utilisez l'un des deux formats natifs. La fonction `save()` écrit un ou plusieurs objets nommés dans un fichier `.RData`.
save(df, file ='table_car.RData')
L'alternative est saveRDS(), qui stocke exactement un objet et permet au lecteur de choisir son nom lors de son retour :
# One object, name chosen at read time
saveRDS(df, file = "table_car.rds")
my_data <- readRDS("table_car.rds")

# Several objects, original names restored
save(df, directory, file = "workspace.RData")
load("workspace.RData")
| Critères | saveRDS() / readRDS() | enregistrer() / charger() |
|---|---|---|
| Objets par fichier | Exactement un | Un ou plusieurs |
| Nom de l'objet lors du rechargement | C'est vous qui le choisissez | Restauré tel que sauvegardé |
| Écrase l'environnement | Non | Oui, en silence |
| Extension habituelle | .rds | .RData |
Dans les scripts, privilégiez la fonction `saveRDS()`, car `load()` peut écraser silencieusement un objet existant portant le même nom. Les deux formats préservent les niveaux de facteurs, leur ordre et leurs attributs, contrairement au format CSV.
Vous pouvez vérifier les fichiers créés ci-dessus dans le répertoire de travail actuel

Interagissez avec les services cloud
, Last but not least R est équipé de bibliothèques fantastiques pour interagir avec les services de cloud computing. La dernière partie de ce tutoriel traite de l'export/import de fichiers depuis :
- Google Drive
- Dropbox
NoteCette partie du tutoriel suppose que vous possédez un compte auprès de Google et Dropbox. Sinon, vous pouvez rapidement en créer un pour – Google Drive: https://accounts.google.com/SignUp?hl=en - Dropbox: https://www.dropbox.com/h
Google Drive
Vous devez installer la bibliothèque googledrive pour accéder à la fonction permettant d'interagir avec Google Drive.
La bibliothèque n'est pas encore disponible chez Anaconda. Vous pouvez l'installer avec le code ci-dessous dans la console.
install.packages("googledrive")
et vous ouvrez la bibliothèque.
library(googledrive)
Pour les utilisateurs qui n'utilisent pas conda, installer une bibliothèque est simple : il suffit d'utiliser `install.packages('NOM DU PACKAGE')` en plaçant le nom du package entre guillemets et parenthèses. R l'installera dans le premier répertoire renvoyé par `.libPaths()`.
Transférer vers Google Drive
Pour télécharger un fichier sur Google Pour utiliser le lecteur, vous devez utiliser la fonction drive_upload().
Chaque fois que vous redémarrez Rstudio, vous serez invité à autoriser l'accès à Tidyverse. Google Drive.
La syntaxe de base de drive_upload() est
drive_upload(file, path = NULL, name = NULL)
arguments:
- file: Full name of the file to upload (i.e., including the extension)
- path: Location of the file- name: You can rename it as you wish. By default, it is the local name.
Après avoir lancé le code, vous devez confirmer plusieurs questions
drive_upload("table_car.csv", name = "table_car")
Sortie :
## Local file:
## * table_car.csv
## uploaded into Drive file:
## * table_car: 1hwb57eT-9qSgDHt9CrVt5Ht7RHogQaMk
## with MIME type:
## * text/csv
Vous tapez 1 dans la console pour confirmer l'accès
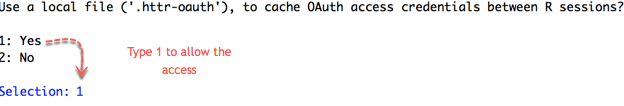
Vous êtes ensuite redirigé vers Google Autoriser l'accès via l'API. Cliquez sur Autoriser.

Une fois l'authentification terminée, vous pouvez quitter votre navigateur.

Dans la console de RStudio, vous pouvez voir le résumé de l'étape effectuée. Google Le fichier situé localement sur le Drive a été téléchargé avec succès. Google Un identifiant a été attribué à chaque fichier du disque.

Vous pouvez voir ce fichier dans Google Spreadsheet.
drive_browse("table_car")
Sortie :
Vous serez redirigé vers Google Spreadsheet

Importer de Google Drive
Le téléchargement par identifiant de fichier est la méthode la plus fiable. Si vous connaissez le nom du fichier, commencez par récupérer son identifiant :
Note: En fonction de votre connexion Internet et de la taille de votre Drive, cela prend du temps.
x <-drive_get("table_car")
as_id(x)

Vous avez stocké l'ID dans la variable x. La fonction drive_download() permet de télécharger un fichier depuis Google Drive.
La syntaxe de base est:
drive_download(file, path = NULL, overwrite = FALSE)
arguments:
- file:  Name or id of the file to download
-path: Location to download the file. By default, it is downloaded to the working directory and the name as in Google Drive
-overwrite = FALSE: If the file already exists, don't overwrite it. If set to TRUE, the old file is erased and replaced by the new one.
Vous pouvez enfin télécharger le fichier :
download_google <- drive_download(as_id(x), overwrite = TRUE)
Code Explication
- drive_download() : Fonction pour télécharger un fichier depuis Google Drive
- as_id(x) : utilisez l'ID pour parcourir le fichier dans Google Drive
- overwrite = TRUE : Si le fichier existe, écrasez-le, sinon l'exécution est interrompue. Pour voir le nom du fichier localement, vous pouvez utiliser :
Sortie :

Le fichier est enregistré dans votre répertoire de travail. N'oubliez pas d'ajouter l'extension avant de l'ouvrir dans R. Vous pouvez créer le nom complet avec la fonction `paste()` (par exemple : `table_car.csv`).
google_file <-download_google$local_path
google_file
path <-paste(google_file, ".csv", sep = "")
google_table_car <-read.csv(path)
google_table_car
Sortie :
##   X gear mean_mpg mean_disp
## 1 1    3 16.10667  326.3000
## 2 2    4 24.53333  123.0167
## 3 3    5 21.38000  202.4800
Enfin, vous pouvez supprimer le fichier de votre Google conduire.
## remove file
drive_find("table_car") %>%drive_rm()
Sortie :

La suppression est traitée de manière asynchrone par GoogleLe fichier peut donc mettre un certain temps à disparaître.
Exporter vers Dropbox
R interagit avec Dropbox via la bibliothèque rdrop2. La bibliothèque n'est pas non plus disponible chez Anaconda. Vous pouvez l'installer via la console
install.packages('rdrop2')
library(rdrop2)
Vous accordez un accès temporaire à Dropbox avec vos identifiants. Une fois authentifié, R peut créer, supprimer, téléverser et télécharger des fichiers dans votre espace de stockage. Dropbox.
Tout d'abord, vous devez donner accès à votre compte. Les informations d'identification sont mises en cache pendant toute la session.
drop_auth()
Vous serez redirigé vers Dropbox pour confirmer l'authentification.

Vous obtiendrez une page de confirmation. Vous pouvez le fermer et revenir à R

Vous pouvez créer un dossier avec la fonction drop_create().
- drop_create('my_first_drop') : crée un dossier dans la première branche de Dropbox
- drop_create('First_branch/my_first_drop') : crée un dossier dans le dossier First_branch existant.
drop_create('my_first_drop')
Sortie :

En chuteBox

Pour télécharger le fichier .csv dans votre Dropbox, utilisez la fonction drop_upload().
Syntaxe de base :
drop_upload(file, path = NULL, mode = "overwrite")
arguments:
- file: local path
- path: Path on Dropbox
- mode = "overwrite":  By default, overwrite an existing file. If set to `add`, the upload is not completed.
drop_upload('table_car.csv', path = "my_first_drop")
Sortie :

À la chuteBox

Vous pouvez lire le fichier csv à partir de Dropbox avec la fonction drop_read_csv()
dropbox_table_car <-drop_read_csv("my_first_drop/table_car.csv")
dropbox_table_car
Sortie :
##   X gear mean_mpg mean_disp
## 1 1    3 16.10667  326.3000
## 2 2    4 24.53333  123.0167
## 3 3    5 21.38000  202.4800
Lorsque vous avez fini d'utiliser le fichier et que vous souhaitez le supprimer. Vous devez écrire le chemin du fichier dans la fonction drop_delete()
drop_delete('my_first_drop/table_car.csv')
Sortie :

Il est également possible de supprimer un dossier
drop_delete('my_first_drop')
Sortie :

Exportation de données depuis R : Référence des fonctions
Vous trouverez ci-dessous la liste de toutes les fonctions d'exportation utilisées dans ce tutoriel :
| Bibliothèque | Objectif | Fonction |
|---|---|---|
| base | Exporter csv | écrire.csv() |
| XLSX | Exporter Excel | écrire.xlsx() |
| havre | Exporter spss | écrire_sav() |
| havre | Exporter SAS | écrire_sas() |
| havre | Exporter les données | écrire_dta() |
| base | Exporter des objets R | enregistrer() / enregistrerRDS() |
| Google Drive | Télécharger une présentation Google Drive | lecteur_upload() |
| Google Drive | Ouvrir dans Google Drive | lecteur_browse() |
| Google Drive | Récupérer l'ID du fichier | drive_get(as_id()) |
| Google Drive | Télécharger à partir de Google Drive | télécharger_drive() |
| Google Drive | Supprimer le fichier de Google Drive | lecteur_rm() |
| rdrop2 | Authentification | drop_auth() |
| rdrop2 | Créer un dossier | drop_create() |
| rdrop2 | Transférer vers Dropbox | drop_upload() |
| rdrop2 | Lire le fichier CSV à partir de Dropbox | supprimer_lire_csv() |
| rdrop2 | Supprimer le fichier de Dropbox | drop_delete() |
