
Núcleo gaussiano en aprendizaje automático: Python Métodos de kernel
 Equipo editorial
⚡ Resumen inteligente
Los métodos de núcleo gaussiano hacen que los datos no separables sean linealmente separables sin necesidad de construir el mapa de características de alta dimensión. Este tutorial muestra el mapa polinomial.ping Primero, lo hace manualmente y luego entrena un clasificador de núcleo de Fourier aleatorio en TensorFlow.
El propósito de este tutorial es hacer que un conjunto de datos sea linealmente separable. El tutorial se divide en dos partes:
- Transformación de características
- Entrena un clasificador de kernel con TensorFlow.
En la primera parte, comprenderá la idea detrás de un método Kernel en Machine Learning, mientras que en la segunda parte verá cómo entrenar un clasificador kernel con TensorFlowUtilizarás el conjunto de datos de adultos. El objetivo de este conjunto de datos es clasificar los ingresos por debajo y por encima de 50, conociendo el comportamiento de cada hogar.
¿Por qué necesitas métodos Kernel?
El objetivo de todo clasificador es predecir correctamente las clases. Para ello, el conjunto de datos debe ser separable. Observe el gráfico a continuación: es bastante sencillo ver que todos los puntos por encima de la línea negra pertenecen a la primera clase y los demás a la segunda. Sin embargo, es extremadamente raro tener un conjunto de datos tan simple. En la mayoría de los casos, los datos no son separables, y los datos no separables dificultan el trabajo de clasificadores ingenuos como la regresión logística.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

En la siguiente figura, representamos un conjunto de datos que no es linealmente separable. Si trazamos una línea recta, la mayoría de los puntos no se clasificarán en la clase correcta.
Una forma de abordar este problema es tomar el conjunto de datos y transformarlo en otro mapa de características. Esto significa que se utilizará una función para trasladar los datos a otro plano, uno que debería ser linealmente separable.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
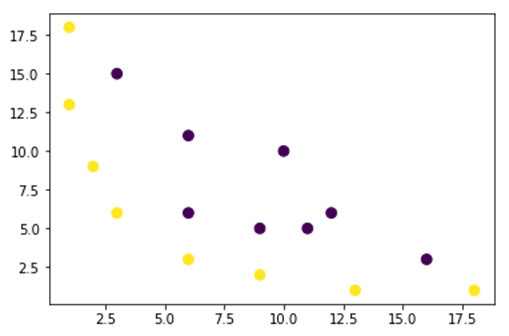
Los datos de la figura anterior se encuentran en un plano bidimensional y no son separables. Puedes intentar transformar estos datos a tres dimensiones, lo que significa crear una figura con tres ejes.
En nuestro ejemplo del núcleo gaussiano, aplicaremos una función polinómica.ping para llevar nuestros datos a una tercera dimensión. La fórmula para transformar los datos es la siguiente.

Usted define una función en el kernel gaussiano Python para crear los nuevos mapas de características.
Puedes usar NumPy para codificar la fórmula anterior. Cada fila a continuación empareja un término del mapa.ping con la expresión de matriz que la produce, y la imagen pequeña marca la raíz cuadrada de dos factores.
| Fórmula | Código NumPy equivalente |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
el nuevo mapaping Tiene 3 dimensiones y 16 puntos.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Ahora crea un nuevo gráfico con 3 ejes, x, y y z respectivamente.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Observamos una mejora, pero si cambiamos la orientación del gráfico, queda claro que el conjunto de datos ahora es separable.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Si necesitas manipular un conjunto de datos grande y crear más de dos dimensiones, el método anterior te presentará un gran problema. De hecho, tendrás que transformar todos los puntos de datos, lo cual es claramente insostenible. Te llevará muchísimo tiempo y tu ordenador podría quedarse sin memoria.
La forma más común de superar este problema es utilizando un kernel.
¿Qué es un Kernel en el aprendizaje automático?
La idea es utilizar un espacio de características de mayor dimensión para que los datos sean casi linealmente separables, como se muestra en la figura anterior.
Hay muchos espacios de dimensiones superiores que hacen que los puntos de datos sean separables. Por ejemplo, hemos demostrado que el mapa polinomialping Es un gran comienzo.
También hemos demostrado que, con grandes cantidades de datos, estas transformaciones no son eficientes. En su lugar, se puede utilizar una función Kernel en aprendizaje automático para modificar los datos sin necesidad de pasar a un nuevo plano de características.
La magia del núcleo reside en encontrar una función que evite todas las dificultades que implica el cálculo en alta dimensión. El resultado de un núcleo es un escalar, o dicho de otro modo, volvemos al espacio unidimensional.
Una vez que haya encontrado esta función, puede insertarla en el clasificador lineal estándar.
Aquí hay un ejemplo que concreta el concepto de aprendizaje automático de kernel. Tienes dos vectores, x1 y x2. El objetivo es crear una dimensión superior utilizando un mapeo polinomial.pingEl resultado es igual al producto escalar del nuevo mapa de características. A partir del método anterior, necesitas:
- Transforma x1 y x2 en una nueva dimensión
- Calcule el producto escalar: común a todos los núcleos
Transforma x1 y x2 en una nueva dimensión
Puede utilizar la función creada anteriormente para calcular la dimensión superior.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Resultado
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Calcular el producto escalar
Puedes usar el punto del objeto desde NumPy para calcular el producto escalar entre el primer y el segundo vector almacenado en x_1.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
El resultado es 8100. El problema radica en que se necesita almacenar un nuevo mapa de características en memoria para calcular el producto escalar. Si se dispone de un conjunto de datos con millones de registros, esto resulta computacionalmente ineficiente.
En cambio, puedes usar el núcleo polinómico para calcular el producto escalar sin transformar el vector. Esta función calcula el producto escalar de x1 y x2 como si estos dos vectores se hubieran transformado a una dimensión superior. Dicho de otro modo, una función de núcleo calcula el resultado del producto escalar desde otro espacio de características.
Puedes escribir la función kernel polinomial en Python como sigue.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Es la potencia del producto escalar de dos vectores. A continuación, devuelve el segundo grado del núcleo del polinomio. El resultado es igual al otro método. Ésta es la magia del núcleo.
polynomial_kernel(x1, x2, p=2)
8100
Tipos de métodos del kernel
Existen muchas técnicas de kernel diferentes. La más sencilla es el kernel lineal. Esta función funciona bastante bien para la clasificación de texto. Los otros kernels son:
- Núcleo polinomial
- Kernel gaussiano
La tabla que aparece a continuación resume la función de cada una y cuándo las utilizan los profesionales.
| Núcleo | Lo que calcula | Uso típico |
|---|---|---|
| Lineal | El producto escalar simple en el espacio de características original | Datos ya separables y características de texto de alta dimensión. |
| Polinomio | El producto escalar elevado a un grado p, que captura las interacciones de las características. | Límites curvos cuando se sabe que las interacciones importan. |
| Gaussiana (RBF) | Una similitud basada en la distancia que tiende a cero a medida que los puntos se separan. | La primera opción habitual cuando se desconoce la forma del límite. |
En el ejemplo con TensorFlow, utilizaremos características de Fourier aleatorias. TensorFlow cuenta con un estimador integrado para calcular el nuevo espacio de características. El mapeador de características de Fourier aleatorias es una aproximación de la función de núcleo gaussiano que se muestra a continuación.

La función de filtrado gaussiano calcula la similitud entre los puntos de datos en un espacio de dimensiones mucho más altas.
Una vez establecida la teoría, el resto de este tutorial pone en práctica un núcleo gaussiano con un conjunto de datos reales.
Entrene el clasificador de kernel gaussiano con TensorFlow
El objetivo del algoritmo es clasificar los hogares que ganan más o menos de 50k.
Primero evaluarás una regresión logística para tener un modelo de referencia. Después, entrenarás un clasificador Kernel para ver si puedes obtener mejores resultados.
Utilice las siguientes variables del conjunto de datos de adultos:
- edad
- clase de trabajo
- fnlwgt
- educación
- núm_educación
- marital
- Ocupación.
- relación
- raza
- vie
- ganancia capital
- perdida de capital
- horas_semana
- patria
- Etiqueta
Antes de entrenar y evaluar el modelo, deberá proceder de la siguiente manera:
- Importar las bibliotecas
- Importar los datos
- Prepara los datos
- Construir el modelo logístico: modelo de referencia
- Evaluar el modelo
- Construir y evaluar el clasificador Kernel.
Nota de versión: Todos los fragmentos de código que aparecen a continuación están dirigidos a TensorFlow 1.x. El espacio de nombres tf.contrib, que proporciona real_valued_column, RandomFourierFeatureMapper y KernelLinearClassifier, se eliminó en TensorFlow 2.0, y tf.estimator se eliminó en TensorFlow 2.16. En una versión actual, compile la misma canalización con la capa tf.keras.layers.experimental.RandomFourierFeatures seguida de una capa de salida Dense, o con el par RBFSampler y SGDClassifier de scikit-learn.
Paso 1) Importar las bibliotecas
Para importar y entrenar modelos Kernel en Inteligencia Artificial, necesitas importar TensorFlow, Los pandas y NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Paso 2) Importar los datos
Usted descarga los datos del Página del conjunto de datos para adultos de la UCI e importarlo como un DataFrame de pandas.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Ahora que los conjuntos de entrenamiento y prueba están definidos, puede cambiar la etiqueta de la columna de cadena de texto a número entero. TensorFlow no acepta valores de cadena de texto para la etiqueta.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Paso 3) Prepare los datos
El conjunto de datos contiene características tanto continuas como categóricas. Una buena práctica es estandarizar los valores de las variables continuas. Puede utilizar la función StandardScaler de scikit-aprenderTambién debes crear una función definida por el usuario para facilitar la conversión de los conjuntos de entrenamiento y prueba. Ten en cuenta que debes concatenar las variables continuas y categóricas en un conjunto de datos común, y que el array debe ser de tipo float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
La función transformadora está lista, por lo que puede convertir el conjunto de datos y crear la función input_fn.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
En el siguiente paso, entrenarás una regresión logística. Le dará una precisión de referencia. El objetivo es superar la línea de base con un algoritmo diferente, concretamente un clasificador Kernel.
Paso 4) Construir el modelo logístico: modelo de referencia
La columna de características se construye con el objeto real_valued_column. Se asegurará de que todas las variables sean datos numéricos densos.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
El estimador se define utilizando la API de TensorFlow Estimator; usted proporciona las columnas de características y dónde guardar el gráfico.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Entrenarás la regresión logística utilizando minilotes de tamaño 200.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Puedes entrenar el modelo con 1,000 iteraciones.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Paso 5) Evaluar el modelo
Usted define la función de entrada de NumPy para evaluar el modelo. Para la evaluación, utiliza todo el conjunto de datos de prueba.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Tienes una precisión del 82 por ciento. En la siguiente sección, intentarás superar al clasificador logístico con un clasificador de kernel.
Paso 6) Construya el clasificador Kernel
El estimador de núcleo no es tan diferente del clasificador lineal tradicional, al menos en términos de construcción. La idea detrás de él es combinar el poder de un mapeo de núcleo explícito.ping con el clasificador lineal.
Necesita dos estimadores predefinidos disponibles en TensorFlow para entrenar el clasificador de kernel:
- AleatorioFourierFeatureMapper
- Clasificador lineal del kernel
En la primera sección aprendiste que necesitas transformar una dimensión baja en una dimensión alta usando una función kernel. Más precisamente, usarás características de Fourier aleatorias, que aproximan la función gaussiana. TensorFlow 1.x proporciona esa función.ping como RandomFourierFeatureMapper, y el modelo se puede entrenar utilizando el estimador KernelLinearClassifier.
Para construir el modelo, seguirás estos pasos:
- Establecer la función Kernel de alta dimensión
- Establecer el hiperparámetro L2
- Construye el modelo
- Entrenar a la modelo
- Evaluar el modelo
Paso A) Establecer la función Kernel de alta dimensión
El conjunto de datos actual contiene 14 características que transformarás en un nuevo vector de 5,000 dimensiones. Para ello, utilizarás las características aleatorias de Fourier. Si recuerdas la fórmula del núcleo gaussiano, observarás que hay un parámetro de desviación estándar que debes definir. Este parámetro controla la medida de similitud utilizada durante la clasificación: una desviación estándar pequeña hace que el núcleo considere similares solo los puntos muy cercanos, mientras que una grande suaviza el límite de decisión.
Puedes ajustar todos los parámetros en RandomFourierFeatureMapper con:
- entrada_dim = 14
- output_dim = 5000
- desviación estándar = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Debe construir el asignador del kernel utilizando las columnas de características creadas antes: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Paso B) Establecer el hiperparámetro L2
Para evitar el sobreajuste, se penaliza la función de pérdida con el regularizador L2. Se establece el hiperparámetro L2 en 0.1 y la tasa de aprendizaje en 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Paso C) Construir el modelo
El siguiente paso es similar a la clasificación lineal. Se utiliza el estimador integrado KernelLinearClassifier. Es importante añadir el mapeador de kernel definido previamente y cambiar el directorio del modelo.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Las advertencias de obsolescencia que aparecen a continuación son esperables en TensorFlow 1.x, ya que el módulo kernel_methods está construido sobre los estimadores tf.contrib.learn más antiguos.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Paso D) Entrenar el modelo
Ahora que el clasificador Kernel está construido, está listo para entrenarlo. Usted elige iterar el modelo 2,000 veces.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Paso E) Evaluar el modelo
Por último, pero no menos importante, evalúa el rendimiento de su modelo. Deberías poder superar la regresión logística.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
La precisión final es del 84%, aproximadamente 1.6 puntos porcentuales por encima del valor de referencia de la regresión logística (0.83975184 frente a 0.82353663). Existe una compensación entre la mejora de la precisión y el coste computacional. Es necesario considerar si dicha mejora justifica el tiempo que consume el clasificador más complejo y si tiene un impacto significativo en su negocio.
