
PyTorTutorial de transferencia de aprendizaje con ejemplos
 evelyn clarke
⚡ Resumen inteligente
El aprendizaje por transferencia reutiliza una red ya entrenada con un gran conjunto de datos, de modo que se puede resolver una nueva tarea relacionada con muchas menos imágenes etiquetadas y una fracción del tiempo de entrenamiento original.
¿Qué es el aprendizaje por transferencia?
Transferir aprendizaje es una técnica de usar un modelo entrenado para resolver otra tarea relacionada. Es una Aprendizaje automático Método de investigación que almacena el conocimiento adquirido al resolver un problema específico y lo utiliza para resolver otro problema diferente pero relacionado. Esto mejora la eficiencia al reutilizar la información recopilada en la tarea aprendida previamente.
Es común reutilizar los pesos de otro modelo de red neuronal porque entrenar una red desde cero requiere una gran cantidad de datos. Para reducir el tiempo de entrenamiento, se toma una red existente y sus pesos, y se modifica la última capa para resolver el problema específico. La ventaja es que esta última capa se puede entrenar con un conjunto de datos pequeño.
Antes de escribir cualquier PythonTorEn el código ch, ayuda saber a qué familia de aprendizaje por transferencia pertenece tu problema, porque eso decide cuántos datos etiquetados necesitas.
Tipos de aprendizaje por transferencia
La literatura especializada divide la técnica en tres familias. La que te corresponda depende de qué aspecto del problema esté etiquetado, no del marco teórico que utilices.
| Tipo | Dominio de origen | Target dominio | Uso típico |
|---|---|---|---|
| Inductivo | Etiquetado | Etiquetado, pero es una tarea diferente. | Reorientar una red troncal de ImageNet hacia un problema de dos clases tipo Alien vs. Predator. |
| Transductivo | Etiquetado | Sin etiquetar, misma tarea, diferente distribución de datos | Adaptación de dominio, como por ejemplo trasladar a una modelo de fotografías de estudio a fotografías tomadas con el teléfono. |
| Sin supervisión | Sin etiquetar | Sin etiquetar | Clusterreducción de dimensionalidad o etiquetado donde etiquetar cada registro es poco práctico |
El ejemplo que se muestra en este tutorial es el aprendizaje por transferencia inductivo. VGG19 llega con el conocimiento etiquetado de ImageNet y, a continuación, se le aplica un problema de dos clases etiquetado que nunca antes ha visto.
Característica Extracción vs. ajuste fino
Una vez seleccionada una red preentrenada, existen dos maneras de adaptarla. La diferencia radica simplemente en cuántas capas se permite que continúen aprendiendo.
| Aspecto | Característica extracdisrupción | Sintonia FINA |
|---|---|---|
| Capas que entrenan | Solo el clasificador reemplazado | El clasificador más algunos o todos los bloques convolucionales |
| Requiere graduación en la estructura principal | Falso | Cierto para los bloques que se están actualizando |
| Datos necesarios | Pequeñas, a menudo unos pocos cientos de imágenes por clase. | Más grandes, generalmente miles |
| Costo de formación | Mínimo, funciona con una CPU | Cuanto más alto, vale la pena tener una GPU. |
| Precisión típica | Es bueno cuando las imágenes de origen y destino se parecen. | Generalmente es mejor cuando los dos dominios difieren. |
Los pasos a continuación utilizan la función extracEn este caso, todos los parámetros de VGG19 se congelan y solo la nueva capa lineal final aprende. Cambiar a ajuste fino es un pequeño cambio, que consiste en dejar requires_grad establecido en True en los bloques que se desean actualizar y reducir la tasa de aprendizaje para que los pesos prestados no se destruyan.
Cargando conjunto de datos
Antes de comenzar a usar Transfer Learning con PyTorch, necesitas comprender el conjunto de datos que vas a utilizar. En este Transfer Learning PyTorPor ejemplo, clasificarás un Alien y un Predator a partir de casi 700 imágenes. Para esta técnica, realmente no necesitas una gran cantidad de datos para entrenar. Puedes descargar el conjunto de datos desde Kaggle: Alien vs. Predator.
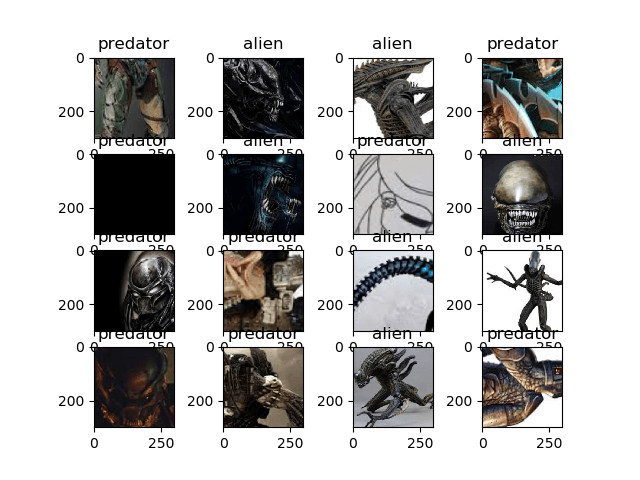
La colección es deliberadamente pequeña, y a continuación se muestra una muestra de las imágenes que contiene.

Fuente: alien vS. depredador Kaggle
A continuación, en este PyTorEn este tutorial sobre aprendizaje por transferencia, aprenderás cómo aplicar el aprendizaje por transferencia con PyTorpaso a paso.
¿Cómo utilizar el aprendizaje por transferencia?
Aquí tienes un proceso paso a paso sobre cómo usar el aprendizaje por transferencia para el aprendizaje profundo con PyTorcanal:
Paso 1) Cargar los datos
El primer paso consiste en cargar los datos y aplicar algunas transformaciones a las imágenes para que se ajusten a los requisitos de la red.
Cargarás los datos desde una carpeta con torchvision.datasets. El módulo itera sobre la carpeta para dividir los datos en conjuntos de entrenamiento y validación. La canalización de transformación utilizada aquí recorta las imágenes del centro, las convierte en un tensor y las normaliza para Aprendizaje profundo.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
Ahora visualizamos el conjunto de datos. El paso de visualización toma el siguiente lote de imágenes y etiquetas del cargador de datos de entrenamiento y las muestra con Matplotlib.
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
Al ejecutar ese fragmento de código, se dibuja una cuadrícula de cuatro por cuatro imágenes de entrenamiento, cada una titulada con el nombre de la clase que devolvió el cargador.
Paso 2) Definir modelo
En este proceso de aprendizaje profundo, utilizarás VGG19 del módulo torchvision.
Utilizarás torchvision.models para cargar vgg19 con los pesos preentrenados habilitados. Después, congelarás las capas para que no sean entrenables. A continuación, modificarás la última capa con una capa lineal que se ajuste al problema, que en este caso es de 2 clases. Se utiliza CrossEntropyLoss como función de pérdida, y el optimizador es SGD con una tasa de aprendizaje de 0.001 y un momento de 0.9, como se muestra en el siguiente código Py.TorEjemplo de aprendizaje por transferencia.
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
Nota de versión: <font dir="auto" style="vertical-align: inherit;">las </font> preentrenado=Verdadero El argumento sigue funcionando, pero ha sido reemplazado desde torchvision 0.13 por el pesos argumento, por lo que las instalaciones más recientes esperan torchvision.models.vgg19(weights=VGG19_Weights.DEFAULT) y, de lo contrario, imprime una advertencia de obsolescencia. Ambos formularios cargan los mismos pesos de ImageNet.
La estructura del modelo de salida.
Al imprimir el modelo, se obtiene el gráfico completo de VGG19. Lea la última línea del bloque del clasificador para confirmar que el cambio funcionó: ahora produce 2 salidas en lugar de las 1,000 clases de ImageNet.
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
Paso 3) Entrenar y probar el modelo
Usaremos algunas de las funciones de este PyTorTutorial para ayudarnos a entrenar y evaluar nuestro modelo.
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
Finalmente, en este aprendizaje por transferencia en PythonTorPor ejemplo, inicie el proceso de entrenamiento con 25 épocas y evalúe la red posteriormente. En cada paso de entrenamiento, el modelo toma la entrada y predice la salida. La predicción se pasa al criterio para calcular la pérdida, la retropropagación calcula los gradientes y el optimizador actualiza los pesos con autograd.
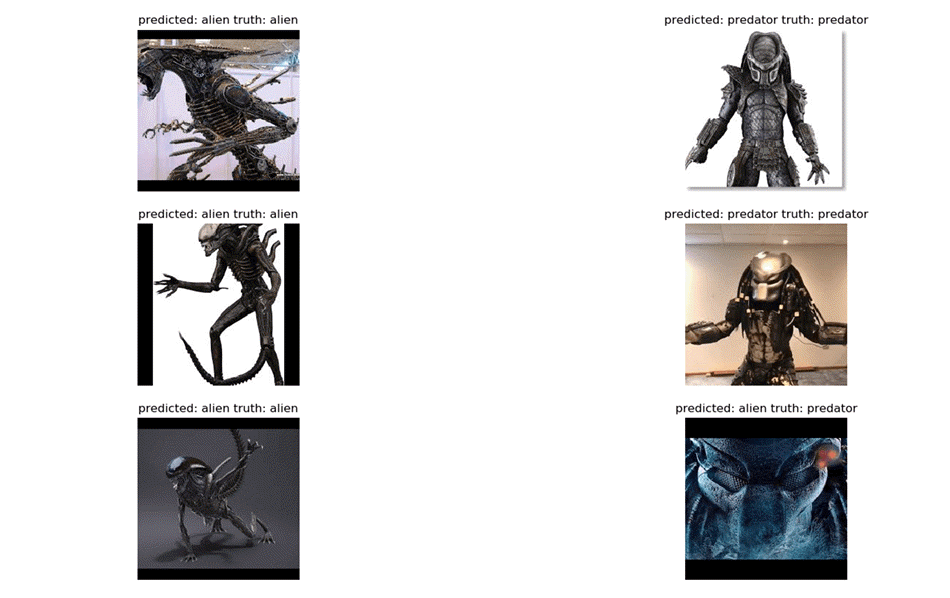
En la función de visualización, la red neuronal entrenada se prueba con un lote de imágenes para predecir las etiquetas, y el resultado se representa gráficamente con Matplotlib.
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
Paso 4) Resultados
La precisión reportada para esta ejecución es del 92%. El registro impreso al final del entrenamiento muestra la pérdida acumulada para las dos últimas épocas junto con el tiempo total de entrenamiento.
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
Las predicciones del modelo se visualizan posteriormente con Matplotlib, como se muestra a continuación.
Errores comunes en el aprendizaje por transferencia y cómo solucionarlos.
La mayoría de los fallos en un script de aprendizaje por transferencia son de índole mecánica, no matemática. Estos son los fallos que impiden la ejecución del código anterior, y explicamos qué significa cada uno.
- Discrepancia de tamaño en la capa final: La capa lineal reemplazada debe aceptar las características de entrada reportadas por el clasificador original y generar exactamente len(class_names) salidas. Imprimir el modelo, como en el paso 2, es la forma más rápida de confirmar ambos valores.
- La columna vertebral nunca estuvo congelada: Si requires_grad se deja en True, todos los parámetros de VGG19 se actualizan y la ejecución se ralentiza considerablemente en una CPU. Cámbielo a False antes de reemplazar el clasificador.
- Desajuste de normalización: La media y la desviación estándar utilizadas en transforms.Normalize deben tener los mismos valores en el momento del entrenamiento y de la inferencia; de lo contrario, las predicciones se desvían sin motivo aparente.
- Argumento de ponderación obsoleto: En torchvision 0.13 y versiones posteriores, pretrained=True genera una advertencia de obsolescencia y se prefiere la enumeración de pesos.
- num_workers en Windows y cuadernos: Un DataLoader con num_workers=4 necesita que el punto de entrada esté protegido, así que establezca num_workers=0 si Python genera un error de spawn o picking.
- Evaluación en modo de entrenamiento: Llama a model.eval() antes de puntuar para que Dropout y BatchNorm se comporten de forma determinista, y vuelve a cambiar con model.train() después.
