
Tutorial de regresión lineal con TensorFlow [Ejemplos]
 Equipo editorial
⚡ Resumen inteligente
La regresión lineal en TensorFlow modela la relación entre características numéricas y un valor objetivo continuo. Este tutorial entrena un predictor de precios de viviendas en Boston de tres maneras distintas, utilizando Pandas, NumPy y las canalizaciones de entrada nativas de TensorFlow con el estimador LinearRegressor.
¿Qué es la regresión lineal?
Regresión lineal La regresión lineal simple es un método estadístico para modelar relaciones entre dos variables. Este modelado se realiza entre una variable de respuesta escalar y una o más variables explicativas. La relación con una sola variable explicativa se denomina regresión lineal simple, y con más de una variable explicativa, regresión lineal múltiple.
TensorFlow proporciona herramientas para tener control total de los cálculos. Esto se hace con la API de bajo nivel. Además de eso, TensorFlow está equipado con una amplia gama de API para realizar muchas aprendizaje automático algoritmos. Esta es la API de alto nivel, y TensorFlow los llama estimadores.
- API de bajo nivel: Construir la arquitectura y la optimización del modelo desde cero. Es complicado para un principiante.
- API de alto nivel: Defina el algoritmo. Es fácil de usar. TensorFlow proporciona una caja de herramientas llamada estimador construir, entrenar, evaluar y hacer una predicción.
En este tutorial, utilizará el solo estimadoresLos cálculos son más rápidos y fáciles de implementar. La primera parte explica cómo usar el optimizador de descenso de gradiente para entrenar una regresión lineal en TensorFlow. En la segunda parte, usarás el conjunto de datos de Boston para predecir el precio de una casa con un estimador de TensorFlow.
Descargar el conjunto de datos de Boston
Cómo entrenar un modelo de regresión lineal
Antes de comenzar a entrenar el modelo, veamos qué es realmente una regresión lineal.
Imagina que tienes dos variables, x e y, y tu tarea es predecir el valor de y conociendo el valor de x. Si representas los datos gráficamente, podrás observar una relación positiva entre tu variable independiente, x, y tu variable dependiente, y, como se muestra en el diagrama de dispersión a continuación.

Podrás observar que si x=1, y será aproximadamente igual a 6, y si x=2, y será alrededor de 8.5.
Este método no es muy preciso y es propenso a errores, especialmente con un conjunto de datos que contiene cientos de miles de puntos.
Una regresión lineal se evalúa con una ecuación. La variable y se explica por una o varias covariables. En su ejemplo, solo hay una variable dependiente. Si tienes que escribir esta ecuación, será:

Con:
 es el sesgo. Es decir, si x=0, y=
 es el peso asociado con x
 es el residuo, o el error del modelo. Incluye lo que el modelo no puede aprender de los datos.
Imagina que ajustas el modelo y encuentras la siguiente solución para:
- = 3.8
- = 2.78
Puedes sustituir esos números en la ecuación y se convierte en:
y= 3.8 + 2.78x
Ahora tienes una mejor manera de encontrar los valores de y. Es decir, puedes reemplazar x con cualquier valor que desees para predecir y. En la imagen a continuación, hemos reemplazado x en la ecuación con todos los valores del conjunto de datos y hemos graficado el resultado.

La línea roja representa el valor ajustado, es decir, los valores de y para cada valor de x. No es necesario conocer el valor de x para predecir y; para cada x existe un valor que corresponde a la línea roja. También se pueden realizar predicciones para valores de x mayores que 2.
Si desea ampliar la regresión lineal a más covariables, puede hacerlo agregando más variables al modelo. La diferencia entre el análisis tradicional y la regresión lineal radica en que esta última examina cómo reacciona la variable y ante cada variable x tomada de forma independiente.
Veamos un ejemplo. Imagina que quieres predecir las ventas de una heladería. El conjunto de datos contiene información diversa, como el clima (lluvioso, soleado, nublado) e información del cliente (salario, género, estado civil).
El análisis tradicional intentará predecir las ventas, por ejemplo, calculando el promedio de cada variable y tratando de estimar las ventas para diferentes escenarios. Esto dará lugar a predicciones deficientes y limitará el análisis al escenario elegido.
Si usas regresión lineal, puedes escribir esta ecuación:
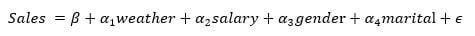
El algoritmo encontrará la mejor solución para los pesos; es decir, intentará minimizar el coste, que es la diferencia entre la línea ajustada y los puntos de datos.
Como funciona el algoritmo
El siguiente diagrama resume el ciclo que repite el algoritmo: seleccionar los pesos, predecir y, medir el error y corregir los pesos.

El algoritmo elegirá un número aleatorio para cada  y
 y reemplace el valor de x para obtener el valor previsto de y. Si el conjunto de datos tiene 100 observaciones, el algoritmo calcula 100 valores predichos.
Podemos calcular el error, observado  , del modelo, que es la diferencia entre el valor predicho y el valor real. Un error positivo significa que el modelo subestima la predicción de y, y un error negativo significa que el modelo sobreestima la predicción de y.

Tu objetivo es minimizar el cuadrado del error. El algoritmo calcula la media del error cuadrático. Este paso se llama minimización del error. Para la regresión lineal, esto es el Error cuadrático medio, también llamado MSE. Matemáticamente es:

Lugar:
 son los pesos, así que
 se refiere al valor predicho
- y son los valores reales
- m es el número de observaciones
 se refiere al valor predicho
Tenga en cuenta que  significa que utiliza la transpuesta de las matrices. El
 es la notación matemática de la media.
El objetivo es encontrar lo mejor.  que minimiza el MSE.
Si el error promedio es grande, significa que el modelo funciona mal y los pesos no se eligen correctamente. Para corregir los pesos, es necesario utilizar un optimizador. El optimizador tradicional se llama Descenso de gradiente.
El descenso de gradiente toma la derivada y disminuye o aumenta el peso. Si la derivada es positiva, el peso disminuye. Si la derivada es negativa, el peso aumenta. El modelo actualizará los pesos y recalculará el error. Este proceso se repite hasta que el error ya no cambie. Cada pasada se llama iteraciónAdemás, los gradientes se multiplican por una tasa de aprendizaje, que indica la velocidad del aprendizaje.
Si la tasa de aprendizaje es demasiado baja, el algoritmo tardará mucho tiempo en converger, ya que requiere muchas más iteraciones. Si la tasa de aprendizaje es demasiado alta, es posible que el algoritmo nunca converja. La curva de pérdida que se muestra a continuación representa el error en función del número de iteraciones para este conjunto de datos.

Como se puede observar en la imagen superior, el modelo repite el proceso unas 20 veces antes de encontrar un valor estable para los pesos, alcanzando así el menor error.
Tenga en cuenta que el error no es cero, sino que se estabiliza en torno a 5. Esto significa que el modelo presenta un error típico de 5. Si desea reducir el error, deberá añadir más información al modelo, como más variables, o utilizar estimadores diferentes.
Recuerdas la primera ecuación:

Los pesos finales son 3.8 y 2.78. El siguiente video muestra cómo el descenso de gradiente optimiza la función de pérdida para encontrar estos pesos.
Cómo entrenar una regresión lineal con TensorFlow
Ahora que comprende mejor lo que sucede detrás del capó, está listo para usar la API del estimador proporcionada por TensorFlow para entrenar su primera regresión lineal usando TensorFlow.
Nota de versión: El flujo de trabajo del estimador que se muestra a continuación se escribió para TensorFlow 1.x y las primeras versiones de 2.x. TensorFlow marcó el tf.estimator y tf.feature_column Las API quedaron totalmente obsoletas en la versión 2.12 y se eliminaron los Estimadores en la versión 2.16. En una instalación actual, ejecute este código dentro de un TensorFlow 1.15 o 2.x-with-tf.compat.v1 entorno, o portarlo a Keras, donde tf.keras.layers.Dense(1) Además, las capas de preprocesamiento reemplazan al LinearRegressor y las columnas de características. Los conceptos —características, etiquetas, lotes, épocas, MSE y descenso de gradiente— se mantienen sin cambios.
Utilizarás el conjunto de datos de Boston, que incluye las siguientes variables.
| Variable | Mareas Ideales para Lecciones |
| criminal | tasa de criminalidad per cápita por ciudad |
| zn | proporción de terreno residencial zonificado para lotes de más de 25,000 pies cuadrados. |
| indus | Proporción de acres de negocios no minoristas por ciudad. |
| nox | concentración de óxidos nítricos |
| rm | número medio de habitaciones por vivienda |
| edad | proporción de unidades ocupadas por sus propietarios construidas antes de 1940 |
| des | distancias ponderadas a cinco centros de empleo de Boston |
| deuda | tasa de impuesto a la propiedad de valor total por dólares 10,000 |
| ptratio | ratio alumnos-maestro por localidad |
| médico | Valor medio de las viviendas ocupadas por sus propietarios en miles de dólares |
Creará tres conjuntos de datos diferentes:
| datos | objetivo | dar forma a |
| Capacitación Especializada | Entrena el modelo y obtén los pesos. | de 400 |
| Evaluación | Evaluar el rendimiento del modelo con datos invisibles. | de 100 |
| Predicción | Utilice el modelo para predecir el valor de la vivienda a partir de nuevos datos | de 6 |
El objetivo es utilizar las características del conjunto de datos para predecir el valor de la vivienda.
Durante la segunda parte del tutorial, aprenderá a utilizar TensorFlow con tres formas diferentes de importar los datos:
- Con pandas
- Con NumPy
- Solo TensorFlow
Tenga en cuenta que las tres opciones proporcionan los mismos resultados.
Aprenderás a usar la API de alto nivel para construir, entrenar y evaluar un modelo de regresión lineal de TensorFlow. Si usaras la API de bajo nivel, tendrías que definir manualmente lo siguiente:
- Función de pérdida
- Optimizador: descenso de gradiente
- Multiplicación de matrices
- Grafico y tensor
Esto resulta tedioso y más complicado para un principiante.
Solución Pandas
Debe importar las bibliotecas necesarias para entrenar el modelo.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Paso 1) Importar los datos con pandas.
Usted define los nombres de las columnas y los almacena en COLUMNS. Puede usar pd.read_csv() para importar los datos.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Dirige cada llamada a los archivos CSV que descargaste anteriormente.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Puede imprimir la forma de los datos.
print(training_set.shape, test_set.shape, prediction_set.shape)
Resultado
(400, 10) (100, 10) (6, 10)
Tenga en cuenta que la etiqueta, es decir, su variable dependiente (y), está incluida en el conjunto de datos. Por lo tanto, debe definir otras dos listas: una que contenga solo las características y otra con el nombre de la etiqueta. Estas dos listas le indicarán a su estimador cuáles son las características del conjunto de datos y qué nombre de columna corresponde a la etiqueta.
Se hace con el siguiente código.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Paso 2) Convertir los datos
Necesitas convertir las variables numéricas al formato adecuado. TensorFlow proporciona un método para convertir una variable continua: tf.feature_column.numeric_column().
En el paso anterior, definiste una lista de características que deseas incluir en el modelo. Ahora puedes usar esta lista para convertirlas en datos numéricos. Si deseas excluir características de tu modelo, puedes eliminar una o más variables de la lista FEATURES antes de construir feature_cols.
Tenga en cuenta que utilizará un Python Utiliza una comprensión de listas con la lista FEATURES para crear una nueva lista llamada feature_cols. Esto te ayuda a evitar escribir tf.feature_column.numeric_column() nueve veces. Una comprensión de listas es una forma más rápida y limpia de crear nuevas listas.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Paso 3) Definir el estimador
En este paso, debe definir el estimador. TensorFlow proporciona seis estimadores predefinidos, tres para tareas de clasificación y tres para tareas de regresión de TensorFlow:
- Regresor
- DNNRegresor
- Regresor lineal
- DNNLinearCombinedRegressor
- clasificar
- Clasificador DNN
- Clasificador lineal
- Clasificador combinado lineal DNN
En este tutorial, utilizará el regresor lineal. Para acceder a esta función, necesita utilizar tf.estimator.
La función necesita dos argumentos:
- feature_columns: contiene las variables que se incluirán en el modelo.
- model_dir: ruta para almacenar el gráfico, guardar los parámetros del modelo, etc.
TensorFlow creará automáticamente una carpeta llamada train en su directorio de trabajo. Debe usar esta ruta para acceder a ella. TensorTablero, como se muestra en el ejemplo de regresión de TensorFlow a continuación.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Resultado
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
La parte complicada de TensorFlow es cómo alimentar el modelo. TensorFlow está diseñado para trabajar con computación paralela y conjuntos de datos muy grandes. Debido a las limitaciones de los recursos de la máquina, es imposible alimentar el modelo con todos los datos a la vez. Para ello, es necesario alimentarlo por lotes cada vez. Tenga en cuenta que hablamos de conjuntos de datos enormes con millones o más registros. Si no se añaden lotes, se producirá un error de memoria.
Por ejemplo, si sus datos contienen 100 observaciones y define un tamaño de lote de 10, significa que el modelo verá 10 observaciones para cada iteración (10*10).
Cuando el modelo ha procesado todos los datos, finaliza una época. Una época define cuántas veces se procesarán los datos. Es recomendable desactivar este paso y permitir que el modelo realice un número determinado de iteraciones.
Un segundo aspecto a considerar es si se desea barajar los datos antes de cada iteración. Durante el entrenamiento, es importante barajar los datos para que el modelo no aprenda un patrón específico del conjunto de datos. Si el modelo aprende los detalles del patrón subyacente, tendrá dificultades para generalizar la predicción a datos desconocidos. Esto se conoce como sobreajuste. El modelo funciona bien con los datos de entrenamiento, pero no puede predecir correctamente para datos desconocidos.
TensorFlow facilita estos dos pasos. Cuando los datos llegan al pipeline, sabe cuántas observaciones necesita (lote) y si tiene que mezclar los datos.
Para indicarle a TensorFlow cómo alimentar el modelo, puede usar pandas_input_fn. Este objeto necesita cinco parámetros:
- x: datos de características
- y: datos de la etiqueta
- tamaño_lote: lote. Por defecto 128
- num_epoch: número de épocas, por defecto 1
- Mezclar: mezclar los datos o no. Por defecto, Ninguno.
Necesitas alimentar el modelo varias veces, así que defines una función para repetir este proceso. Llama a esta función get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
El método habitual para evaluar el desempeño de un modelo es:
- Entrenar a la modelo
- Evalúe el modelo en un conjunto de datos diferente.
- Haz una predicción
El estimador de TensorFlow proporciona tres funciones diferentes para llevar a cabo estos tres pasos fácilmente.
Paso 4) Entrenar a la modelo
Puedes usar el método de entrenamiento del estimador para ajustar el modelo. El estimador de entrenamiento requiere una función de entrada (input_fn) y un número de pasos. Puedes usar la función que creaste anteriormente para alimentar el modelo. Luego, le indicas al modelo que itere 1000 veces. Ten en cuenta que no especificas el número de épocas; dejas que el modelo itere 1000 veces. Si estableces el número de épocas en 1, el modelo iterará cuatro veces, ya que hay 400 registros en el conjunto de entrenamiento y el tamaño del lote es 128.
- Filas 128
- Filas 128
- Filas 128
- Filas 16
Por lo tanto, es más sencillo establecer el número de épocas en ninguno y definir el número de iteraciones, como se muestra en el ejemplo de clasificación de TensorFlow a continuación.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Resultado
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Puedes comprobar TensorBoard con el siguiente comando:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Paso 5) Evalúa tu modelo
Puede evaluar el ajuste de su modelo en el conjunto de prueba con el siguiente código:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Resultado
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Puede imprimir la pérdida con el siguiente código:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Resultado
Loss: 3215.895996
El modelo tiene una pérdida de 3215. Puedes consultar las estadísticas descriptivas para hacerte una idea de la magnitud del error.
training_set['medv'].describe()
Resultado
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Según la estadística resumida anterior, el precio promedio de una vivienda es de 22 mil, con un precio mínimo de 5 mil y un máximo de 50 mil. Dado que la pérdida reportada es el error cuadrático medio, el error típico en las unidades originales es aproximadamente la raíz cuadrada de 32.16, lo que equivale a unos 5.7 mil dólares.
Paso 6) hacer la predicción
Finalmente, puedes utilizar el método predict del estimador TensorFlow para estimar el valor de seis casas en Boston.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Para imprimir los valores estimados, puede utilizar este código:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Resultado
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
El modelo pronostica los siguientes valores:
| Casa | Predicción |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Tenga en cuenta que desconocemos el valor real de estas seis casas. En el tutorial de aprendizaje profundo, intentará superar el modelo lineal.
Solución NumPy
Esta sección explica cómo entrenar el modelo utilizando un estimador NumPy para alimentar los datos. El método es el mismo, con la única diferencia de que se utilizará el estimador numpy_input_fn.
Lee los mismos tres archivos CSV, pero conserva solo las matrices NumPy sin procesar con .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Paso 1) Importar los datos
En primer lugar, debes diferenciar las variables de características de las etiquetas. Esto se aplica tanto a los datos de entrenamiento como a los de evaluación. Es más rápido definir una función para dividir los datos.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Puedes usar esta función para separar la etiqueta de las características de los conjuntos de datos de entrenamiento y evaluación.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Debes excluir la última columna del conjunto de datos de predicción porque solo contiene valores NaN.
x_predict = prediction_set_n[:, :-2]
Confirma la forma de la matriz. Ten en cuenta que la etiqueta no debe tener una segunda dimensión, lo que significa (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
Resultado
(400, 9) (400,) (6, 9)
Puede construir las columnas de características de la siguiente manera:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
El estimador se define como antes: se especifican las columnas de características y dónde guardar el gráfico.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Resultado
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Puedes usar el estimador NumPy para alimentar el modelo con los datos y luego entrenarlo. Ten en cuenta que definimos la función input_fn de antemano para facilitar la lectura.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Resultado
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Para evaluar tu modelo, repites el mismo paso con una función de entrada diferente.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Resultado
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Finalmente, puedes calcular la predicción. Debería ser similar al resultado de Pandas.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Resultado
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
Solución de TensorFlow
La última sección está dedicada a un puro TensorFlow Solución. Este método es un poco más complicado que los otros dos.
Tenga en cuenta que si utiliza un Jupyter cuaderno, necesitas reiniciar y borrar el kernel para ejecutar esta sesión.
TensorFlow ha creado una excelente herramienta para pasar los datos a la canalización. En esta sección, usted mismo creará la función input_fn.
Paso 1) Definir la ruta y el formato de los datos.
En primer lugar, debes declarar dos variables con la ruta de los archivos CSV. Ten en cuenta que tienes dos archivos: uno para el conjunto de entrenamiento y otro para el conjunto de prueba.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
A continuación, debes definir las columnas que deseas utilizar del archivo CSV. Usaremos todas. Después, debes declarar el tipo de cada variable.
Las variables de punto flotante se definen mediante [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Paso 2) Definir la función input_fn
La función se puede dividir en tres partes:
- Importar los datos
- Crear el iterador
- Consumir los datos
A continuación se muestra el código completo para definir la función. El código se explicará más adelante.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Importar los datos
Para un archivo CSV, el método dataset lee una línea a la vez. Para construir el conjunto de datos, debe usar el objeto TextLineConjunto de datos. Tu conjunto de datos tiene un encabezado, así que debes usar skip(1) para omitir la primera línea. En este punto, solo lees los datos y excluyes el encabezado en la canalización. Para alimentar el modelo, debes separar las características de la etiqueta. El método utilizado para aplicar cualquier transformación a los datos es map.
Este método llama a una función que usted creará para indicar cómo transformar los datos. En resumen, necesita pasar los datos a la TextLineObjeto de conjunto de datos, excluyendo el encabezado, y aplicando una transformación indicada por una función.
Code explicación
- tf.datos.TextLineDataset(data_file): esta línea lee el archivo CSV.
- .skip(1): omite el encabezado
- .map(parse_csv)): analiza los registros y los convierte en tensores.
Necesitas definir una función para dar instrucciones al objeto mapa. Puedes llamar a esta función parse_csv.
Esta función analiza el archivo CSV con el método tf.decode_csv y declara las características y la etiqueta. Las características se pueden declarar como un diccionario o una tupla. Se utiliza el método del diccionario por su mayor comodidad.
Code explicación
- tf.decode_csv(value, record_defaults= RECORDS_ALL): el método decode_csv utiliza la salida del TextLineConjunto de datos para leer el archivo CSV. record_defaults le indica a TensorFlow los tipos de columna. En TensorFlow 2.x, este símbolo se encuentra en tf.io.decode_csv.
- dict(zip(COLUMNS, columns)): rellena el diccionario con todas las columnas, por ejemplotracted durante este procesamiento de datos
- features.pop('medv'): excluye la variable objetivo de las variables de características y crea una variable de etiqueta.
El conjunto de datos necesita más elementos para alimentar iterativamente los tensores. De hecho, es necesario agregar el método `repeat` para que el conjunto de datos continúe alimentando el modelo indefinidamente. Si no se agrega este método, el modelo iterará solo una vez y luego generará un error porque no se ingresarán más datos al proceso.
Después, puedes controlar el tamaño del lote con el método `batch`. Esto significa que le indicas al conjunto de datos cuántos datos quieres pasar a la canalización en cada iteración. Si estableces un tamaño de lote grande, el modelo será lento.
Paso 3) Crear el iterador
Ahora está listo para el segundo paso: cree un iterador para devolver los elementos del conjunto de datos.
La forma más sencilla de crear un operador es con el método make_one_shot_iterator.
Después de eso, puede crear las funciones y etiquetas desde el iterador.
Paso 4) Consumir los datos
Puedes comprobar qué ocurre con la función input_fn. Necesitas llamar a la función en una sesión para consumir los datos. Prueba con un tamaño de lote igual a 1.
Tenga en cuenta que imprime las características en un diccionario y la etiqueta como una matriz.
Mostrará la primera línea del archivo CSV. Puedes intentar ejecutar este código varias veces con diferentes tamaños de lote.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Resultado
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Paso 5) Definir la columna de características
Debes definir las columnas numéricas de la siguiente manera:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Tenga en cuenta que debe combinar todas las variables en un mismo contenedor.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Paso 6) Construye el modelo
Puedes entrenar el modelo con el estimador LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Resultado
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Necesitas usar un función lambda para permitirte escribir los argumentos para la función input_fn. Si no utilizas una función lambda, no podrás entrenar el modelo.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Resultado
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Puede evaluar el ajuste de su modelo en el conjunto de prueba con el siguiente código:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Resultado
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
El último paso consiste en predecir el valor del objetivo a partir del valor de la matriz de características. Puedes crear un diccionario con los valores que deseas predecir. Tu modelo tiene nueve características, así que debes proporcionar un valor para cada una. El modelo generará una predicción para cada una de ellas.
En el código siguiente, se escriben los valores de cada característica que se encuentra en el archivo CSV df_predict.
Necesitas escribir una nueva función input_fn porque no hay etiquetas en el conjunto de datos. Puedes usar la API from_tensors del objeto Dataset.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Finalmente, imprimes las predicciones.
for pred in enumerate(pred_results):
print(pred)
Resultado
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Los tres métodos arrojan las mismas seis predicciones, lo que confirma que la elección entre Pandas, NumPy y un conjunto de datos nativo de TensorFlow es una cuestión de conveniencia, no de precisión.
