
Tutorial de redes neuronales artificiales (RNA) con TensorFlow
 Equipo editorial
⚡ Resumen inteligente
Las redes neuronales artificiales aprenden procesando la información de entrada a través de capas conectadas, evaluando el resultado con una función de pérdida y ajustando los pesos con un optimizador. Este tutorial muestra cómo construir una red neuronal artificial en TensorFlow y clasificar dígitos del conjunto de datos MNIST.
¿Qué es la red neuronal artificial?
An Red neuronal artificial (ANN) Es un sistema informático inspirado en las redes neuronales biológicas para crear cerebros artificiales basados en un conjunto de unidades conectadas llamadas neuronas artificiales. Está diseñado para analizar y procesar información como lo hacen los humanos. Una red neuronal artificial tiene capacidad de autoaprendizaje para producir mejores resultados a medida que dispone de más datos.
El diagrama a continuación traces un recorrido completo a través de dicha red, desde la entrada sin procesar hasta el optimizador que corrige los pesos.

Una red neuronal artificial (RNA) se compone de cuatro objetos principales:
- Capas: Todo el aprendizaje se produce en las capas. Hay 3 capas: 1) Entrada, 2) Oculta y 3) Salida.
- Característica y etiqueta: Datos de entrada a la red (características) y salida de la red (etiquetas)
- Función de pérdida: Métrica utilizada para estimar el rendimiento de la fase de aprendizaje.
- Optimizador: Mejora el aprendizaje actualizando el conocimiento en la red.
Una red neuronal toma los datos de entrada y los introduce en un conjunto de capas. A continuación, la red evalúa su rendimiento mediante una función de pérdida. Esta función le indica a la red el camino que debe seguir para dominar el conocimiento. La red perfecciona dicho conocimiento con la ayuda de un optimizador.
Si observa la figura anterior, comprenderá el mecanismo subyacente.
El programa toma algunos valores de entrada y los introduce en dos capas totalmente conectadas. Imagina que tienes un problema de matemáticas. Lo primero que haces es leer el capítulo correspondiente para resolverlo. Luego aplicas tus nuevos conocimientos al problema. Hay muchas probabilidades de que no obtengas una buena puntuación. Lo mismo ocurre con una red neuronal: la primera vez que ve los datos y hace una predicción, el resultado no coincidirá perfectamente con los datos reales.
Para mejorar su conocimiento, la red neuronal utiliza un optimizador. En esta analogía, el optimizador se asemeja a releer un capítulo: al releerlo, se obtienen nuevas perspectivas. De manera similar, la red utiliza el optimizador, actualiza su conocimiento y lo pone a prueba para comprobar cuánto necesita aprender aún. El programa repite este paso hasta minimizar el error.
En la analogía de los problemas matemáticos, esto significa que lees el capítulo del libro de texto muchas veces hasta comprender completamente el contenido del curso. Incluso después de leerlo varias veces, si sigues cometiendo errores, significa que has alcanzado el límite de conocimiento del material actual. Necesitas usar otro libro de texto o probar un método diferente para mejorar tu puntuación. Para una red neuronal, el proceso es el mismo. Si el error deja de disminuir y la curva de pérdida se aplana, la arquitectura actual no puede aprender nada más. La red debe optimizarse para mejorar el conocimiento.
Esos cuatro objetos se corresponden directamente con los componentes que se configuran al diseñar una red.
Red neuronal Architectura
La arquitectura de la red neuronal artificial consta de los siguientes componentes:
- Capas
- Función de activación
- Función de pérdida
- Optimizador
Capas
Una capa es donde se lleva a cabo todo el aprendizaje. Dentro de una capa se encuentra un número arbitrario de neuronas, cada una con sus propios pesos. Una red neuronal típica suele procesarse mediante capas densamente conectadas (también llamadas capas totalmente conectadas). Esto significa que todas las entradas están conectadas a la salida.
Una red neuronal típica recibe un vector de entrada y un escalar que contiene las etiquetas. La configuración más sencilla es una clasificación binaria con solo dos clases: 0 y 1.
La red recibe una entrada, la envía a todos los nodos conectados y calcula la señal mediante una función de activación. El diagrama numerado que aparece a continuación muestra un nodo individual ampliado para que se puedan observar por separado la suma ponderada y el paso de activación.

La figura anterior ilustra esta idea. La primera capa almacena los valores de entrada. La segunda capa, denominada capa oculta, recibe la entrada ponderada de la capa anterior.
- El primer nodo son los valores de entrada.
- La neurona se descompone en una parte de entrada y una función de activación. La parte izquierda recibe toda la entrada de la capa anterior. La parte derecha es la suma de la entrada que pasa a la función de activación.
- Valor de salida calculado a partir de las capas ocultas y utilizado para realizar una predicción. En el caso de la clasificación, es igual al número de clases. En el caso de la regresión, se predice un único valor.
Función de activación
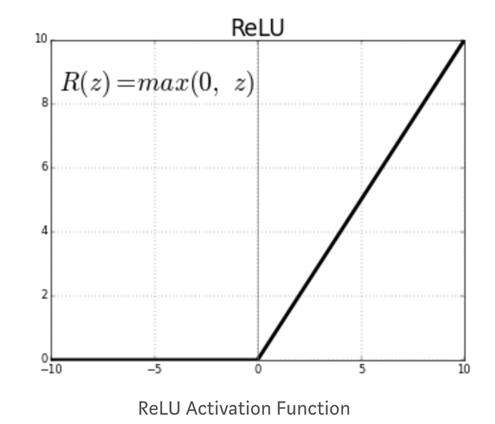
La función de activación de un nodo define la salida a partir de un conjunto de entradas. Se necesita una función de activación para que la red aprenda patrones no lineales. Una función de activación común es ReLU (Unidad Lineal Rectificada). Esta función devuelve cero para todos los valores negativos.
Las otras funciones de activación son:
- Lineal por partes
- Sigmoideo
- tanh
- ReLU con fugas
El gráfico que aparece a continuación muestra por qué se describe la función ReLU de esa manera: la curva es plana en cero para cada entrada negativa y luego aumenta linealmente.
La decisión crítica que se debe tomar al construir una red neuronal es:
- ¿Cuántas capas en la red neuronal?
- ¿Cuántas unidades ocultas para cada capa?
Las redes neuronales con muchas capas y unidades ocultas pueden aprender una representación compleja de los datos, pero hacen que el cálculo de la red sea muy costoso.
Función de pérdida
Una vez que haya definido las capas ocultas y la función de activación, debe especificar la función de pérdida y el optimizador.
Para la clasificación binaria, es práctica común utilizar una función de pérdida de entropía cruzada binaria. regresión lineal, se utiliza el error cuadrático medio.
La función de pérdida es una métrica importante para estimar el rendimiento del optimizador. Durante el entrenamiento, esta métrica se minimizará. Debe seleccionar esta cantidad con cuidado según el tipo de problema que esté enfrentando.
Optimizador
La función de pérdida mide el rendimiento del modelo. El optimizador ayuda a mejorar los pesos de la red para reducir la pérdida. Existen diferentes optimizadores, pero el más común es el descenso de gradiente estocástico.
Los optimizadores convencionales son:
- Momentum optimización
- Gradiente acelerado de Nesterov
- adagrad
- optimización de adán
ArchiLa arquitectura por sí sola no garantiza un modelo utilizable.
Limitaciones de la red neuronal
A continuación se detallan las limitaciones de una red neuronal:
Sobreajuste
Un problema común en las redes neuronales complejas es la dificultad para generalizar a datos desconocidos. Una red neuronal con muchos pesos puede identificar detalles específicos en el conjunto de entrenamiento con gran precisión, pero esto suele provocar sobreajuste. Si los datos están desequilibrados dentro de los grupos (es decir, si no hay suficientes datos disponibles en algunos grupos), la red aprenderá muy bien durante el entrenamiento, pero no tendrá la capacidad de generalizar dichos patrones a datos nunca antes vistos.
Hay una compensación en aprendizaje automático entre optimización y generalización.
- Optimizar un modelo requiere encontrar los mejores parámetros que minimicen la pérdida del conjunto de entrenamiento.
- La generalización, sin embargo, indica cómo se comporta el modelo ante datos invisibles.
Para evitar que el modelo capture detalles específicos o patrones no deseados de los datos de entrenamiento, se pueden utilizar diferentes técnicas. El mejor método consiste en contar con un conjunto de datos equilibrado y con una cantidad suficiente de datos. El arte de reducir el sobreajuste se denomina regularización. Las tres técnicas que se describen a continuación son los puntos de partida convencionales.
| Tecnologia | Lo que limita | Configuración típica en este tutorial |
|---|---|---|
| Tamaño de la red | El número de capas y unidades ocultas | Dos capas ocultas, de 300 y 100 unidades. |
| Regularización de peso L1/L2 | La magnitud de los coeficientes de ponderación | l1_regularization_strength y l2_regularization_strength de 0.01 |
| Punteras | Porcentaje de unidades desactivadas por etapa de entrenamiento | abandono de 0.3 |
Tamaño de la red
Se sabe que una red neuronal con demasiadas capas y unidades ocultas es muy sofisticada. Una forma sencilla de reducir la complejidad del modelo es disminuir su tamaño. No existe una única práctica óptima para definir el número de capas. Es necesario comenzar con un número reducido de capas e ir aumentando el tamaño hasta que el modelo se sobreajuste.
Regularización de peso
Una técnica estándar para prevenir el sobreajuste consiste en añadir restricciones a los pesos de la red. La restricción obliga a que los pesos de la red tomen solo valores pequeños. La restricción se añade a la función de pérdida del error. Existen dos tipos de regularización:
- L1 (Lazo): El coste es proporcional al valor absoluto de los coeficientes de ponderación.
- L2 (Cresta): El coste es proporcional al cuadrado del valor de los coeficientes de ponderación.
Punteras
Dropout es una técnica peculiar pero útil. Una red neuronal con dropout implica que algunas unidades se desactivan aleatoriamente durante el entrenamiento, de modo que su señal de salida se anula. Imaginemos un array de pesos [0.1, 1.7, 0.7, -0.9]. Si la red neuronal incorpora dropout, se convertirá en [0.1, 0, 0, -0.9] con ceros distribuidos aleatoriamente. El parámetro que controla el dropout es la tasa de dropout. Esta tasa define cuántas unidades se desactivan. Es común encontrar una tasa entre 0.2 y 0.5.
Un pequeño ejemplo interactivo facilita la visualización del ciclo de entrenamiento.
Ejemplo de red neuronal en TensorFlow
Aquí se muestra un ejemplo de red neuronal artificial en acción, que ilustra cómo funciona una red neuronal en un problema de clasificación típico. Hay dos entradas, x1 y x2, cada una con un valor aleatorio. La salida es una clase binaria. El objetivo es clasificar la etiqueta en función de estas dos características. Para llevar a cabo esta tarea, la arquitectura de la red neuronal se define de la siguiente manera:
- Dos capas ocultas
- La primera capa tiene cuatro neuronas completamente conectadas.
- La segunda capa tiene dos neuronas completamente conectadas.
- La función de activación es ReLU.
- Agregue una regularización L2 con una tasa de aprendizaje de 0.003
La red optimizará los pesos durante 180 épocas con un tamaño de lote de 10. En la animación de ejemplo de la red neuronal artificial que se muestra a continuación, puede ver cómo evolucionan los pesos con el tiempo y cómo la red mejora el mapa de clasificación.ping.

En primer lugar, la red asigna valores aleatorios a todos los pesos.
- Con los pesos aleatorios, es decir, sin optimización, la pérdida de salida es de 0.453. La imagen a continuación representa la red con diferentes colores.
- En general, el color naranja representa los valores negativos mientras que los colores azules muestran los valores positivos.
- Los puntos de datos tienen la misma representación: los azules son las etiquetas positivas y los naranjas las etiquetas negativas.

Dentro de la segunda capa oculta, las líneas están coloreadas según el signo de los pesos. Las líneas naranjas representan pesos negativos y las azules, pesos positivos.
Como puede ver, en el mapa de salidapingLa red está cometiendo bastantes errores. Ahora veamos cómo se comporta la red después de la optimización.
La imagen del ejemplo de red neuronal artificial (RNA) que se muestra a continuación ilustra los resultados de la red optimizada. En primer lugar, se observa que la red ha aprendido correctamente a clasificar los puntos de datos. Comparándola con la imagen anterior, el peso inicial era de -0.43, mientras que tras la optimización se obtiene un peso de -0.95.

La idea se puede generalizar para redes con más capas ocultas y neuronas. Puedes experimentar tú mismo con la configuración en el Zona de juegos TensorFlow.
El siguiente tutorial desarrolla la misma idea mediante código, utilizando un conjunto de datos reales.
Cómo entrenar una red neuronal con TensorFlow
Aquí está el proceso paso a paso sobre cómo entrenar una red neuronal con TensorFlow Red neuronal artificial (RNA) que utiliza el estimador DNNClassifier de la API.
Usaremos el conjunto de datos MNIST para entrenar su primera red neuronal. Entrenando una red neuronal con TensorFlow No es muy complicado. El paso de preprocesamiento es exactamente igual que en los tutoriales anteriores. Procederás de la siguiente manera:
- Importar los datos
- Transforma los datos
- Construir el tensor
- Construye el modelo
- Entrenar y evaluar el modelo.
- Mejorar el modelo
Nota de versión: El código de este tutorial está dirigido a la API Estimator de TensorFlow 1.x. La versión final del paquete tf-estimator se incluyó con TensorFlow 2.15, y tf.estimator se eliminó en TensorFlow 2.16. Para ejecutar estos pasos en una versión actual, utilice TensorFlow 2.15 o reconstruya la misma red de dos capas con tf.keras.layers.Dense y model.fit().
Paso 1) Importar los datos
En primer lugar, necesitas importar la biblioteca necesaria. Puedes importar el conjunto de datos MNIST usando scikit-aprender como se muestra en el ejemplo de red neuronal de TensorFlow a continuación.
El conjunto de datos MNIST es el más utilizado para probar nuevas técnicas o algoritmos. Se trata de una colección de imágenes de 28 × 28 píxeles, cada una con un dígito manuscrito del 0 al 9. Un grupo de redes neuronales convolucionales profundas entrenadas con distorsiones elásticas logró reducir el error de la prueba al 0.27 %.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
El tutorial original descargó manualmente los archivos MNIST e indicó a fetch_mldata que apuntara a esa carpeta.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
Nota sobre la API: mldata.org ya no está en línea y fetch_mldata se eliminó en scikit-learn 0.22. En una instalación actual, reemplace la llamada anterior con fetch_openml('mnist_784', version=1), que descarga los mismos 70 000 dígitos y expone los mismos datos y atributos de destino.
Después, se dividen los datos y se obtiene la forma de ambos conjuntos de datos.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Paso 2) Transformar los datos
En el tutorial anterior, aprendiste que necesitas transformar los datos para limitar el efecto de los valores atípicos. En este tutorial de Redes Neuronales, transformarás los datos usando el escalador min-max. La fórmula es:
(X-min_x)/(max_x - min_x)
scikit-learn ya tiene una función para eso: MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Paso 3) Construye el tensor
Ahora ya estás familiarizado con la forma de crear tensores En TensorFlow, puedes convertir el conjunto de entrenamiento en una columna numérica.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Paso 4) Construye el modelo
La arquitectura de la red neuronal consta de dos capas ocultas: la primera con 300 unidades y la segunda con 100. Estos valores se basan en la experiencia, no en una fórmula. Puedes ajustarlos y observar cómo influyen en la precisión de la red.
Para construir el modelo, se utiliza el estimador DNNClassifier. Es necesario establecer el número de clases en 10, ya que el conjunto de entrenamiento contiene diez clases. La sintaxis del objeto estimador ya está familiarizada. Los argumentos feature_columns, n_classes y model_dir son exactamente los mismos que en el tutorial anterior. El argumento hidden_units es nuevo: controla tanto el número de capas como la cantidad de nodos que cada capa conecta a la red neuronal. En el código siguiente, hay dos capas ocultas: la primera conecta 300 nodos y la segunda 100.
Para construir el estimador, utilice tf.estimator.DNNClassifier con los siguientes parámetros:
- columnas de características: Defina las columnas que se utilizarán en la red.
- unidades ocultas: Defina el número de neuronas ocultas
- n_clases: Defina el número de clases a predecir
- directorio_modelo: Defina la ruta de TensorTablero
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Paso 5) Entrenar y evaluar el modelo.
Puedes utilizar la función de entrada de NumPy para entrenar el modelo y evaluarlo.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Salida:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
La arquitectura actual da como resultado una precisión en el conjunto de evaluación de aproximadamente el 96 por ciento.
Paso 6) Mejorar el modelo
Puede intentar mejorar el modelo agregando parámetros de regularización.
Aquí, el estimador utiliza un optimizador Proximal AdaGrad con una tasa de abandono de 0.3 y una intensidad L1 y L2 de 0.01. En una red neuronal de TensorFlow, se accede al optimizador mediante el objeto `train` seguido del nombre del optimizador. TensorFlow incluye una API integrada para el optimizador Proximal AdaGrad.
Para agregar regularización a la red neuronal profunda, puede usar tf.train.ProximalAdagradOptimizer con los siguientes parámetros:
- Tasa de aprendizaje: tasa de aprendizaje
- Regularización L1: l1_regularization_strength
- Regularización L2: l2_regularization_strength
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Salida:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Los valores elegidos para reducir el sobreajuste no mejoraron la precisión del modelo. Tu primer modelo tenía una precisión del 96%, mientras que el modelo con el regularizador L2 tiene una precisión del 95%. Puedes probar con diferentes valores y ver cómo afectan a la precisión.
