
K-có nghĩa là ClusterLập trình R với ví dụ
 Evelyn Clarke
⚡ Tóm tắt thông minh
K-nghĩa ClusterTrong R, thuật toán nhóm các quan sát bằng cách giảm thiểu khoảng cách giữa mỗi điểm và tâm cụm của nó. Hướng dẫn này chuẩn hóa tập dữ liệu giá máy tính, mô phỏng thuật toán, tìm giá trị k tối ưu bằng phương pháp khuỷu tay và đọc các cụm thông qua bản đồ nhiệt.

Là gì Cluster Phân tích?
Cluster phân tích thuộc về học tập không giám sát. Một cụm là một nhóm dữ liệu có chung các tính năng tương tự. Chúng ta có thể nói rằng, phân tích cụm thiên về khám phá hơn là dự đoán. Máy tìm kiếm sự tương đồng trong dữ liệu. Ví dụ, bạn có thể sử dụng phân tích cụm cho ứng dụng sau:
- Phân khúc khách hàng: Tìm kiếm sự tương đồng giữa các nhóm khách hàng
- Phân nhóm thị trường chứng khoán: Nhóm cổ phiếu dựa trên kết quả hoạt động
- Giảm chiều dữ liệu bằng cách nhómping quan sát có giá trị tương tự
Clusterphân tích không quá khó thực hiện và có ý nghĩa cũng như hữu ích cho doanh nghiệp.
Sự khác biệt nổi bật nhất giữa học tập có giám sát và không giám sát nằm ở kết quả. Học không giám sát tạo ra một biến mới, nhãn, trong khi học có giám sát dự đoán kết quả. Máy giúp người thực hiện việc gắn nhãn dữ liệu dựa trên mối liên hệ chặt chẽ. Việc sử dụng các nhóm và đặt tên cho chúng là tùy thuộc vào nhà phân tích.
Hãy lấy một ví dụ để hiểu khái niệm về cụm. Để đơn giản, chúng ta làm việc theo hai chiều. Bạn có dữ liệu về tổng chi tiêu của khách hàng và độ tuổi của họ. Để cải thiện quảng cáo, nhóm tiếp thị muốn gửi nhiều email có mục tiêu hơn đến khách hàng của họ.
Trong biểu đồ sau, bạn sẽ vẽ tổng chi tiêu và độ tuổi của khách hàng.
library(ggplot2)
df <- data.frame(age = c(18, 21, 22, 24, 26, 26, 27, 30, 31, 35, 39, 40, 41, 42, 44, 46, 47, 48, 49, 54),
    spend = c(10, 11, 22, 15, 12, 13, 14, 33, 39, 37, 44, 27, 29, 20, 28, 21, 30, 31, 23, 24)
)
ggplot(df, aes(x = age, y = spend)) +
    geom_point()

Một mô hình có thể nhìn thấy tại thời điểm này
- Ở phía dưới bên trái, bạn có thể thấy những người trẻ tuổi có sức mua thấp hơn
- Tầng trung lưu phía trên phản ánh những người có công việc mà họ có đủ khả năng chi tiêu nhiều hơn
- Cuối cùng là những người lớn tuổi với ngân sách thấp hơn.

Trong hình trên, bạn nhóm các quan sát bằng tay và xác định từng nhóm trong số ba nhóm. Ví dụ này hơi đơn giản và có tính trực quan cao. Nếu các quan sát mới được thêm vào tập dữ liệu, bạn có thể gắn nhãn cho chúng trong vòng tròn. Bạn xác định vòng tròn dựa trên đánh giá của chúng tôi. Thay vào đó, bạn có thể sử dụng Machine Learning để nhóm dữ liệu một cách khách quan.
Trong hướng dẫn này, bạn sẽ học cách sử dụng k-có nghĩa là thuật toán.
Thuật toán K-Means
K-means là phương pháp phân cụm được sử dụng rộng rãi nhất. Thuật toán này ra đời từ những năm 1950 và đã được cải tiến nhiều lần kể từ đó.
Thuật toán cố gắng tìm các nhóm bằng cách giảm thiểu khoảng cách giữa các quan sát, được gọi là tối ưu cục bộ các giải pháp. Khoảng cách được đo dựa trên tọa độ của các điểm quan sát. Ví dụ, trong không gian hai chiều, tọa độ chỉ đơn giản là x và y.
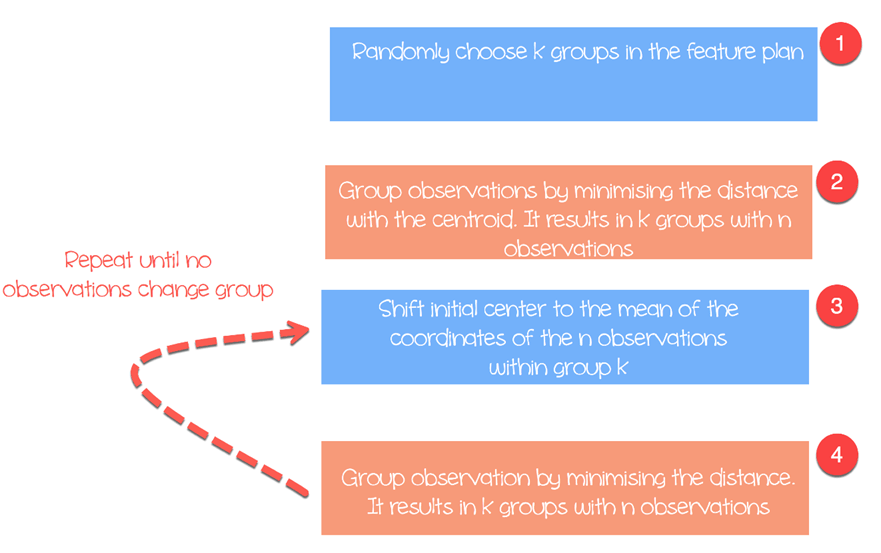
Thuật toán hoạt động như sau:
- Bước 1: Chọn ngẫu nhiên k tâm cụm ban đầu trong không gian đặc trưng.
- Bước 2: Gán mỗi quan sát cho tâm cụm gần nhất của nó, TâmĐiều này tạo ra k nhóm.
- Bước 3: Shift tâm ban đầu đến giá trị trung bình của các tọa độ trong một nhóm.
- Bước 4: Giảm thiểu khoảng cách theo trọng tâm mới. Những ranh giới mới được tạo ra. Do đó, các quan sát sẽ chuyển từ nhóm này sang nhóm khác
- Lặp lại cho đến khi không có quan sát nào thay đổi nhóm
Thuật toán K-means thường đo khoảng cách Euclidean giữa hai quan sát x và y:

Ngoài ra còn có các thước đo khác, chẳng hạn như khoảng cách Manhattan hoặc Minkowski. Lưu ý rằng, thuật toán K-mean trả về các nhóm khác nhau mỗi khi bạn chạy thuật toán. Hãy nhớ rằng các dự đoán ban đầu là ngẫu nhiên và thuật toán tính toán khoảng cách cho đến khi đạt được sự đồng nhất trong các nhóm. Nghĩa là, K-mean rất nhạy cảm với lựa chọn đầu tiên, và trừ khi số lượng quan sát và nhóm nhỏ, hầu như không thể có được cùng một kết quả phân cụm.
Chọn số lượng cụm
Một khó khăn khác của thuật toán k-means là việc lựa chọn số lượng cụm. Bạn có thể đặt giá trị k cao, tức là số lượng nhóm lớn, để cải thiện tính đồng nhất trong nhóm, nhưng điều này tiềm ẩn rủi ro. quá mức Dữ liệu. Hiện tượng quá khớp (overfitting) nghĩa là hiệu suất giảm mạnh trên dữ liệu mới, bởi vì mô hình đã ghi nhớ nhiễu trong mẫu cụ thể này thay vì mô hình cơ bản.
Số lượng cụm phụ thuộc vào bản chất của tập dữ liệu, ngành, hoạt động kinh doanh, v.v. Tuy nhiên, có một quy tắc chung để chọn số cụm thích hợp:

trong đó n là số lượng quan sát trong tập dữ liệu.
Trên thực tế, nên dành thời gian tìm kiếm giá trị của k phù hợp nhất với nhu cầu kinh doanh.
Chúng tôi sẽ sử dụng bộ dữ liệu Giá máy tính cá nhân để thực hiện phân tích phân cụm. Bộ dữ liệu này chứa 6259 quan sát và 10 tính năng. Bộ dữ liệu quan sát giá từ năm 1993 đến năm 1995 của 486 máy tính cá nhân ở Mỹ. Các biến là giá, tốc độ, ram, màn hình, cd và nhiều thứ khác.
Bạn sẽ tiến hành như sau:
- Nhập dữ liệu
- Đào tạo mô hình
- Đánh giá mô hình
Nhập dữ liệu
Thuật toán K-means không phù hợp với các biến định tính vì nó hoạt động trên khoảng cách và các nhãn rời rạc không có khoảng cách ý nghĩa nào giữa chúng. Hãy loại bỏ ba cột phân loại (cd, multi, premium) cùng với chỉ số hàng X. Tập dữ liệu này không chứa giá trị thiếu.
library(dplyr)
PATH <-"https://raw.githubusercontent.com/guru99-edu/R-Programming/master/computers.csv"
df <- read.csv(PATH) %>%
select(-c(X, cd, multi, premium))
glimpse(df)
Đầu ra
## Observations: 6,259
## Variables: 7
## $ price <int> 1499, 1795, 1595, 1849, 3295, 3695, 1720, 1995, 2225, 2...
## $ speed <int> 25, 33, 25, 25, 33, 66, 25, 50, 50, 50, 33, 66, 50, 25, ...
## $ hd <int> 80, 85, 170, 170, 340, 340, 170, 85, 210, 210, 170, 210...
## $ ram <int> 4, 2, 4, 8, 16, 16, 4, 2, 8, 4, 8, 8, 4, 8, 8, 4, 2, 4, ...
## $ screen <int> 14, 14, 15, 14, 14, 14, 14, 14, 14, 15, 15, 14, 14, 14, ...
## $ ads <int> 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, ...
## $ trend  <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1...
Từ số liệu thống kê tóm tắt, bạn có thể thấy dữ liệu có giá trị lớn. Một biện pháp tốt trước khi áp dụng bất kỳ phương pháp dựa trên khoảng cách nào là chuẩn hóa dữ liệu sao cho mỗi biến đều có giá trị trung bình. trung bình bằng XNUMX và độ lệch chuẩn là mộtNếu không có nó, giá cả, vốn có giá trị lên đến hàng nghìn đô la, sẽ chi phối việc tính toán khoảng cách và kích thước màn hình sẽ gần như không có ý nghĩa gì.
summary(df)
Đầu ra:
##      price          speed              hd              ram
##  Min.   : 949   Min.   : 25.00   Min.   :  80.0   Min.   : 2.000
##  1st Qu.:1794   1st Qu.: 33.00   1st Qu.: 214.0   1st Qu.: 4.000
##  Median :2144   Median : 50.00   Median : 340.0   Median : 8.000
##  Mean   :2220   Mean   : 52.01   Mean   : 416.6   Mean   : 8.287
##  3rd Qu.:2595   3rd Qu.: 66.00   3rd Qu.: 528.0   3rd Qu.: 8.000
##  Max.   :5399   Max.   :100.00   Max.   :2100.0   Max.   :32.000
##      screen           ads            trend
##  Min.   :14.00   Min.   : 39.0   Min.   : 1.00
##  1st Qu.:14.00   1st Qu.:162.5   1st Qu.:10.00
##  Median :14.00   Median :246.0   Median :16.00
##  Mean   :14.61   Mean   :221.3   Mean   :15.93
##  3rd Qu.:15.00   3rd Qu.:275.0   3rd Qu.:21.50
##  Max.   :17.00   Max.   :339.0   Max.   :35.00
Bạn định lại tỷ lệ cho các biến bằng hàm thang đo () của thư viện dplyr. Phép biến đổi làm giảm tác động của các giá trị ngoại lệ và cho phép so sánh một quan sát duy nhất với giá trị trung bình. Nếu một giá trị tiêu chuẩn hóa (hoặc điểm z) cao, bạn có thể tin tưởng rằng quan sát này thực sự cao hơn giá trị trung bình (điểm z lớn ngụ ý rằng điểm này cách xa giá trị trung bình về mặt độ lệch chuẩn. Điểm z bằng 2 cho biết giá trị là XNUMX tiêu chuẩn Lưu ý, điểm z tuân theo phân bố Gaussian và đối xứng quanh giá trị trung bình.
# Note: speed is deliberately left out of the scaled data frame
rescale_df <- df %>%
    mutate(price_scal = scale(price),
    hd_scal = scale(hd),
    ram_scal = scale(ram),
    screen_scal = scale(screen),
    ads_scal = scale(ads),
    trend_scal = scale(trend)) %>%
select(-c(price, speed, hd, ram, screen, ads, trend))
Cơ sở R có chức năng chạy thuật toán k trung bình. Hàm cơ bản của k trung bình là:
kmeans(df, k)
arguments:
-df: dataset used to run the algorithm
-k: Number of clusters
Đào tạo mô hình
Trong hình ba, bạn đã mô tả chi tiết cách thuật toán hoạt động. Bạn có thể xem từng bước một cách trực quan bằng gói hoạt hình do Yihui Xie viết, người cũng đã tạo ra knitr cho R Markdown. Gói này không có trong các kênh conda, vì vậy hãy cài đặt nó từ CRAN:
install.packages("animation")
Sau khi tải thư viện, bạn thêm .ani sau kmeans và R sẽ vẽ tất cả các bước. Để minh họa, bạn chỉ chạy thuật toán với các biến được định cỡ lại hd và ram với ba cụm.
set.seed(2345)
library(animation)
kmeans.ani(rescale_df[2:3], 3)
Code Giải thích
- kmeans.ani(rescale_df[2:3], 3): Chọn cột 2 và 3 của tập dữ liệu rescale_df và chạy thuật toán với k bộ thành 3. Vẽ đồ họa.


Bạn có thể diễn giải hoạt ảnh như sau:
- Bước 1: R chọn ngẫu nhiên XNUMX điểm
- Bước 2: Tính khoảng cách Euclide và vẽ các cụm. Bạn có một cụm màu xanh lá cây ở phía dưới bên trái, một cụm lớn màu đen ở bên phải và một cụm màu đỏ ở giữa chúng.
- Bước 3: Tính centroid, tức là giá trị trung bình của cụm
- Lặp lại cho đến khi không có dữ liệu thay đổi cụm
Thuật toán hội tụ sau bảy lần lặp. Bạn có thể chạy thuật toán k-mean trong tập dữ liệu của chúng tôi với năm cụm và gọi nó là pc_cluster.
pc_cluster <-kmeans(rescale_df, 5)
Danh sách pc_cluster chứa bảy phần tử hữu ích:
- pc_cluster$cluster: Cụm được gán cho mỗi quan sát
- pc_cluster$centers: Trung tâm cụm
- pc_cluster$totss: Tổng bình phương
- pc_cluster$withinss: Tổng bình phương trong phạm vi, một giá trị cho mỗi cụm
- pc_cluster$tot.withinss: Tổng của withinss
- pc_cluster$betweenss: Tổng bình phương sai số trừ đi tổng bình phương sai số trong các cụm con.
- pc_cluster$size: Số lượng quan sát trong mỗi cụm
Bạn sẽ sử dụng tổng của tổng bình phương bên trong (tức là tot.withinss) để tính số cụm k tối ưu. Việc tìm k thực sự là một nhiệm vụ quan trọng.
Cách tìm giá trị k tối ưu bằng phương pháp khuỷu tay
Một kỹ thuật để chọn k tốt nhất được gọi là phương pháp khuỷu tay. Phương pháp này sử dụng tính đồng nhất trong nhóm hoặc tính không đồng nhất trong nhóm để đánh giá độ biến thiên. Nói cách khác, bạn quan tâm đến tỷ lệ phần trăm phương sai được giải thích bởi mỗi cụm. Bạn có thể mong đợi độ biến thiên tăng theo số lượng cụm, mặt khác, tính không đồng nhất sẽ giảm. Thử thách của chúng ta là tìm ra k nằm ngoài hiệu suất giảm dần. Việc thêm một cụm mới không cải thiện tính biến đổi của dữ liệu vì còn rất ít thông tin để giải thích.
Trong hướng dẫn này, chúng ta tìm điểm này bằng cách sử dụng phép đo tính không đồng nhất. Tổng số trong cụm tổng bình phương là tot.withinss trong danh sách trả về bởi kmean().
Bạn có thể xây dựng biểu đồ khuỷu tay và tìm k tối ưu như sau:
- Bước 1: Xây dựng một hàm để tính tổng bình phương trong cụm
- Bước 2: Chạy thuật toán trên một phạm vi các giá trị k.
- Bước 3: Tạo khung dữ liệu với kết quả của thuật toán
- Bước 4: Vẽ kết quả
Bước 1) Xây dựng một hàm để tính tổng bình phương trong cụm
Bạn tạo hàm chạy thuật toán k-mean và lưu trữ tổng số trong cụm tổng bình phương
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, k)
    return (cluster$tot.withinss)
}
Code Giải thích
- function(k): Đặt số lượng đối số trong hàm
- kmeans(rescale_df, k): Chạy thuật toán với giá trị k này
- return(cluster$tot.withinss): Lưu trữ tổng số trong cụm tổng bình phương
Kiểm tra hàm số với k bằng 2.
Đầu ra:
## Try with 2 cluster
kmean_withinss(2)
Đầu ra:
## [1] 27087.07
Bước 2) Chạy thuật toán n lần
Bạn sẽ sử dụng hàm sapply() để chạy thuật toán trong phạm vi k. Kỹ thuật này nhanh hơn việc tạo vòng lặp và lưu trữ giá trị.
# Set maximum cluster
max_k <-20
# Run algorithm over a range of k
wss <- sapply(2:max_k, kmean_withinss)
Code Giải thích
- max_k <- 20: Đặt giá trị tối đa của k là 20
- sapply(2:max_k, kmean_withinss): Chạy hàm kmean_withinss() trên phạm vi 2:max_k, tức là từ 2 đến 20.
Bước 3) Tạo khung dữ liệu với kết quả của thuật toán
Sau khi viết và kiểm thử hàm, hãy chạy nó trên phạm vi từ 2 đến 20 và lưu trữ mọi giá trị của tot.withinss.
# Create a data frame to plot the graph
elbow <-data.frame(2:max_k, wss)
Code Giải thích
- data.frame(2:max_k, wss): Tạo data frame với đầu ra của thuật toán lưu trữ trong wss
Bước 4) Lập biểu đồ kết quả
Bạn vẽ đồ thị để hình dung đâu là điểm khuỷu tay
# Plot the graph with gglop
ggplot(elbow, aes(x = X2.max_k, y = wss)) +
    geom_point() +
    geom_line() +
    scale_x_continuous(breaks = seq(1, 20, by = 1))

Từ biểu đồ, bạn có thể thấy k tối ưu là 7, trong đó đường cong bắt đầu có hiệu suất giảm dần.
Khi bạn đã có k tối ưu, bạn chạy lại thuật toán với k bằng 7 và đánh giá các cụm.
Kiểm tra các cụm
pc_cluster_2 <-kmeans(rescale_df, 7)
Như đã đề cập trước đó, bạn có thể truy cập các thông tin thú vị còn lại trong danh sách được trả về bởi kmean().
pc_cluster_2$cluster
pc_cluster_2$centers
pc_cluster_2$size
Việc đánh giá mang tính chủ quan và phụ thuộc vào mục đích của các cụm. Mục tiêu ở đây là nhóm các máy tính có thông số kỹ thuật tương tự nhau. Một chuyên gia trong lĩnh vực này có thể thực hiện việc này bằng tay, nhưng quá trình sẽ chậm và dễ xảy ra lỗi. Thuật toán K-means thực hiện việc nhóm...ping một cách khách quan và để chuyên gia diễn giải và đặt tên cho kết quả.
Khi đánh giá trước, bạn có thể kiểm tra kích thước của các cụm.
pc_cluster_2$size
Đầu ra:
## [1] 608 1596 1231 580 1003 699 542
Cụm lớn nhất, số 2, chứa 1,596 quan sát, trong khi cụm nhỏ nhất, số 7, chỉ chứa 542 máy tính. Có thể sẽ tốt hơn nếu các cụm có tính đồng nhất, nếu không, có thể cần phải chuẩn bị dữ liệu kỹ hơn.
Bạn có thể hiểu sâu hơn về dữ liệu với thành phần trung tâm. Các hàng biểu thị số thứ tự của cụm và các cột biểu thị các biến được thuật toán sử dụng. Các giá trị là điểm trung bình của mỗi cụm cho cột cần quan tâm. Chuẩn hóa giúp việc diễn giải dễ dàng hơn. Các giá trị dương cho biết điểm z của một cụm nhất định cao hơn mức trung bình chung. Ví dụ, cụm 4 có giá trung bình cao nhất (price_scal = 1.09), trong khi cụm 5 có giá trung bình thấp nhất (-0.82).
center <-pc_cluster_2$centers
center
Đầu ra:
##   price_scal    hd_scal     ram_scal screen_scal   ads_scal trend_scal
## 1 -0.6372457 -0.7097995 -0.691520682  -0.4401632  0.6780366 -0.3379751
## 2 -0.1323863  0.6299541  0.004786730   2.6419582 -0.8894946  1.2673184
## 3  0.8745816  0.2574164  0.513105797  -0.2003237  0.6734261 -0.3300536
## 4  1.0912296 -0.2401936  0.006526723   2.6419582  0.4704301 -0.4132057
## 5 -0.8155183  0.2814882 -0.307621003  -0.3205176 -0.9052979  1.2177279
## 6  0.8830191  2.1019454  2.168706085   0.4492922 -0.9035248  1.2069855
## 7  0.2215678 -0.7132577 -0.318050275  -0.3878782 -1.3206229 -1.5490909
Bạn có thể tạo bản đồ nhiệt bằng ggplot để giúp chúng tôi nêu bật sự khác biệt giữa các danh mục.
Màu mặc định của ggplot cần được thay đổi bằng thư viện RColorBrewer. Bạn có thể sử dụng conda thư viện và mã để khởi chạy trong thiết bị đầu cuối:
conda install -c r r-rcolorbrewer
Để tạo bản đồ nhiệt, bạn tiến hành theo ba bước:
- Xây dựng khung dữ liệu với các giá trị của trung tâm và tạo một biến với số lượng cụm
- Định hình lại dữ liệu bằng hàm thu thập () của thư viện gọn gàng. Bạn muốn chuyển đổi dữ liệu từ rộng sang dài.
- Tạo bảng màu với màu sắcRampHàm Palette()
Bước 1) Xây dựng khung dữ liệu
Hãy tạo tập dữ liệu định hình lại
library(tidyr)

# create dataset with the cluster number

cluster <- c(1: 7)
center_df <- data.frame(cluster, center)

# Reshape the data

center_reshape <- gather(center_df, features, values, price_scal: trend_scal)
head(center_reshape)
Đầu ra:
##   cluster   features     values
## 1       1 price_scal -0.6372457
## 2       2 price_scal -0.1323863
## 3       3 price_scal  0.8745816
## 4       4 price_scal  1.0912296
## 5       5 price_scal -0.8155183
## 6       6 price_scal  0.8830191
Bước 2) Tạo bảng màu
Đoạn mã dưới đây xây dựng bảng màu được sử dụng bởi bản đồ nhiệt.
library(RColorBrewer)
# Create the palette
hm.palette <-colorRampPalette(rev(brewer.pal(10, 'RdYlGn')),space='Lab')
Bước 3) Hình dung
Bạn có thể vẽ biểu đồ và xem các cụm trông như thế nào.
# Plot the heat map
ggplot(data = center_reshape, aes(x = features, y = cluster, fill = values)) +
    scale_y_continuous(breaks = seq(1, 7, by = 1)) +
    geom_tile() +
    coord_equal() +
    scale_fill_gradientn(colours = hm.palette(90)) +
    theme_classic()

Cách để có được kết quả K-Means có thể tái tạo với set.seed() và nstart
Bài hướng dẫn lưu ý rằng thuật toán k-means trả về các nhóm khác nhau trong mỗi lần chạy. Đó không phải là một lỗi nhỏ cần chấp nhận, mà là một vấn đề có thể khắc phục bằng hai cách thông thường, và cả hai cách này đều không được sử dụng trong các ví dụ trên.
1. Cố định điểm bắt đầu bằng cách sử dụng set.seed(). Các tâm cụm ban đầu được chọn ngẫu nhiên, do đó cùng một lệnh gọi sẽ tạo ra các cụm khác nhau mỗi lần. Việc thiết lập một giá trị hạt giống giúp toàn bộ quá trình phân tích có thể tái tạo được:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, 7)
2. Chạy thử vài lần và giữ lại kết quả tốt nhất với lệnh nstart. Một lần khởi tạo ngẫu nhiên duy nhất có thể dẫn đến một điểm tối ưu cục bộ kém hiệu quả. Tham số nstart chạy thuật toán n lần từ các lần khởi tạo ngẫu nhiên khác nhau và trả về kết quả có tổng bình phương sai số thấp nhất:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, centers = 7, nstart = 25)
Thông thường, khuyến nghị là thực hiện 25 lần khởi tạo và chi phí rất thấp đối với tập dữ liệu có kích thước này. Nếu không, đường cong khuỷu tay sẽ trở nên không ổn định, vì mỗi điểm trên biểu đồ đều xuất phát từ một lần khởi tạo không may mắn hoặc may mắn duy nhất. Do đó, hàm kmean_withinss() được định nghĩa trước đó nên được viết như sau:
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, centers = k, nstart = 25)
    return (cluster$tot.withinss)
}
3. Tăng giá trị iter.max nếu thuật toán đưa ra cảnh báo. Nếu R báo cáo “không hội tụ sau 10 lần lặp”, hãy truyền iter.max = 50 để tăng thêm khoảng trống.
K-Means so với thuật toán phân cấp Clustering trong R
K-means không phải là phương pháp phân cụm duy nhất, và sự lựa chọn thường phụ thuộc vào kích thước dữ liệu và việc bạn đã biết mình muốn có bao nhiêu nhóm hay chưa.
| Tiêu chí | K-nghĩa | Thứ bậc |
|---|---|---|
| Số lượng cụm | Phải được chọn trước | Được chọn sau khi cắt biểu đồ cây. |
| Tính ổn định của kết quả | Thay đổi tùy thuộc vào điểm khởi đầu ngẫu nhiên | Xác định |
| khả năng mở rộng | Xử lý các tập dữ liệu rất lớn. | Những cuộc đấu tranh vượt ra ngoài phạm vi vài nghìn hàng ghế |
| Cluster định hình | Giả định các nhóm có hình dạng gần như hình cầu và kích thước tương tự nhau. | Linh hoạt hơn |
| Đầu ra | Một bộ nhãn phẳng | Biểu đồ cây thể hiện cấu trúc lồng nhau. |
| hàm R | kmeans(df, k) | hclust(dist(df)) |
# Hierarchical alternative on the same scaled data
hc <- hclust(dist(rescale_df), method = "ward.D2")
plot(hc)
groups <- cutree(hc, k = 7)
Với 6,259 quan sát, phân cụm phân cấp phải xây dựng ma trận khoảng cách gồm khoảng 19.6 triệu cặp, đó là lý do tại sao k-means là lựa chọn thực tế cho tập dữ liệu này. Cũng cần lưu ý rằng k-means giả định các cụm có kích thước tương tự và hình dạng gần như hình cầu; khi giả định đó không đúng, DBSCAN xử lý các hình dạng bất thường và xác định các điểm ngoại lai thay vì ép buộc mọi điểm vào một nhóm.
K-nghĩa Clustertrong R: Tham chiếu hàm
Tất cả các hàm được sử dụng trong hướng dẫn này đều được liệt kê bên dưới:
| Bưu kiện | Mục tiêu | Chức năng | Tranh luận |
|---|---|---|---|
| cơ sở | Đào tạo k-trung bình | kmeans() | df, k |
| Cụm truy cập | kmeans()$ cụm | ||
| Cluster trung tâm | kmeans()$trung tâm | ||
| Cluster kích thước | kmeans()$kích thước | ||
| Tổng trong tổng bình phương | kmeans()$tot.withinss | Được sử dụng bằng phương pháp khuỷu tay | |
| Giữa tổng bình phương | kmeans()$betweenss | ||
| cơ sở | Chạy thử nghiệm có thể tái tạo | đặt hạt giống() | giá trị hạt giống |
| cơ sở | Ổn định kết quả | kmeans(df, k, nstart = 25) | nstart |
