
Hạt nhân Gaussian trong học máy: Python Phương thức hạt nhân
 Evelyn Clarke
⚡ Tóm tắt thông minh
Các phương pháp nhân Gaussian giúp phân tách dữ liệu không thể tách rời thành dữ liệu tuyến tính mà không cần xây dựng bản đồ đặc trưng đa chiều. Hướng dẫn này sẽ minh họa bản đồ đa thức.ping bằng tay, sau đó huấn luyện một bộ phân loại hạt nhân Fourier ngẫu nhiên trong TensorFlow.
Mục đích của hướng dẫn này là làm cho một tập dữ liệu có thể phân tách tuyến tính. Hướng dẫn được chia thành hai phần:
- Chuyển đổi tính năng
- Huấn luyện bộ phân loại Kernel với TensorFlow.
Trong phần đầu tiên, bạn sẽ hiểu ý tưởng đằng sau phương pháp Kernel trong Học máy, trong khi ở phần thứ hai, bạn sẽ thấy cách huấn luyện một bộ phân loại Kernel với... TensorFlowBạn sẽ sử dụng bộ dữ liệu người trưởng thành. Mục tiêu của bộ dữ liệu này là phân loại thu nhập dưới và trên 50 đô la, dựa trên hành vi của từng hộ gia đình.
Tại sao bạn cần Phương thức hạt nhân?
Mục tiêu của mọi thuật toán phân loại là dự đoán chính xác các lớp. Để làm được điều đó, tập dữ liệu phải phân tách được. Hãy nhìn vào biểu đồ bên dưới; khá dễ dàng để thấy rằng tất cả các điểm nằm trên đường màu đen thuộc về lớp thứ nhất và các điểm còn lại thuộc về lớp thứ hai. Tuy nhiên, rất hiếm khi có một tập dữ liệu đơn giản như vậy. Trong hầu hết các trường hợp, dữ liệu không phân tách được, và dữ liệu không phân tách được sẽ gây khó khăn cho các thuật toán phân loại đơn giản như hồi quy logistic.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

Trong hình dưới đây, chúng ta vẽ biểu đồ một tập dữ liệu không thể phân tách tuyến tính. Nếu ta vẽ một đường thẳng, hầu hết các điểm sẽ không được phân loại vào đúng lớp.
Một cách để giải quyết vấn đề này là lấy tập dữ liệu và biến đổi dữ liệu thành một bản đồ đặc trưng khác. Điều này có nghĩa là bạn sẽ sử dụng một hàm để di chuyển dữ liệu sang một mặt phẳng khác, một mặt phẳng mà các phần tử có thể phân tách tuyến tính.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
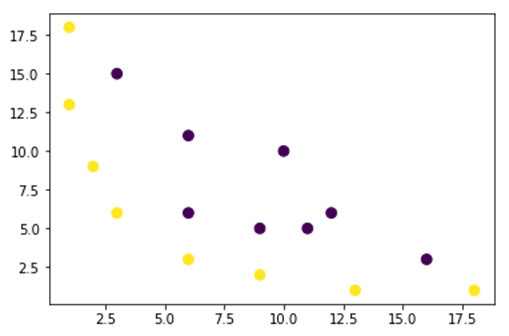
Dữ liệu từ hình trên nằm trên mặt phẳng 2D và không thể tách rời. Bạn có thể thử chuyển đổi dữ liệu này sang không gian ba chiều, nghĩa là tạo ra một hình có 3 trục.
Trong ví dụ về hạt nhân Gaussian, chúng ta sẽ áp dụng một phép ánh xạ đa thức.ping Để đưa dữ liệu của chúng ta lên chiều thứ ba. Công thức để chuyển đổi dữ liệu như sau.

Bạn xác định một hàm trong Gaussian Kernel Python để tạo ra các bản đồ tính năng mới.
Bạn có thể sử dụng numpy để mã hóa công thức trên. Mỗi hàng bên dưới ghép một thuật ngữ của bản đồ.ping với biểu thức mảng tạo ra nó, và hình ảnh nhỏ đánh dấu căn bậc hai của thừa số hai.
| Công thức | Mã NumPy tương đương |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Bản đồ mớiping có 3 chiều và 16 điểm.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Bây giờ hãy tạo một đồ thị mới với 3 trục, lần lượt là x, y và z.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Chúng ta thấy có sự cải thiện, nhưng nếu thay đổi hướng của biểu đồ thì rõ ràng là tập dữ liệu giờ đây đã có thể phân tách được.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Nếu bạn cần xử lý một tập dữ liệu lớn và tạo ra nhiều hơn 2 chiều, bạn sẽ gặp vấn đề lớn với phương pháp trên. Trên thực tế, bạn cần phải biến đổi tất cả các điểm dữ liệu, điều này rõ ràng là không khả thi. Nó sẽ tốn rất nhiều thời gian và máy tính của bạn có thể hết bộ nhớ.
Cách phổ biến nhất để khắc phục vấn đề này là sử dụng nhân hệ điều hành.
Hạt nhân trong học máy là gì?
Ý tưởng là sử dụng không gian đặc trưng đa chiều để làm cho dữ liệu gần như có thể phân tách tuyến tính, như hình minh họa ở trên.
Có rất nhiều không gian đa chiều giúp phân tách các điểm dữ liệu. Ví dụ, chúng ta đã chứng minh rằng ánh xạ đa thứcping là một khởi đầu tuyệt vời.
Chúng tôi cũng đã chứng minh rằng với lượng dữ liệu lớn, các phép biến đổi này không hiệu quả. Thay vào đó, bạn có thể sử dụng hàm Kernel trong Học máy để sửa đổi dữ liệu mà không cần chuyển sang mặt phẳng đặc trưng mới.
Điều kỳ diệu của kernel là tìm ra một hàm tránh được tất cả những rắc rối phát sinh từ việc tính toán trong không gian đa chiều. Kết quả của kernel là một đại lượng vô hướng, hay nói cách khác, chúng ta quay trở lại không gian một chiều.
Sau khi tìm thấy hàm này, bạn có thể tích hợp nó vào bộ phân loại tuyến tính tiêu chuẩn.
Dưới đây là một ví dụ giúp cụ thể hóa khái niệm Học máy Kernel. Bạn có hai vectơ, x1 và x2. Mục tiêu là tạo ra một chiều cao hơn bằng cách sử dụng phép ánh xạ đa thức.pingKết quả đầu ra bằng tích vô hướng của bản đồ đặc trưng mới. Từ phương pháp trên, bạn cần:
- Biến x1 và x2 thành một chiều mới
- Tính tích số chấm: chung cho tất cả các hạt nhân
Biến x1 và x2 thành một chiều mới
Bạn có thể sử dụng hàm được tạo ở trên để tính kích thước cao hơn.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Đầu ra
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Tính tích chấm
Bạn có thể sử dụng dấu chấm đối tượng từ numpy Tính tích vô hướng giữa vectơ thứ nhất và vectơ thứ hai được lưu trữ trong x_1.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Kết quả là 8100. Bạn thấy vấn đề rồi đấy: bạn cần lưu trữ một bản đồ đặc trưng mới trong bộ nhớ để tính tích vô hướng. Nếu bạn có một tập dữ liệu với hàng triệu bản ghi, việc này sẽ không hiệu quả về mặt tính toán.
Thay vào đó, bạn có thể sử dụng nhân đa thức để tính tích vô hướng mà không cần biến đổi vectơ. Hàm này tính tích vô hướng của x1 và x2 như thể hai vectơ này đã được biến đổi sang chiều cao hơn. Nói cách khác, hàm nhân tính toán kết quả của tích vô hướng từ một không gian đặc trưng khác.
Bạn có thể viết hàm hạt nhân đa thức trong Python như sau.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Đó là lũy thừa của tích vô hướng của hai vectơ. Dưới đây, bạn trả về bậc hai của hạt nhân đa thức. Đầu ra bằng với phương pháp khác. Đây là sự kỳ diệu của hạt nhân.
polynomial_kernel(x1, x2, p=2)
8100
Các loại phương thức hạt nhân
Có rất nhiều kỹ thuật Kernel khác nhau. Đơn giản nhất là kernel tuyến tính. Hàm này hoạt động khá tốt cho việc phân loại văn bản. Các kernel khác bao gồm:
- nhân đa thức
- Hạt nhân Gaussian
Bảng dưới đây tóm tắt chức năng của từng công cụ và thời điểm người dùng cần sử dụng chúng.
| Hạt nhân | Nó tính toán điều gì? | Sử dụng điển hình |
|---|---|---|
| tuyến tính | Tích vô hướng đơn giản trong không gian đặc trưng ban đầu | Dữ liệu đã tách rời và các đặc điểm văn bản đa chiều |
| Đa thức | Tích vô hướng được nâng lên bậc p, thể hiện sự tương tác giữa các đặc điểm. | Các ranh giới cong khi biết rằng các tương tác có ảnh hưởng. |
| Gaussian (RBF) | Độ tương đồng dựa trên khoảng cách giảm dần về 0 khi các điểm càng cách xa nhau. | Đây thường là lựa chọn đầu tiên khi hình dạng đường biên chưa được biết. |
Trong ví dụ với TensorFlow, chúng ta sẽ sử dụng các đặc trưng Fourier ngẫu nhiên. TensorFlow có một bộ ước lượng tích hợp sẵn để tính toán không gian đặc trưng mới. Bộ ánh xạ đặc trưng Fourier ngẫu nhiên là một phép xấp xỉ của hàm nhân Gaussian được hiển thị bên dưới.

Hàm lọc Gaussian tính toán độ tương tự giữa các điểm dữ liệu trong không gian có chiều cao hơn nhiều.
Sau khi đã nắm vững lý thuyết, phần còn lại của hướng dẫn này sẽ sử dụng nhân Gaussian để tính toán trên một tập dữ liệu thực tế.
Đào tạo trình phân loại hạt nhân Gaussian với TensorFlow
Mục tiêu của thuật toán là phân loại hộ gia đình có thu nhập nhiều hơn hoặc ít hơn 50 nghìn.
Đầu tiên, bạn sẽ đánh giá một mô hình hồi quy logistic để có mô hình chuẩn. Sau đó, bạn sẽ huấn luyện một bộ phân loại Kernel để xem liệu có thể đạt được kết quả tốt hơn hay không.
Bạn sử dụng các biến sau từ tập dữ liệu người lớn:
- tuổi
- lớp học nghề
- fnlwgt
- giáo dục
- giáo dục_num
- hôn nhân
- nghề nghiệp
- mối quan hệ
- cuộc đua
- quan hệ tình dục
- tăng vốn
- vốn_lỗ
- giờ_tuần
- quê hương
- nhãn
Bạn sẽ tiến hành các bước sau trước khi huấn luyện và đánh giá mô hình:
- Nhập các thư viện
- Nhập dữ liệu
- Chuẩn bị dữ liệu
- Xây dựng mô hình logistic: mô hình cơ sở
- Đánh giá mô hình
- Xây dựng và đánh giá bộ phân loại Kernel
Ghi chú phiên bản: Mọi đoạn mã bên dưới đều nhắm đến TensorFlow 1.x. Không gian tên tf.contrib, cung cấp các lớp real_valued_column, RandomFourierFeatureMapper và KernelLinearClassifier, đã bị loại bỏ trong TensorFlow 2.0, và bản thân tf.estimator cũng đã bị loại bỏ trong TensorFlow 2.16. Trên phiên bản hiện tại, hãy xây dựng cùng một pipeline với lớp tf.keras.layers.experimental.RandomFourierFeatures theo sau là lớp đầu ra Dense, hoặc với cặp RBFSampler và SGDClassifier từ scikit-learn.
Bước 1) Nhập thư viện
Để nhập và huấn luyện các mô hình Kernel trong Trí tuệ nhân tạoBạn cần nhập TensorFlow. gấu trúc và NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Bước 2) Nhập dữ liệu
Bạn tải dữ liệu xuống từ... Trang dữ liệu người lớn của UCI và nhập nó dưới dạng DataFrame của pandas.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Giờ đây, khi tập dữ liệu huấn luyện và kiểm tra đã được xác định, bạn có thể thay đổi nhãn cột từ chuỗi ký tự sang số nguyên. TensorFlow không chấp nhận giá trị chuỗi ký tự cho nhãn.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Bước 3) Chuẩn bị dữ liệu
Tập dữ liệu chứa cả các đặc trưng liên tục và phân loại. Một cách làm tốt là chuẩn hóa giá trị của các biến liên tục. Bạn có thể sử dụng hàm StandardScaler từ... học hỏiBạn cũng tạo một hàm do người dùng định nghĩa để dễ dàng chuyển đổi tập dữ liệu huấn luyện và kiểm tra. Lưu ý rằng bạn nối các biến liên tục và biến phân loại vào một tập dữ liệu chung, và mảng này phải có kiểu dữ liệu float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
Chức năng chuyển đổi đã sẵn sàng, vì vậy bạn có thể chuyển đổi tập dữ liệu và tạo hàm input_fn.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
Trong bước tiếp theo, bạn sẽ huấn luyện hồi quy logistic. Nó sẽ cung cấp cho bạn độ chính xác cơ bản. Mục tiêu là vượt qua đường cơ sở bằng một thuật toán khác, cụ thể là bộ phân loại hạt nhân.
Bước 4) Xây dựng mô hình logistic: Mô hình cơ sở
Bạn xây dựng cột tính năng với đối tượng real_valued_column. Nó sẽ đảm bảo tất cả các biến đều là dữ liệu số dày đặc.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Bộ ước lượng được định nghĩa bằng cách sử dụng API TensorFlow Estimator; bạn cung cấp các cột đặc trưng và nơi lưu đồ thị.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Bạn sẽ huấn luyện mô hình hồi quy logistic bằng cách sử dụng các mini-batch có kích thước 200 phần tử.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Bạn có thể huấn luyện mô hình với 1,000 lần lặp.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Bước 5) Đánh giá mô hình
Bạn định nghĩa hàm đầu vào NumPy để đánh giá mô hình. Bạn sử dụng toàn bộ tập dữ liệu kiểm thử để đánh giá.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Bạn đạt độ chính xác 82%. Trong phần tiếp theo, bạn sẽ thử đánh bại bộ phân loại logistic bằng bộ phân loại Kernel.
Bước 6) Xây dựng bộ phân loại hạt nhân
Bộ ước lượng hạt nhân không khác biệt nhiều so với bộ phân loại tuyến tính truyền thống, ít nhất là về cấu trúc. Ý tưởng đằng sau nó là kết hợp sức mạnh của một ánh xạ hạt nhân rõ ràng.ping với bộ phân loại tuyến tính.
Bạn cần hai công cụ ước tính được xác định trước có sẵn trong TensorFlow để huấn luyện Trình phân loại hạt nhân:
- RandomFourierTính năngMapper
- KernelPhân loại tuyến tính
Ở phần đầu tiên, bạn đã học được rằng cần phải chuyển đổi không gian chiều thấp thành không gian chiều cao bằng cách sử dụng hàm nhân (kernel function). Chính xác hơn, bạn sẽ sử dụng các đặc trưng Fourier ngẫu nhiên, xấp xỉ hàm Gaussian. TensorFlow 1.x cung cấp bản đồ đó.ping như RandomFourierFeatureMapper, và mô hình có thể được huấn luyện bằng cách sử dụng bộ ước lượng KernelLinearClassifier.
Để xây dựng mô hình, bạn sẽ làm theo các bước sau:
- Đặt chức năng hạt nhân kích thước cao
- Đặt siêu tham số L2
- Xây dựng mô hình
- Đào tạo mô hình
- Đánh giá mô hình
Bước A) Thiết lập hàm Kernel đa chiều
Tập dữ liệu hiện tại chứa 14 đặc trưng mà bạn sẽ chuyển đổi thành một vectơ mới có 5,000 chiều. Bạn sử dụng các đặc trưng Fourier ngẫu nhiên để thực hiện phép biến đổi. Nếu bạn nhớ lại công thức hạt nhân Gaussian, bạn sẽ thấy có một tham số độ lệch chuẩn cần xác định. Tham số này kiểm soát thước đo độ tương đồng được sử dụng trong quá trình phân loại: độ lệch chuẩn nhỏ khiến hạt nhân chỉ coi các điểm rất gần nhau là tương đồng, trong khi độ lệch chuẩn lớn làm mịn ranh giới quyết định.
Bạn có thể điều chỉnh tất cả các tham số trong RandomFourierFeatureMapper bằng:
- đầu vào_dim = 14
- đầu ra_dim = 5000
- độ lệch chuẩn = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Bạn cần xây dựng trình ánh xạ kernel bằng cách sử dụng các cột tính năng được tạo trước đó: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Bước B) Thiết lập siêu tham số L2
Để ngăn ngừa hiện tượng quá khớp (overfitting), bạn sẽ điều chỉnh hàm mất mát bằng bộ điều chỉnh L2. Bạn đặt siêu tham số L2 là 0.1 và tốc độ học là 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Bước C) Xây dựng mô hình
Bước tiếp theo tương tự như phân loại tuyến tính. Bạn sử dụng bộ ước lượng tích hợp sẵn KernelLinearClassifier. Lưu ý rằng bạn thêm bộ ánh xạ kernel đã được định nghĩa trước đó và thay đổi thư mục mô hình.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Các cảnh báo lỗi thời bên dưới là điều bình thường trên TensorFlow 1.x, vì mô-đun kernel_methods được xây dựng dựa trên các bộ ước lượng tf.contrib.learn cũ hơn.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Bước D) Huấn luyện mô hình
Giờ đây, sau khi đã xây dựng xong bộ phân loại Kernel, bạn đã sẵn sàng huấn luyện nó. Bạn chọn lặp lại mô hình 2,000 lần.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Bước E) Đánh giá mô hình
Cuối cùng nhưng không kém phần quan trọng, bạn đánh giá hiệu suất của mô hình của mình. Bạn sẽ có thể đánh bại hồi quy logistic.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
Độ chính xác cuối cùng là 84%, cao hơn khoảng 1.6 điểm phần trăm so với mức cơ sở của hồi quy logistic (0.83975184 so với 0.82353663). Có sự đánh đổi giữa việc cải thiện độ chính xác và chi phí tính toán. Bạn cần cân nhắc xem liệu sự cải thiện đó có đáng với thời gian tiêu tốn bởi bộ phân loại phức tạp hơn hay không và liệu nó có tác động đáng kể đến hoạt động kinh doanh của bạn hay không.
