
PyTorHướng dẫn về học chuyển giao (Transfer Learning) kèm ví dụ
 Evelyn Clarke
⚡ Tóm tắt thông minh
Học chuyển giao (Transfer Learning) tái sử dụng một mạng đã được huấn luyện trên một tập dữ liệu lớn để có thể giải quyết một nhiệm vụ mới, có liên quan với số lượng ảnh được gắn nhãn ít hơn nhiều và thời gian huấn luyện chỉ bằng một phần nhỏ so với ban đầu.
Học chuyển tiếp là gì?
Chuyển giao học tập Đây là kỹ thuật sử dụng một mô hình đã được huấn luyện để giải quyết một nhiệm vụ liên quan khác. Đó là một Machine Learning Phương pháp nghiên cứu này lưu trữ kiến thức thu được khi giải quyết một vấn đề cụ thể và sử dụng chính kiến thức đó để giải quyết một vấn đề khác, tuy khác biệt nhưng có liên quan. Điều này giúp nâng cao hiệu quả bằng cách tái sử dụng thông tin thu thập được từ nhiệm vụ đã học trước đó.
Việc tái sử dụng trọng số của một mô hình mạng khác rất phổ biến vì việc huấn luyện một mạng từ đầu cần một lượng dữ liệu rất lớn. Để giảm thời gian huấn luyện, người ta sử dụng một mạng hiện có cùng với trọng số của nó và sửa đổi lớp cuối cùng để giải quyết vấn đề của riêng mình. Ưu điểm là lớp cuối cùng này có thể được huấn luyện với một tập dữ liệu nhỏ.
Trước khi viết bất kỳ mã Python nàoTorMã ch, việc biết bài toán của bạn thuộc loại Transfer Learning nào sẽ rất hữu ích, vì điều đó quyết định lượng dữ liệu được gắn nhãn mà bạn cần.
Các hình thức học chuyển tiếp
Các tài liệu nghiên cứu chia kỹ thuật này thành ba nhóm. Nhóm nào phù hợp với bạn phụ thuộc vào việc khía cạnh nào của vấn đề được gắn nhãn, chứ không phải vào khung lý thuyết bạn sử dụng.
| Kiểu | Miền nguồn | Target miền | Sử dụng điển hình |
|---|---|---|---|
| Cảm ứng | Được gắn nhãn | Đã được gắn nhãn, nhưng là một nhiệm vụ khác. | Tái định hướng xương sống của ImageNet cho bài toán hai lớp Alien vs. Predator |
| Chuyển đổi | Được gắn nhãn | Không được gắn nhãn, cùng một nhiệm vụ, nhưng phân bố dữ liệu khác nhau. | Thích ứng miền, chẳng hạn như chuyển mô hình từ ảnh chụp trong studio sang ảnh chụp bằng điện thoại. |
| Không được giám sát | Không có nhãn | Không có nhãn | Clusterhoặc giảm chiều dữ liệu khi việc gắn nhãn cho từng bản ghi là không khả thi. |
Ví dụ được xây dựng trong hướng dẫn này là học chuyển giao quy nạp. VGG19 được trang bị kiến thức đã được gán nhãn từ ImageNet, và sau đó được nhắm đến một bài toán phân loại hai lớp đã được gán nhãn mà nó chưa từng gặp trước đây.
Ví dụ tính năngtracSo sánh giữa việc điều chỉnh ban đầu và việc tinh chỉnh
Sau khi chọn được mạng nơ-ron đã được huấn luyện trước, có hai cách để điều chỉnh nó. Sự khác biệt nằm ở số lượng lớp mà bạn cho phép tiếp tục học.
| Yếu tố | Ví dụ về tính năngtracsản xuất | Tinh chỉnh |
|---|---|---|
| Các lớp huấn luyện | Chỉ có bộ phân loại được thay thế | Bộ phân loại cộng với một số hoặc tất cả các khối tích chập |
| requires_grad trên hệ thống xương sống | Sai | Điều này đúng với các khối đang được cập nhật. |
| Dữ liệu cần thiết | Số lượng ảnh ít, thường chỉ vài trăm ảnh mỗi lớp. | Lớn hơn, thường là hàng nghìn |
| Phí luyện tập | Mức thấp nhất, chạy trên CPU | Khi GPU càng mạnh, nó càng trở nên đáng giá. |
| Độ chính xác điển hình | Tốt khi ảnh nguồn và ảnh đích trông giống nhau. | Thường thì sẽ tốt hơn khi hai lĩnh vực khác nhau. |
Các bước dưới đây sử dụng tính năng ví dụtracLưu ý: mọi tham số của VGG19 đều được cố định và chỉ có lớp Linear cuối cùng mới được học. Việc chuyển sang tinh chỉnh chỉ là một thay đổi nhỏ, cụ thể là giữ nguyên requires_grad được đặt thành True trên các khối bạn muốn cập nhật và giảm tốc độ học để các trọng số đã mượn không bị mất.
Đang tải tập dữ liệu
Trước khi bạn bắt đầu sử dụng Transfer Learning với PyTorBạn cần hiểu rõ tập dữ liệu mà bạn sẽ sử dụng. Trong phần Học chuyển giao (Transfer Learning) bằng Python này, bạn cần hiểu rõ tập dữ liệu mà bạn sẽ sử dụng.TorVí dụ, bạn sẽ phân loại người ngoài hành tinh và kẻ săn mồi từ gần 700 hình ảnh. Với kỹ thuật này, bạn không thực sự cần một lượng dữ liệu lớn để huấn luyện. Bạn có thể tải xuống bộ dữ liệu từ... Kaggle: Người ngoài hành tinh đấu với kẻ săn mồi.
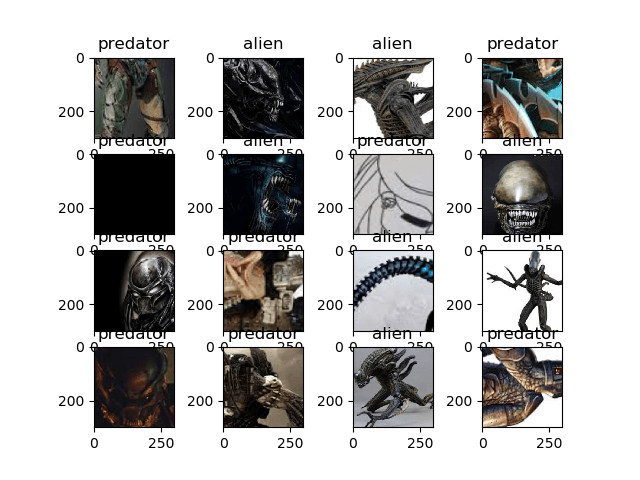
Bộ sưu tập này được lựa chọn một cách có chủ đích với quy mô nhỏ, và một số hình ảnh tiêu biểu trong đó được hiển thị bên dưới.

Nguồn: Alien vs. Predator Kaggle
Tiếp theo trong loạt bài Py nàyTorTrong bài hướng dẫn về Học chuyển giao (Transfer Learning), bạn sẽ học cách áp dụng Học chuyển giao với Python.Tortừng bước một.
Làm thế nào để sử dụng phương pháp học chuyển tiếp?
Dưới đây là quy trình từng bước về cách sử dụng Học chuyển giao (Transfer Learning) cho Học sâu (Deep Learning) với Python.Torch:
Bước 1) Tải dữ liệu
Bước đầu tiên là tải dữ liệu và áp dụng một số phép biến đổi cho hình ảnh để chúng đáp ứng các yêu cầu của mạng.
Bạn sẽ tải dữ liệu từ thư mục torchvision.datasets. Mô-đun sẽ lặp qua thư mục để chia dữ liệu thành tập huấn luyện và tập xác thực. Quy trình chuyển đổi được sử dụng ở đây sẽ cắt ảnh từ tâm, chuyển đổi chúng thành tensor và chuẩn hóa chúng. Học kĩ càng.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
Bây giờ hãy trực quan hóa tập dữ liệu. Bước trực quan hóa sẽ lấy lô hình ảnh và nhãn tiếp theo từ trình tải dữ liệu huấn luyện và hiển thị chúng bằng Matplotlib.
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
Việc chạy đoạn mã đó sẽ vẽ ra một lưới bốn nhân bốn gồm các hình ảnh huấn luyện, mỗi hình ảnh được đặt tên theo tên lớp mà trình tải trả về.
Bước 2) Xác định mô hình
Trong quy trình Học sâu này, bạn sẽ sử dụng VGG19 từ mô-đun torchvision.
Bạn sẽ sử dụng torchvision.models để tải VGG19 với các trọng số được huấn luyện trước đã được bật. Sau đó, bạn đóng băng các lớp để chúng không thể huấn luyện được nữa. Tiếp theo, bạn sửa đổi lớp cuối cùng bằng một lớp tuyến tính phù hợp với bài toán, ở đây có nghĩa là 2 lớp. Hàm mất mát được sử dụng là CrossEntropyLoss, và bộ tối ưu hóa là SGD với tốc độ học là 0.001 và động lượng là 0.9, như được hiển thị trong mã Py bên dưới.TorVí dụ về học chuyển giao (Transfer Learning).
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
Ghi chú phiên bản: các đã được huấn luyện trước = Đúng Lập luận đó vẫn hoạt động nhưng đã bị thay thế kể từ phiên bản torchvision 0.13 bởi... trọng lượng lập luận, vì vậy các bản cài đặt mới hơn mong đợi torchvision.models.vgg19(weights=VGG19_Weights.DEFAULT) và in ra cảnh báo lỗi thời nếu không. Cả hai dạng đều tải cùng một trọng số ImageNet.
Cấu trúc mô hình đầu ra
Việc in mô hình sẽ trả về toàn bộ đồ thị VGG19. Hãy đọc dòng cuối cùng của khối phân loại để xác nhận việc hoán đổi đã thành công: giờ đây nó tạo ra 2 đầu ra thay vì 1,000 lớp ImageNet.
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
Bước 3) Đào tạo và thử nghiệm mô hình
Chúng ta sẽ sử dụng một số hàm từ đây. PyTorHướng dẫn ch để giúp chúng tôi đào tạo và đánh giá mô hình của mình.
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
Cuối cùng, trong phần Học chuyển giao (Transfer Learning) này của Python, ta cóTorVí dụ, bắt đầu quá trình huấn luyện với số lượng epoch là 25 và đánh giá mạng sau đó. Ở mỗi bước huấn luyện, mô hình nhận đầu vào và dự đoán đầu ra. Kết quả dự đoán được chuyển đến tiêu chí để tính toán tổn thất, thuật toán lan truyền ngược tính toán độ dốc, và bộ tối ưu hóa cập nhật trọng số bằng autograd.
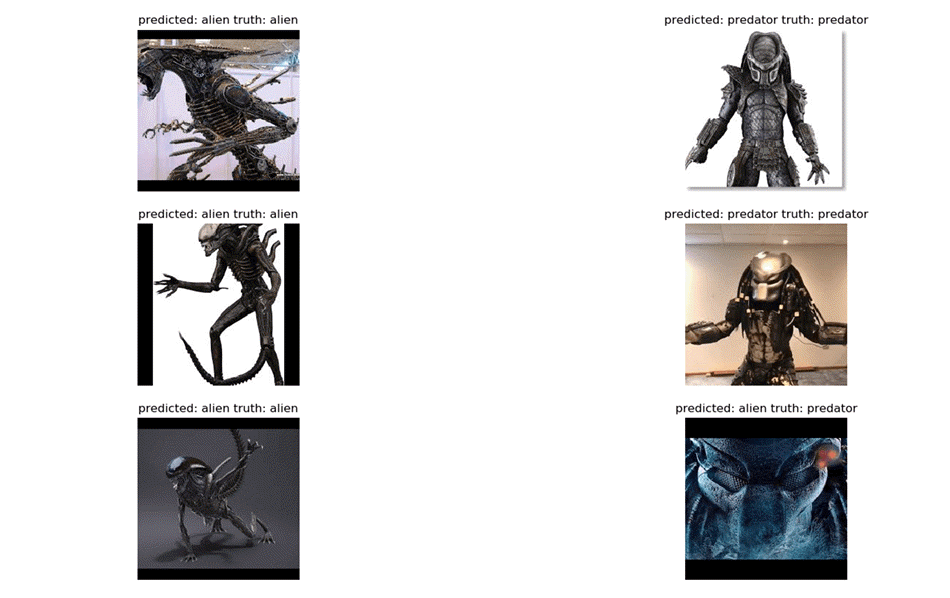
Trong chức năng trực quan hóa, mạng đã được huấn luyện sẽ được kiểm tra với một loạt hình ảnh để dự đoán nhãn, và kết quả được vẽ bằng Matplotlib.
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
Bước 4) Kết quả
Độ chính xác được báo cáo cho lần chạy này là 92%. Nhật ký được in ra ở cuối quá trình huấn luyện hiển thị tổn thất trong hai epoch cuối cùng cùng với tổng thời gian huấn luyện.
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
Sau đó, các dự đoán của mô hình được trực quan hóa bằng Matplotlib, như hình bên dưới.
Những lỗi thường gặp trong học chuyển giao và cách khắc phục chúng
Hầu hết các lỗi trong kịch bản học chuyển giao đều mang tính cơ học hơn là toán học. Dưới đây là những lỗi khiến đoạn mã trên không chạy được, và ý nghĩa của từng lỗi.
- Sự không khớp về kích thước ở lớp cuối cùng: Lớp tuyến tính được thay thế phải chấp nhận các đặc trưng đầu vào được báo cáo bởi bộ phân loại ban đầu và phát ra chính xác len(class_names) đầu ra. Việc in mô hình, như trong Bước 2, là cách nhanh nhất để xác nhận cả hai con số.
- Xương sống chưa bao giờ bị đóng băng: Nếu tham số requires_grad được để ở True, mọi tham số của VGG19 sẽ được cập nhật và quá trình chạy sẽ chậm đi rất nhiều trên CPU. Hãy đặt nó thành False trước khi thay thế bộ phân loại.
- Sai lệch chuẩn hóa: Giá trị trung bình và độ lệch chuẩn được sử dụng trong các phép biến đổi. Chuẩn hóa phải có cùng giá trị ở thời điểm huấn luyện và suy luận, nếu không các dự đoán sẽ bị sai lệch mà không có lý do rõ ràng.
- Tham số trọng số đã lỗi thời: Trên torchvision 0.13 trở lên, pretrained=True sẽ hiển thị cảnh báo lỗi thời và kiểu liệt kê weights được ưu tiên sử dụng.
- số lượng công nhân trên Windows và sổ tay: Một DataLoader với num_workers=4 cần điểm vào được bảo vệ, vì vậy hãy đặt num_workers=0 nếu Python Gây ra lỗi khi khởi tạo hoặc lưu trữ dữ liệu.
- Đánh giá trong chế độ huấn luyện: Hãy gọi model.eval() trước khi chấm điểm để Dropout và BatchNorm hoạt động một cách xác định, và chuyển lại bằng model.train() sau đó.
