
Учебное пособие по Apache Flume: что такое, ArchiПример tecture и Hadoop
 Прафулла Ранадив
⚡ Умное резюме
Apache Flume — это распределенный сервис для сбора, агрегирования и перемещения больших объемов лог-данных в HDFS, построенный на основе агентов, которые объединяют источник, канал и приемник.
Что такое Apache Flume в Hadoop?
Apache Flume — это надежная распределенная система для сбора, агрегирования и передачи больших объемов данных журналов. Она имеет простую, но гибкую архитектуру, основанную на потоковых данных. Apache Flume используется для сбора данных журналов, содержащихся в файлах журналов веб-серверов, и их агрегирования в единую систему. HDFS для анализа.
Flume в Hadoop поддерживает множество источников, включая:
- 'tail' (которая перенаправляет данные из локального файла в HDFS через Flume, аналогично команде Unix 'tail')
- Системные журналы
- Апач log4j (что позволяет Java приложения для записи событий в файлы в HDFS через Flume).
Текущая версия Flume 1.11.0Опубликовано 25 октября 2022 года и доступно по адресу: Страница загрузки Apache FlumeДанное руководство написано для версии 1.4.0, поэтому в нескольких шагах ниже указано, что в более новых версиях программа работает иначе.
акведук Archiтекстура
Агент Flume — это JVM Процесс, состоящий из трех компонентов – источника в водоотводном канале, водоотводного канала и водоотводного канала – через которые события распространяются после инициирования во внешнем источнике. На приведенной ниже диаграмме показано, как они соединены.
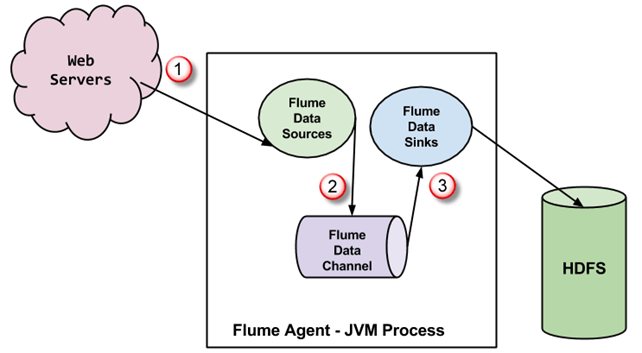
- События, генерируемые внешним источником (веб-сервером), обрабатываются источником Flume. Внешний источник отправляет события источнику Flume в формате, который распознается целевым источником.
- Источник Flume получает событие и сохраняет его в одном или нескольких каналах. Канал выступает в качестве хранилища, которое хранит событие до тех пор, пока оно не будет обработано приемником Flume. Для хранения этих событий канал может использовать локальную файловую систему.
- Приемник Flume удаляет событие из канала и сохраняет его во внешнем хранилище, например, HDFS. Может быть несколько агентов Flume, в этом случае приемник Flume пересылает событие источнику Flume следующего агента в потоке.
Некоторые важные особенности водоотводного канала
- Flume имеет гибкую архитектуру, основанную на потоковой передаче данных. Он отказоустойчив и надежен, с множеством механизмов переключения на резервный сервер и восстановления. Flume предлагает различные уровни надежности, включая «доставка с максимальной эффективностью» и «сквозная доставка». лучшие-усилия доставка не допускает сбоев узлов Flume, тогда как сквозная доставка Гарантирует доставку даже в случае множественных сбоев узлов.
- Flume передает данные между источниками и приемниками. Сбор данных может осуществляться как по расписанию, так и по событиям. Flume имеет собственный механизм обработки запросов, что упрощает преобразование каждой новой партии данных перед ее передачей в целевой приемник.
- Возможное Раковины с лотком включают HDFS и HBaseFlume также может передавать данные о событиях, такие как данные о сетевом трафике, данные, генерируемые сайтами социальных сетей, и электронные письма.
Настройка Flume, библиотеки и исходного кода
Прежде чем приступить к самому процессу, убедитесь, что у вас установлен Hadoop; если нет, выполните следующие действия. Как установить Hadoop Во-первых, смените пользователя на 'hduser' (идентификатор, использованный при настройке Hadoop; вы можете переключиться на идентификатор пользователя, использованный при настройке вашего собственного Hadoop).

Шаг 1) Создайте новую директорию с именем 'FlumeTutorial'.
sudo mkdir FlumeTutorial
- Предоставьте права на чтение, запись и выполнение.
sudo chmod -R 777 FlumeTutorial
- Скопируйте файлы MyTwitterSource.java и MyTwitterSourceForFlume.java в эту директорию.
Загрузите исходные файлы отсюда
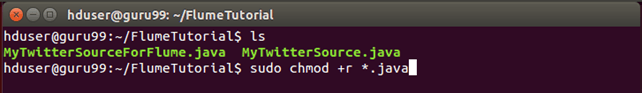
Проверьте права доступа ко всем этим файлам, как показано ниже, и предоставьте разрешение на чтение, если оно отсутствует.
Шаг 2) Скачайте Apache Flume по ссылке: https://flume.apache.org/download.html.
В этом руководстве по Flume использовалась Apache Flume 1.4.0.

Далее перейдите по ссылке на зеркало.

Шаг 3) Скопируйте загруженный архив в выбранную вами директорию и выполните команду:tracПросмотрите содержимое, используя следующую команду.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

Это создаст новую директорию с именем apache-flume-1.4.0-bin и extracфайлы помещаются в эту директорию. Эта директория называется в остальной части статьи.
Шаг 4) Настройка библиотеки Flume. Скопируйте файлы twitter4j-core-4.0.1.jar, flume-ng-configuration-1.4.0.jar, flume-ng-core-1.4.0.jar и flume-ng-sdk-1.4.0.jar в папку
/либ/
У одного или всех скопированных JAR-файлов может быть установлено разрешение на выполнение, что может вызвать проблемы с компиляцией кода, поэтому отзовите это разрешение. В моем случае разрешение на выполнение было у файла twitter4j-core-4.0.1.jar. Я отозвал его, как показано ниже.
sudo chmod -x twitter4j-core-4.0.1.jar

После этого приведенная ниже команда предоставляет всем пользователям права на чтение файла twitter4j-core-4.0.1.jar.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
Обратите внимание, что я скачал файл twitter4j-core-4.0.1.jar из [ссылка на файл]. Репозиторий Mavenи все JAR-файлы Flume, например, flume-ng-*-1.4.0.jar, из артефакты org.apache.flume.
Загрузка данных из Twitter с помощью Flume
Шаг 1) Перейдите в каталог, содержащий файлы исходного кода.
Шаг 2) Установите переменную CLASSPATH так, чтобы она содержала /lib/* и ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

Шаг 3) Скомпилируйте исходный код, используя приведенную ниже команду.
javac -d . MyTwitterSourceForFlume.java MyTwitterSource.java

Шаг 4) Создайте JAR-файл. Сначала создайте файл Manifest.txt с помощью любого текстового редактора и добавьте в него следующую строку.
Main-Class: flume.mytwittersource.MyTwitterSourceForFlume
Здесь flume.mytwittersource.MyTwitterSourceForFlume — это имя основного класса. Обратите внимание, что в конце этой строки необходимо нажать клавишу Enter, как показано ниже.

Теперь создайте JAR-файл 'MyTwitterSourceForFlume.jar' следующим образом.
jar cfm MyTwitterSourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

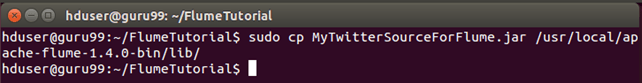
Шаг 5) Скопируйте этот JAR-файл в /lib/.
sudo cp MyTwitterSourceForFlume.jar <Flume Installation Directory>/lib/
Шаг 6) Перейдите в каталог конфигурации Flume, /conf.
Если файл flume.conf отсутствует, скопируйте файл flume-conf.properties.template и переименуйте его в flume.conf.
sudo cp flume-conf.properties.template flume.conf

Если файл flume-env.sh отсутствует, скопируйте файл flume-env.sh.template и переименуйте его в flume-env.sh.
sudo cp flume-env.sh.template flume-env.sh

Создание приложения Twitter
Прочитайте это первым. Потоковая передача версии 1.1 statuses/filter Конечная точка, необходимая для twitter4j 4.0.1, была выведена из эксплуатации 9 марта 2023 года, а заменивший её API v2 filtered stream теперь доступен по адресу developer.x.com, доступен только по платному тарифу. Рассматривайте приведенные ниже скриншоты как шаблон пользовательского источника, а затем направьте тот же агент на файл, исполняемый файл или источник Kafka.
Шаг 1) Создайте приложение для Twitter, войдя в портал для разработчиков.


Шаг 2) Перейдите в раздел «Мои приложения» (этот пункт появляется при нажатии на кнопку «Яйцо» в правом верхнем углу).

Шаг 3) Создайте новое приложение, нажав кнопку «Создать новое приложение».
Шаг 4) Заполните поля с данными заявки, указав название заявки, описание и веб-сайт. Вы можете обратиться к примечаниям, приведенным под каждым полем ввода.
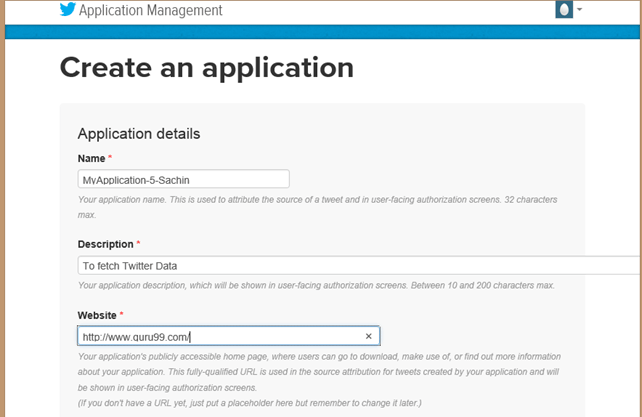
Шаг 5) Прокрутите страницу вниз, примите условия, отметив «Да, я согласен», и нажмите кнопку «Создать приложение Twitter».

Шаг 6) В окне только что созданного приложения перейдите на вкладку «Ключи API», прокрутите страницу вниз и нажмите кнопку «Создать мой токен доступа».


Шаг 7) Обновите страницу.
Шаг 8) Нажмите на кнопку «Проверить OAuth». Это отобразит настройки OAuth приложения.

Шаг 9) Измените файл 'flume.conf', используя следующие настройки OAuth. Ниже приведены шаги по изменению файла 'flume.conf'.

Для обновления файла 'flume.conf' нам необходимо скопировать ключ потребителя, секрет потребителя, токен доступа и секрет токена доступа.
Примечание: Эти значения принадлежат пользователю и, следовательно, являются конфиденциальными, поэтому их не следует разглашать.
Измените файл flume.conf.
Шаг 1) Откройте файл 'flume.conf' в режиме записи и задайте значения для параметров, указанных ниже.
sudo gedit flume.conf
Скопируйте содержимое ниже.
MyTwitAgent.sources = Twitter
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.Twitter.type = flume.mytwittersource.MyTwitterSourceForFlume
MyTwitAgent.sources.Twitter.channels = MemChannel
MyTwitAgent.sources.Twitter.consumerKey = <Copy consumer key value from Twitter App>
MyTwitAgent.sources.Twitter.consumerSecret = <Copy consumer secret value from Twitter App>
MyTwitAgent.sources.Twitter.accessToken = <Copy access token value from Twitter App>
MyTwitAgent.sources.Twitter.accessTokenSecret = <Copy access token secret value from Twitter App>
MyTwitAgent.sources.Twitter.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

Шаг 2) Кроме того, установите значение параметра TwitterAgent.sinks.HDFS.hdfs.path, как показано ниже.
TwitterAgent.sinks.HDFS.hdfs.path = hdfs:// : / /флюм/твиты/

Найти , и См. значение параметра 'fs.defaultFS', установленного в файле $HADOOP_HOME/etc/hadoop/core-site.xml, показанное ниже.

Шаг 3) Для того чтобы данные автоматически сбрасывались в HDFS по мере их поступления, удалите указанную ниже запись, если она существует.
TwitterAgent.sinks.HDFS.hdfs.rollInterval = 600
Пример: потоковая передача данных Twitter с помощью Flume
Шаг 1) Откройте файл 'flume-env.sh' в режиме записи и задайте значения для параметров, указанных ниже.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/MyTwitterSourceForFlume.jar"

Шаг 2) Запустите Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Шаг 3) Два JAR-файла из архива Flume несовместимы с Hadoop 2.2.0, поэтому в этом примере Apache Flume мы выполним описанные ниже шаги, чтобы сделать Flume совместимым с Hadoop 2.2.0. Эта замена JAR-файлов — исправление, относящееся к версии 1.4.0; Flume 1.11.0 уже включает в себя актуальные сборки protobuf и Guava, поэтому современный архив обычно в этом не нуждается.
а. Переместите файл protobuf-java-2.4.1.jar из ' /lib'. Сначала перейдите в этот каталог.
CD /lib
sudo mv protobuf-java-2.4.1.jar ~/

b. Найдите JAR-файл 'guava', как показано ниже.
find . -name "guava*"

Переместите файл guava-10.0.1.jar из ' /lib'.
sudo mv guava-10.0.1.jar ~/

c. Скачайте файл guava-17.0.jar с сайта Репозиторий Maven, показано ниже.

Теперь скопируйте этот загруженный JAR-файл в ' /lib'.
Шаг 4) Перейти к ' /bin' и запустите Flume следующим образом.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

Окно командной строки, через которое Flume получает твиты, выглядит следующим образом.

Из сообщения в командной строке видно, что вывод записывается в каталог /user/hduser/flume/tweets/. Теперь откройте этот каталог в веб-браузере.
Шаг 5) Чтобы увидеть результат загрузки данных, откройте в браузере http://localhost:50070/, просмотрите файловую систему, а затем перейдите в каталог, куда были загружены данные, то есть
/флум/твиты/
Порт 50070 — это веб-интерфейс NameNode в Hadoop 2; в Hadoop 3 эта же страница была перенесена на порт 9870.

Поток воды составляет половину потребляемой пищи: Скуп Flume импортирует таблицы партиями, затем передает потоковые события. Свинья or Hive придайте файлам нужную форму и Узи Планирует цепочку. См. также инструменты аналитики больших данных, Объединения и счетчики MapReduce и Talend.
