
Учебное пособие по Hadoop Pig: что такое Apache Pig? Archiтектура, пример
 Прафулла Ранадив
⚡ Умное резюме
Apache Pig — это высокоуровневая платформа для анализа больших наборов данных в Hadoop, сочетающая язык потоков данных Pig Latin с средой выполнения, которая компилирует каждый скрипт в MapReduce, Tez или Spark автоматические задания.
В этом руководстве сначала рассматривается идея Apache Pig, а затем подробно описывается процесс его установки и запуска полноценного скрипта на языке Pig Latin от начала до конца.
Что такое Apache Pig?
Свинья — это высокоуровневый персонаж. язык программирования Полезно для анализа больших наборов данных. Pig — результат работы разработчиков в Yahoo!
В рамках MapReduce программы необходимо преобразовывать в последовательность этапов Map и Reduce. Однако эта модель программирования не знакома аналитикам данных. Поэтому, чтобы преодолеть этот разрыв, был разработан абстракционный подход.tracКомплекс под названием «Свинья» был построен на вершине Hadoop.
Apache Pig позволяет людям больше сосредоточиться на анализе больших объемов данных и тратить меньше времени на написание программ MapReduce. Подобно свиньям, которые едят все подряд, язык программирования Apache Pig разработан для работы с любыми типами данных. Именно поэтому он и называется Pig! Талисман проекта, изображенный ниже, подчеркивает эту идею.

Проект всё ещё активен. Apache Pig 0.18.0 Выпущена 15 сентября 2025 года и добавляет поддержку Hadoop 3, Tez 0.10, Hive 3. Spark 3, HBase 2 и Python 3, согласно Страница релизов Apache PigПриведённое ниже пошаговое руководство изначально было написано для гораздо более старой версии 0.12.1, поэтому в некоторых шагах указано, что в более новых версиях всё работает иначе.
Свинья Archiтекстура
Архитектура Pig состоит из двух компонентов:
- Свинья латынь, какой язык
- Среда выполнения, для проведения программ на языке поросячьей латыни.
Программа на языке Pig Latin состоит из ряда операций или преобразований, применяемых к входным данным для получения выходных данных. Эти операции описывают поток данных, который преобразуется в исполняемое представление средой выполнения Hadoop Pig. В основе этих преобразований лежит ряд Уменьшение карты задачи, о которых программист не знает. Таким образом, в некотором смысле Pig в Hadoop позволяет программисту сосредоточиться на данных, а не на характере выполнения.
«Пиглатин» — сравнительно строгий язык, использующий знакомые ключевые слова из области обработки данных, например, «объединение», «группировка» и «фильтр». Диаграмма ниже. tracЭто скрипт, проходящий через оболочку Grunt, парсер, оптимизатор и компилятор на пути к исполняемому движку.

Режимы выполнения
Pig в Hadoop имеет два режима выполнения, и в приведенном ниже пошаговом руководстве по установке используются оба из них:
- Локальный режим: В этом режиме язык Hadoop Pig работает в одном экземпляре. JVM и использует локальную файловую систему. Этот режим подходит только для анализа небольших наборов данных с помощью Pig в Hadoop.
- Режим MapReduce: В этом режиме запросы, написанные на Pig Latin, преобразуются в задания MapReduce и выполняются в кластере Hadoop (кластер может быть псевдораспределенным или полностью распределенным). Режим MapReduce с полностью распределенным кластером полезен для запуска Pig на больших наборах данных.
Эти два варианта — классическая пара. В текущих версиях фактически доступны шесть типов выполнения, или exectype, каждый из которых выбирается с помощью одного и того же параметра. -x флаг, как это задокументировано в Руководство по началу работы с Pig 0.18.0.
| Исполнительный тип | Command | Где проходит работа |
|---|---|---|
| Местное | pig -x local | Единая JVM, работающая с локальной файловой системой. |
| местный Тез | pig -x tez_local | Одна JVM, использующая среду выполнения Tez (экспериментальная версия). |
| Spark локальным | pig -x spark_local | Единая JVM, использующая Spark среда выполнения (экспериментальная) |
| Уменьшение карты | pig or pig -x mapreduce | Кластер Hadoop с HDFS; это значение по умолчанию. |
| Tez | свинья -х тез | Кластер Hadoop, работающий под управлением движка Tez. |
| Spark | свинья -x искра | A SparkКластер YARN или Mesos с HDFS |
Типы данных в стиле «свиной латыни» и OperaTORs
Прежде чем писать скрипт, полезно знать, что может хранить Pig и что он может с этим делать. Модель данных полностью вложенная, что позволяет Pig читать файлы журналов и другие слабо структурированные входные данные, которые реляционная таблица отклонила бы.
В «свиной латыни» представлены два семейства типов:
- Скалярные типы:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerиbigdecimalВ приведенном ниже примере скрипта каждый столбец объявляется какchararray. - Сложные типы: a кортеж представляет собой упорядоченный набор полей и ведет себя как строка; сумка представляет собой неупорядоченную коллекцию кортежей и ведёт себя как таблица; карта представляет собой набор пар ключ-значение, ключом которого должен быть
chararray.
Операторы занимают небольшое количество должностей, и лишь немногие из них обслуживают практически все типы трубопроводов:
| оператор | Что она делает |
|---|---|
| ЗАГРУЗИТЬ / ХРАНИТЬ | Прочитать данные из файловой системы и записать результат обратно. |
| ФИЛЬТР | Оставляйте только те кортежи, которые соответствуют условию. |
| ДЛЯ КАЖДОГО … СГЕНЕРИРОВАТЬ | Работайте столбец за столбцом, создавая новые поля. |
| ГРУППА / СОГРУППА | Сгруппируйте одно, два или более отношений по ключу. |
| РЕГИСТРАЦИЯ | Объедините связи с помощью внутреннего или внешнего соединения. |
| СОЮЗ / РАЗДЕЛЕНИЕ | Объединить отношения или разделить одно на несколько. |
| Сортировать по / Уникальный / Лимит | Отсортировать, удалить дубликаты и ограничить количество кортежей. |
| ОПИСАТЬ / ОБЪЯСНИТЬ / ИЛЛЮСТРИРОВАТЬ | Проверьте результаты, схемы, планы выполнения и примеры запусков. |
Четыре оператора инспекции также используют упрощенные алгоритмы Grunt, что позволяет экономить время.ping во время отладки: \d для DUMP, \de для DERIBE, \e для ОБЪЯСНЕНИЯ и \i для ИЛЛЮСТРАЦИИ.
Предпосылки
Pig — это клиентский инструмент. Он анализирует скрипт, планирует работу и отправляет задания, но не предоставляет собственное хранилище или кластер, поэтому сначала необходимо установить работающий Hadoop. Список требований к Apache невелик.
| Компонент | Требование | Почему это необходимо |
|---|---|---|
| Hadoop | Hadoop 2.x или 3.x, с экспортированной переменной HADOOP_HOME. | Предоставляет HDFS и механизм выполнения. Без HADOOP_HOME Pig 0.18.0 переключается на встроенный Hadoop 2.7.3. |
| Java | Java Версия 1.7 или более поздняя, с переменной JAVA_HOME, установленной в корневой каталог установки. | Pig и демоны Hadoop — это Java программы |
| Python (опционально) | Python 2.7 | Требуется только для потоковой передачи. Python определяемые пользователем функции |
| Муравей (необязательно) | Муравей 1.8 | Требуется только при сборке или перекомпиляции Pig из исходного кода. |
В дополнение к этому списку следует отметить два практических момента. Во-первых, запускайте все от имени пользователя Linux, у которого уже есть домашний каталог в указанной директории. HDFS и разрешение на запись в него; в этом руководстве используется hduserВо-вторых, запустите кластер перед запуском Pig в режиме MapReduce, поскольку Pig немедленно завершит работу с ошибкой, если NameNode и ResourceManager будут недоступны. Если Hadoop еще не установлен, выполните следующие действия: Как установить Hadoop первый.
Как скачать и установить Pig
Теперь в этом руководстве по Apache Pig мы узнаем, как загрузить и установить Pig:
Прежде чем приступить к самому процессу, убедитесь, что у вас установлен Hadoop. Измените пользователя на 'hduser' (идентификатор, использованный при настройке Hadoop; вы можете переключиться на идентификатор пользователя, использованный при настройке вашего собственного Hadoop).

Шаг 1) Загрузите стабильную последнюю версию Pig Hadoop с любого из доступных зеркальных сайтов по адресу:
https://pig.apache.org/releases.html
Выберите для загрузки файл tar.gz (а не src.tar.gz), как показано ниже.

Шаг 2) После завершения загрузки перейдите в каталог, содержащий загруженный tar-архив, и переместите его в место, где вы хотите установить Pig Hadoop. В данном случае мы переместим его в /usr/local.

Перейдите в каталог, в котором будут находиться файлы Pig Hadoop.
cd /usr/local
ExtracСодержимое tar-архива представлено ниже.
sudo tar -xvf pig-0.12.1.tar.gz

Шаг 3) Измените файл ~/.bashrc, чтобы добавить переменные окружения, связанные с Pig.
Откройте файл ~/.bashrc в любом текстовом редакторе и внесите указанные ниже изменения.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Шаг 4) Теперь выполните команду `source` для получения конфигурации среды, используя приведенную ниже команду.
. ~/.bashrc

Шаг 5) Нам необходимо перекомпилировать Pig для поддержки Hadoop 2.2.0.
Вот шаги, которые необходимо выполнить.
Перейдите в главный каталог Pig.
cd $PIG_HOME
Установите Ant.
sudo apt-get install ant

Примечание: Загрузка начнётся и займёт время, зависящее от скорости вашего интернет-соединения.
Перекомпилируйте Pig.
sudo ant clean jar-all -Dhadoopversion=23

Обратите внимание, что в процессе перекомпиляции загружается несколько компонентов, поэтому система должна быть подключена к интернету.
Кроме того, если этот процесс зависнет где-нибудь, и вы не увидите никаких изменений в командной строке более 20 минут, нажмите Ctrl + c и повторно выполните ту же команду.
В нашем случае это занимает 20 минут.

Этот этап перекомпиляции относится к эпохе 0.12.1, когда поставляемые JAR-файлы были собраны для Hadoop 1 и... -Dhadoopversion=23 Флаг изменил сборку Ant на версии Hadoop 0.23 и 2.x. Apache Pig 0.18.0 поставляется с бинарными файлами, которые уже работают на Hadoop 2.7 и выше, а также на Hadoop 3, поэтому в текущей версии вы обычно можете распаковать архив и сразу перейти к тесту ниже.
Шаг 6) Проверьте установку Pig с помощью команды.
pig -help

Пример сценария свиньи
После установки Pig оставшаяся часть этого руководства по Apache Pig запускает полноценный скрипт. Мы будем использовать скрипты Pig, чтобы узнать количество проданных товаров в каждой стране.
Входные данные: Наш входной набор данных представляет собой CSV-файл. Продажиянварь2009.csv.
Шаг 1) Запустите Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Шаг 2) В больших данных Pig принимает файл из HDFS в режиме MapReduce и сохраняет результаты обратно в HDFS.
Скопируйте файл SalesJan2009.csv (хранящийся в локальной файловой системе по адресу ~/input/SalesJan2009.csv) в домашний каталог HDFS (Hadoop Distributed File System).
В этом примере с Apache Pig файл находится во входной папке. Если файл хранится в другом месте, укажите это имя.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Проверьте, был ли файл действительно скопирован.
$HADOOP_HOME/bin/hdfs dfs -ls /

Шаг 3) Конфигурация свиньи.
Сначала перейдите в каталог $PIG_HOME/conf и сохраните копию исходного файла свойств.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Откройте файл pig.properties с помощью любого текстового редактора и укажите путь к файлу журнала, используя параметр pig.logfile.
sudo gedit pig.properties

Программа для регистрации ошибок будет использовать этот файл.
Шаг 4) Выполните команду 'pig', которая запустит командную строку Pig — интерактивную оболочку для запросов к Pig.
pig

Шаг 5) В командной строке Grunt для Pig выполните следующие команды Pig в указанном порядке.
— A. Загрузите файл, содержащий данные.
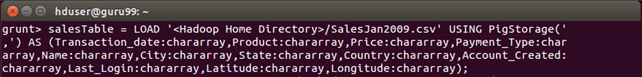
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Нажмите Enter после этой команды.
— Б. Сгруппируйте данные по полю «Страна».
GroupByCountry = GROUP salesTable BY Country;

— C. Для каждого кортежа в 'GroupByCountry' сгенерируйте результирующую строку вида «Название страны: Количество проданных товаров».
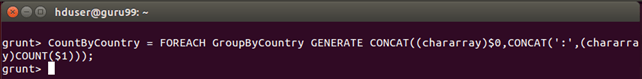
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Нажмите Enter после этой команды.
— D. Сохраните результаты потока данных в каталоге 'pig_output_sales' в HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Выполнение этой команды займет некоторое время. После завершения вы должны увидеть следующий экран.

Шаг 6) Результат можно увидеть через командный интерфейс следующим образом:
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Результаты также можно просмотреть через веб-интерфейс.
Откройте http://localhost:50070/ в веб-браузере.
Порт 50070 — это веб-интерфейс NameNode в Hadoop 2. В Hadoop 3 эта же страница была перенесена на порт 9870, поэтому используйте этот адрес, если ваш кластер работает под управлением Hadoop 3.

Теперь выберите «Просмотреть файловую систему» и перейдите к каталогу /user/hduser/pig_output_sales.

Откройте part-r-00000, чтобы прочитать пары «страна» и «количество товаров», созданные скриптом.

Apache Pig против Hive против MapReduce
Понятие «Свинья» редко оценивается само по себе. Обычно задают вопрос, относится ли та или иная должность к категории «Свинья», в контексте... Hive или в написанной вручную программе MapReduce, поскольку все три варианта в конечном итоге становятся заданиями в одном и том же кластере.
| Аспект | MapReduce (Java) | Апачская свинья | Апачский улей |
|---|---|---|---|
| Интерфейс | Java API | Pig Latin — язык сценариев для обработки потоков данных. | HiveQLдиалект SQL |
| Уровень абсtracпроизводство | Низкий | Средний | Высокий |
| Типичный пользователь | Java разработчик | Инженер по обработке данных или исследователь | Аналитик, уверенно владеющий SQL. |
| Подходящие данные | Все обрабатывается вручную. | Структурированные и полуструктурированные; схема является необязательной при загрузке. | Структурированные таблицы, зарегистрированные в метахранилище. |
| Code объем | Большинство линий | Меньше строк | Наименьшее количество строк в запросе |
| Запускается как | Задача MapReduce | Компилируется в MapReduce, Tez или Spark работе | Компилируется в MapReduce, Tez или Spark работе |
| Лучшее в | Полный контроль и возможность настройки логики | Многоэтапные ETL-конвейеры | Создание запросов и отчетов по запросу |
На практике разделение довольно простое. Используйте Hive, когда данные уже выглядят как таблица, а вопрос — как SQL-запрос. Используйте Pig, когда входные данные неструктурированы, когда конвейер представляет собой цепочку преобразований, а не один запрос, или когда один и тот же скрипт должен выполнять ветвление и повторное объединение. Используйте MapReduce только тогда, когда ни один из вариантов абсолютного разделения не подходит.tracЛогику можно выразить, потому что количество строк быстро растет.
Свинья также органично вписывается в остальную экосистему. Совок и Флюм собираем необработанные данные, Pig или Hive обрабатывают их, а затем используется планировщик, например, Апач Сузи объединяет этапы в повторяющийся конвейер. Для более полного понимания того, где эти инструменты могут быть полезны, см. руководство по... большие данные и сводка инструменты для больших данныхДля получения информации о коммерческой альтернативе ETL-процессам, заменяющей написанные вручную скрипты, см. Talend.
