
Nadzorowane uczenie maszynowe: Algorithms, Typy i przykłady
 Zespół redakcyjny
⚡ Inteligentne podsumowanie
Nadzorowane uczenie maszynowe polega na trenowaniu algorytmu na oznaczonych przykładach, dzięki czemu może on przewidywać wyniki dla danych, których nigdy wcześniej nie widział, stosując regresję dla celów numerycznych i klasyfikację dla celów kategorii, takich jak spam lub oszustwa.
Co to jest nadzorowane uczenie maszynowe?
Nadzorowane uczenie maszynowe to algorytm, który uczy się na podstawie oznaczonych danych treningowych, aby pomóc w przewidywaniu wyników dla nieprzewidzianych danych. W uczeniu nadzorowanym maszyna jest trenowana z wykorzystaniem danych, które są dobrze „oznaczone”. Oznacza to, że niektóre dane są już oznaczone poprawnymi odpowiedziami. Można to porównać do uczenia się w obecności przełożonego lub nauczyciela.
Skuteczne budowanie, skalowanie i wdrażanie dokładnych modeli nadzorowanego uczenia maszynowego wymaga czasu i wiedzy technicznej zespołu wysoko wykwalifikowanych analityków danych. Analitycy danych muszą również okresowo przebudowywać modele, aby generowane przez nie wnioski były aktualne nawet w przypadku zmian danych bazowych.
Jak działa uczenie się nadzorowane
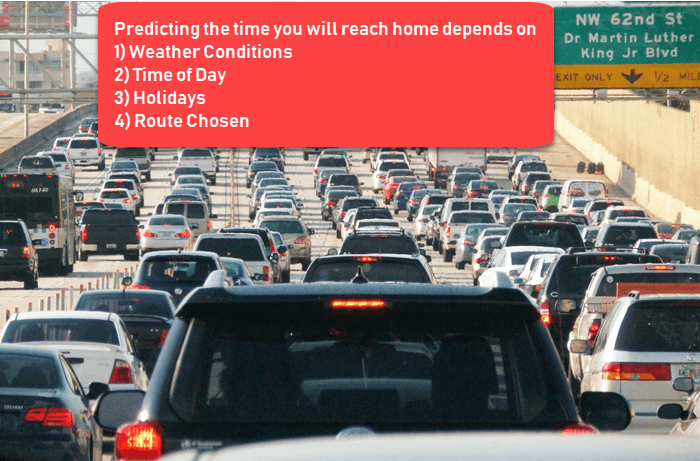
Nadzorowane uczenie maszynowe wykorzystuje zestawy danych szkoleniowych do osiągnięcia pożądanych wyników. Te zestawy danych zawierają dane wejściowe i prawidłowe dane wyjściowe, które pomagają modelowi szybciej się uczyć. Na przykład chcesz przeszkolić maszynę, aby pomogła Ci przewidzieć, ile czasu zajmie Ci dotarcie z miejsca pracy do domu.
Tutaj zaczynasz od utworzenia zestawu oznaczonych etykietami danych. Dane te obejmują:
- Warunki pogodowe
- Pora dnia
- Wakacje
- Wybrana trasa
Wszystkie te dane wejściowe stanowią dane wejściowe w tym przykładzie uczenia nadzorowanego. Dane wyjściowe to czas potrzebny na powrót do domu danego dnia, jak pokazano na poniższym obrazku.
Instynktownie wiesz, że jeśli na zewnątrz pada deszcz, dojazd do domu zajmie ci więcej czasu. Ale maszyna potrzebuje danych i statystyk.
Pierwszą rzeczą, którą musisz utworzyć, jest zbiór treningowy. Będzie on zawierał całkowity czas dojazdu i odpowiadające mu czynniki, takie jak pogoda, czas itp. Na podstawie tego zbioru treningowego Twoja maszyna może zauważyć bezpośredni związek między ilością opadów deszczu a czasem potrzebnym na dotarcie do domu.
Zatem im bardziej pada, tym dłużej będziesz jechać do domu. Może również dostrzec związek między godziną wyjścia z pracy a godziną wyruszenia w drogę. Im bliżej godziny 18:00, tym dłużej zajmie Ci powrót do domu.
Twój komputer może znaleźć niektóre relacje z danymi oznaczonymi etykietami. Ta faza uczenia się jest pokazana poniżej.
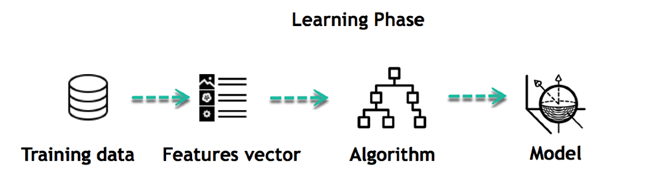
To początek Twojego modelu danych. Zaczyna on rejestrować, jak deszcz wpływa na styl jazdy ludzi i że więcej osób podróżuje w danej porze dnia.
Rodzaje nadzorowanego uczenia maszynowego Algorithms
Poniżej przedstawiono typy algorytmów nadzorowanego uczenia maszynowego:
Regresja
Technika regresji pozwala na prognozowanie pojedynczej ciągłej wartości wyjściowej przy użyciu danych treningowych.
Przykład: możesz użyć regresji, aby przewidzieć cenę domu na podstawie danych szkoleniowych. Zmiennymi wejściowymi będą: lokalizacja, wielkość domu itp.
Mocne strony: Wyniki są łatwe do zinterpretowania, a algorytm można zregularyzować, aby uniknąć nadmiernego dopasowania.
Słabości: Model liniowy nie jest elastyczny, dlatego nie uwzględnia złożonych zależności bez dodawania funkcji.
Oto kilka rodzajów regresji Algorithms:
- Regresja liniowa
- Regresja wielomianowa
- Regresja grzbietowa i lasso
- Regresja logistyczna (do klasyfikacji)
- Regresja drzewa decyzyjnego i lasu losowego
- Regresja wektorów nośnych
Regresja logistyczna:
Regresja logistyczna służy do szacowania wartości dyskretnych na podstawie danego zestawu zmiennych niezależnych. Pomaga ona przewidywać prawdopodobieństwo wystąpienia zdarzenia poprzez dopasowanie danych do funkcji logitowej. Dlatego jest również nazywana regresją logitową. Ponieważ przewiduje ona prawdopodobieństwo, jej wartość wyjściowa mieści się w przedziale od 0 do 1 i może być nieskuteczna w przypadku występowania wielu lub nieliniowych granic decyzyjnych.
Klasyfikacja
Klasyfikacja oznacza grupowanie danych wyjściowych w ramach jednej klasy. Jeśli algorytm próbuje przypisać dane wejściowe do dwóch odrębnych klas, nazywa się to klasyfikacją binarną. Wybór spośród więcej niż dwóch klas nazywa się klasyfikacją wieloklasową.
Przykład: Określenie, czy dana osoba będzie dłużnikiem, czy nie, spłacającym pożyczkę.
Mocne strony: Drzewa klasyfikacyjne sprawdzają się w praktyce bardzo dobrze.
Słabości: Brak ograniczeń, pojedyncze drzewa są podatne na nadmierne dopasowanie.
Oto kilka rodzajów klasyfikacji Algorithms:
- Klasyfikatory Naive Bayes
- Drzewa decyzyjne
- Maszyna wektorów nośnych
- K-Najbliżsi sąsiedzi
- Las losowy i wzmacnianie gradientu
Naiwne klasyfikatory Bayesa
Naiwny Bayes Model jest łatwy w budowie i bardzo przydatny w przypadku dużych zbiorów danych. Metoda ta składa się z skierowanych grafów acyklicznych z jednym elementem nadrzędnym i kilkoma elementami potomnymi. Zakłada ona niezależność węzłów potomnych oddzielonych od elementu nadrzędnego.
Drzewa decyzyjne
Drzewa decyzyjne klasyfikują instancję, sortując ją na podstawie wartości cechy. W tej metodzie każdy węzeł reprezentuje cechę instancji, która powinna zostać sklasyfikowana, a każda gałąź reprezentuje wartość, którą węzeł może przyjąć. Jest to powszechnie stosowana technika klasyfikacji.
Taka sama struktura sprawdza się w przypadku regresji: drzewo regresji pomaga oszacować rzeczywiste wartości (koszt zakupu samochodu, liczbę połączeń, całkowitą miesięczną sprzedaż itp.).
Maszyna wektorów nośnych
Maszyna wektorów nośnych (SVM) to rodzaj algorytmu uczenia się wprowadzonego w latach 1990. XX wieku. Metoda ta opiera się na wynikach statystycznej teorii uczenia się opracowanej przez Władimira Wapnika i jego współpracowników.
Maszyny SVM są również ściśle powiązane z funkcjami jądra, które stanowią kluczową koncepcję dla większości zadań edukacyjnych. Struktura jądra i SVM są wykorzystywane w wielu dziedzinach. Obejmuje to wyszukiwanie informacji multimedialnych, bioinformatykę i rozpoznawanie wzorców. Każdy z powyższych estymatorów jest udokumentowany wraz z parametrami dostrajania w pliku. nauka-scikit odniesienie.
Techniki uczenia maszynowego nadzorowane i nienadzorowane
Umieszczenie metody obok uczenie się bez nadzoru jasno określa swoje granice.
| Oparte na | Technika uczenia maszynowego pod nadzorem | Technika uczenia maszynowego bez nadzoru |
|---|---|---|
| Dane wejściowe | Algorithms są szkolone przy użyciu oznakowanych danych. | Algorithms są używane w odniesieniu do danych, które nie są oznaczone |
| Złożoność obliczeniowa | Uczenie się pod nadzorem jest prostszą metodą. | Uczenie się bez nadzoru jest obliczeniowo złożone |
| Dokładność | Metoda bardzo dokładna i godna zaufania. | Less metoda dokładna i wiarygodna. |
| Typowe algorytmy | Regresja logistyczna, drzewa decyzyjne, SVM, Naiwny Bayes | K-means, klasteryzacja hierarchiczna, PCA |
| Jak oceniane są wyniki | Oceniane na podstawie znanych odpowiedzi (dokładność, RMSE) | Oceniane na podstawie wewnętrznych miar i przeglądu ludzkiego |
Wyzwania w nadzorowanym uczeniu maszynowym
Oto wyzwania stojące przed nadzorowanym uczeniem maszynowym:
- Nieistotne cechy wejściowe w danych szkoleniowych mogą dawać niedokładne wyniki
- Przygotowanie i wstępne przetwarzanie danych jest zawsze wyzwaniem.
- Dokładność spada, gdy jako dane treningowe wprowadzono wartości niemożliwe, mało prawdopodobne i niekompletne
- Jeśli odpowiedni ekspert nie jest dostępny, wówczas innym podejściem jest „siłowe” podejście. Oznacza to, że trzeba zgadnąć, na jakich cechach (zmiennych wejściowych) trenować maszynę, a to przypuszczenie może być niedokładne.
Zalety uczenia się pod nadzorem
W obliczu tych wyzwań, nadzorowane uczenie maszynowe ma następujące zalety:
- Nauka pod nadzorem w Nauczanie maszynowe umożliwia zbieranie danych lub tworzenie wyników danych na podstawie poprzednich doświadczeń
- Pomaga zoptymalizować kryteria wydajności, korzystając z doświadczenia
- Nadzorowane uczenie maszynowe pomaga rozwiązywać różnego rodzaju problemy obliczeniowe w świecie rzeczywistym.
Wady uczenia się pod nadzorem
Poniżej przedstawiono wady nadzorowanego uczenia maszynowego:
- Granica decyzyjna może być przetrenowana, jeśli w zestawie treningowym nie ma przykładów, które chcesz mieć w klasie
- Podczas szkolenia klasyfikatora musisz wybrać wiele dobrych przykładów z każdej klasy.
- Klasyfikacja dużych zbiorów danych może stanowić prawdziwe wyzwanie.
- Szkolenie w zakresie uczenia się pod nadzorem wymaga dużej ilości czasu obliczeniowego.
Najlepsze praktyki w zakresie uczenia nadzorowanego
Następująca sekwencja utrzymuje projekt w stanie track:
- Zanim cokolwiek zrobisz, zdecyduj, jaki rodzaj danych ma posłużyć jako zbiór treningowy
- Określ strukturę nauczonej funkcji i algorytm uczenia.
- Zbierz odpowiednie dane wyjściowe od ekspertów lub z pomiarów
- Zachowaj zestaw testowy, którego model nigdy nie widzi, i zgłoś wynik na jego podstawie
