
Matryca zamieszania w uczeniu maszynowym z PRZYKŁADEM
 Evelyn Clarke
⚡ Inteligentne podsumowanie
Macierz pomyłek to tabela pomiaru wydajności modeli klasyfikacyjnych, która porównuje przewidywane etykiety ze znanymi, rzeczywistymi etykietami. Ujawnia ona dokładnie, które klasyfikator rozpoznaje poprawnie, a które błędnie.
Co to jest matryca zamieszania?
A matryca zamieszania jest techniką pomiaru wydajności uczenie maszynowe Klasyfikacja. Jest to tabela pokazująca, jak model klasyfikacji sprawdził się na zestawie danych testowych, dla których znane są już wartości rzeczywiste. Termin „macierz pomyłek” jest dość prosty, ale terminologia na nim oparta może być myląca, dlatego każdy jego fragment wyjaśniono poniżej prostym językiem.
Matryca ma zastosowanie do każdego klasyfikator nadzorowany — regresja logistyczna, drzewo decyzyjne, Naiwny model Bayesa lub głęboka sieć neuronowa — ponieważ porównuje tylko dwie kolumny etykiet: to, co przewidywał model i to, co było faktycznie prawdą.
Cztery wyniki macierzy zamieszania
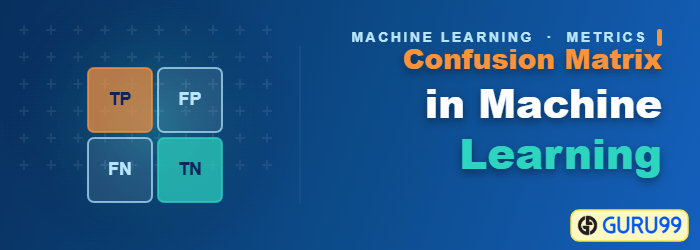
Macierz pomyłek wizualizuje dokładność klasyfikatora poprzez porównanie rzeczywistych i przewidywanych klas. Macierz pomyłek binarnych składa się z kwadratów:

Powyższa tabela przedstawia mapę czterech kwadratów, które zawiera każda macierz pomyłek binarnych:
- TP: Prawdziwie pozytywne: Przewidywane wartości zostały prawidłowo przewidziane jako faktycznie dodatnie
- FP: Fałszywie pozytywny: Wartości przewidywane błędnie przewidziane jako faktycznie dodatnie, tj. wartości ujemne przewidziane jako dodatnie
- FN: Fałszywie negatywny: Wartości dodatnie przewidywane jako ujemne
- TN: Prawda Negatywna: Przewidywane wartości zostały prawidłowo przewidziane jako wartości ujemne
Statystyka nadaje obu komórkom błędów własne nazwy. Fałszywy wynik to Błąd typu I. — model wywołał alarm, który nigdy nie powinien był się pojawić. Fałszywie negatywny wynik to Błąd typu II — model milczał, mimo że powinien był podnieść alarm. Wiedza o tym, która z tych dwóch metod jest bardziej kosztowna w przypadku danego problemu, decyduje o tym, którą metrykę dostosujesz później.
Test dokładności można obliczyć na podstawie macierzy pomyłek, zgodnie ze wzorem poniżej:

Przykład macierzy zamieszania
Macierz pomyłek to użyteczna metoda uczenia maszynowego, która pozwala mierzyć czułość, precyzję, dokładność oraz krzywą AUC-ROC. Poniższy przykład z piłką nożną pokazuje, co w języku potocznym oznaczają terminy „prawdopodobnie dodatni”, „prawdopodobnie ujemny”, „fałszywie dodatni” i „fałszywie ujemny”.
Prawdziwe pozytywne:
Przewidywałeś pozytywnie i okazało się to prawdą. Na przykład przewidziałeś, że Francja wygra mistrzostwa świata i wygrała.
Prawdziwie negatywne:
Przewidywałeś negatywną prognozę i to też prawda. Przewidywałeś, że Anglia nie wygra, a przegrała.
Fałszywe pozytywne:
Twoje przewidywania są pozytywne i fałszywe.
Przewidywałeś, że Anglia wygra, ale przegrała.
Fałszywy negatyw:
Twoja prognoza jest negatywna, a wynik wskazuje, że jest fałszywa.
Przewidywałeś, że Francja nie wygra, ale zwyciężyła.
Należy pamiętać, że pierwsze słowo opisuje, czy przewidywanie było trafne czy błędne (prawda lub fałsz), a drugie słowo opisuje, co model przewidział (pozytywne lub negatywne).
Jak obliczyć macierz zamieszania
Oto proces krok po kroku obliczania macierzy pomyłek w data mining:
- Krok 1) Najpierw potrzebujesz zestawu danych testowych i oczekiwanych wartości wyników.
- Krok 2) Przewiduj wszystkie wiersze w zestawie danych testowych.
- Krok 3) Porównaj oczekiwane wyniki z przewidywaniami i policz:
- Suma poprawnych przewidywań dla każdej klasy.
- Suma błędnych przewidywań dla każdej klasy.
Następnie liczby te są organizowane według poniższych metod:
- Każdy wiersz macierzy odpowiada konkretnej klasie.
- Każda kolumna macierzy jest powiązana z przewidywaną klasą.
- Sumaryczną liczbę poprawnych i błędnych klasyfikacji wpisuje się do tabeli.
- Suma prawidłowych przewidywań dla danej klasy trafia do komórki, w której rzeczywisty wiersz tej klasy styka się z jej własną przewidywaną kolumną — przekątną.
- Suma niepoprawnych przewidywań dla danej klasy trafia do wiersza zawierającego wartość tej klasy oraz do kolumny przewidywań klasy wybranej przez model.
Role wierszy i kolumn to konwencja, a nie prawo, a niektóre narzędzia do tworzenia wykresów transponują układ, dlatego zawsze należy czytać etykiety osi przed interpretacją macierzy. Orientacja zastosowana w tym przypadku – rzeczywista w wierszach, przewidywana w kolumnach – to ta generowana przez scikit-learn.
Inne ważne terminy przy użyciu macierzy zamieszania
Po wprowadzeniu czterech liczb powstaje rodzina terminów drugorzędnych opisujących różne wycinki tej samej tabeli:
- Wartość predykcyjna dodatnia (PPV): To bardzo blisko precyzji. Istotną różnicą między tymi dwoma terminami jest to, że PPV uwzględnia predykcję. W sytuacji, gdy klasy są idealnie zrównoważone, dodatnia wartość predykcyjna jest taka sama jak precyzja.
- Poziom błędu zerowego: Ten termin określa, jak często Twoja prognoza byłaby błędna, gdybyś zawsze przewidywał klasę większościową. Możesz traktować go jako metrykę bazową do porównywania swojego klasyfikatora.
- Wynik F: Wynik F1 to średnia ważona wyników prawdziwie pozytywnych (czułości) i precyzji.
- Krzywa ROC: Krzywa ROC przedstawia stosunek wyników prawdziwie dodatnich do fałszywie dodatnich w różnych punktach odcięcia. Pokazuje również kompromis między czułością (czułością) a swoistością, czyli wskaźnikiem wyników prawdziwie ujemnych.
- Precyzja: Metryka precyzji pokazuje dokładność klasy dodatniej. Mierzy prawdopodobieństwo, że przewidywanie klasy dodatniej jest prawidłowe.

Maksymalny wynik to 1, gdy klasyfikator idealnie klasyfikuje wszystkie wartości dodatnie. Sama precyzja nie jest zbyt pomocna, ponieważ ignoruje klasę ujemną. Metryka ta jest zazwyczaj sparowana z metryką czułości. Czułość czułości jest również nazywana czułością lub wskaźnikiem prawdziwie dodatnich wyników i jest zapisywana w sposób pokazany poniżej.
- Czułość: Czułość oblicza współczynnik prawidłowo wykrytych klas dodatnich. Ta metryka pokazuje, jak dobrze model rozpoznaje klasę dodatnią.

Metryki i wzory macierzy pomyłek
Każda z powyższych metryk opiera się na tych samych czterech wskaźnikach, dlatego dobrze jest je porównać z pytaniami, na które każda z nich odpowiada.
| metryczny | Formuła | Pytanie, na które odpowiada | Użyj tego, kiedy |
|---|---|---|---|
| Dokładność | (TP + TN) / (TP + TN + FP + FN) | Ile ogółem przewidywań okazało się prawidłowych? | Zajęcia są mniej więcej zrównoważone |
| Precyzja | TP / (TP + FP) | Kiedy model wskazuje wynik pozytywny, jak często ma rację? | Fałszywe alarmy są drogie |
| Przywołanie (czułość) | TP / (TP + FN) | Ile spośród wszystkich pozytywnych przypadków zostało złapanych? | Przeoczone pozytywne wyniki są kosztowne |
| Specyficzność | TN / (TN + FP) | Ile spośród wszystkich prawdziwych negatywów zostało usuniętych? | Klasa negatywna też ma znaczenie |
| Wynik F1 | 2 × (Precyzja × Przywołanie) / (Precyzja + Przywołanie) | Jaka jest równowaga pomiędzy tymi dwoma? | Potrzebujesz jednego numeru dla obu |
Weźmy filtr antyspamowy przetestowany na 100 wiadomościach e-mail, który generuje TP = 45, FN = 5, FP = 10 i TN = 40. Dokładność wynosi (45 + 40) / 100 = 0.85. Precyzja wynosi 45 / (45 + 10) = 0.82, czułość wynosi 45 / (45 + 5) = 0.90, a swoistość wynosi 40 / (40 + 10) = 0.80. Wynik F1 wynosi 0.86.
Te liczby opowiadają historię, którą ukrywa pojedyncza wartość dokładności: filtr wychwytuje 90 procent prawdziwego spamu, ale niesłusznie poddaje kwarantannie jeden na pięć legalnych e-maili oznaczonych. To, czy ta wymiana jest akceptowalna, zależy od kosztu każdego błędu, i właśnie dlatego raportowana jest macierz, a nie tylko dokładność.
Macierz pomyłek dla klasyfikacji wieloklasowej
Problemy z klasyfikacją rzadko kończą się na dwóch etykietach, a macierz skaluje się bez zmiany kształtu. Dla N klas tabela staje się siatką N×N: przekątna zawiera wszystkie poprawne przewidywania, a każda komórka poza przekątną dokładnie rejestruje, która klasa została pomylona z którą inną klasą.
Model trójklasowy, który sortuje obrazy na koty, psy i króliki, generuje siatkę 3×3. Jeśli komórka w wierszu „kot” i kolumnie „pies” zawiera 12, to dwanaście obrazów kotów oznaczono etykietą „pies”. Ten poziom szczegółowości sprawia, że macierz jest bardziej użyteczna niż wynik: wskazuje konkretną parę klas, których model nie może rozdzielić.
Precyzja, odwołanie i F1 są definiowane dla każdej klasy za pomocą widoku „jeden kontra reszta”, gdzie dana klasa jest klasą dodatnią, a wszystkie pozostałe są ujemne. Wartości dla każdej klasy są następnie łączone na jeden z trzech sposobów:
- Średnia makro: Oblicza metrykę dla każdej klasy niezależnie, a następnie oblicza średnią nieważoną. Każda klasa liczy się jednakowo, więc rzadkie klasy nie są pomijane.
- Mikrośrednia: Łączy wartości TP, FP i FN we wszystkich klasach przed obliczeniem metryki. Dominują duże klasy, a w przypadku problemów jednoetykietowych mikroprecyzja, mikroodwołanie i dokładność są identyczne.
- Średnia ważona: Uśrednia wyniki dla każdej klasy, wykorzystując liczbę prawdziwych wystąpień każdej klasy jako wagę, co pozwala zachować widoczną nierównowagę klas.
Wybierz makro, gdy każda klasa ma takie samo znaczenie, a ważone, gdy rozkład klas odzwierciedla rzeczywisty ruch.
Jak stworzyć macierz pomyłek w Python
Biblioteka scikit-learn buduje całą tabelę z dwóch tablic etykiet, więc ręczne liczenie nie jest wymagane. Poniższy przykład porównuje dziesięć prawdziwych etykiet z dziesięcioma prognozami.
from sklearn.metrics import confusion_matrix

y_true = [1, 0, 1, 1, 0, 1, 0, 0, 1, 0]
y_pred = [1, 0, 1, 0, 0, 1, 1, 0, 1, 0]

cm = confusion_matrix(y_true, y_pred)
print(cm)
Wywołanie zwraca tablicę NumPy 2×2, w której wiersz 0 jest rzeczywistą klasą ujemną, a wiersz 1 jest rzeczywistą klasą dodatnią:
[[4 1]
 [1 4]]
Odczyt tablicy zgodnie z konwencją scikit-learn daje TN = 4 (lewy górny róg), FP = 1 (prawy górny róg), FN = 1 (lewy dolny róg) i TP = 4 (prawy dolny róg). Rozpakowanie tych czterech wartości w jednym wierszu tworzy mapę.ping wyraźny:
tn, fp, fn, tp = confusion_matrix(y_true, y_pred).ravel()
Aby uzyskać precyzję, odwołanie i F1 dla każdej klasy jednocześnie, w tym makro i średnie ważone opisane powyżej, wywołaj classification_report() zamiast obliczać każdą metrykę ręcznie:
from sklearn.metrics import classification_report

print(classification_report(y_true, y_pred))
W przypadku wersji z planem: ConfusionMatrixDisplay.from_predictions(y_true, y_pred) renderuje tę samą tabelę jako mapę cieplną z etykietami. Pełna lista argumentów, w tym labels oraz normalize opcje, jest udokumentowane w scikit-learn confusion_matrix referenceTen sam krok oceny dotyczy modeli zbudowanych przy użyciu TensorFlowponieważ metryka zależy wyłącznie od przewidywanych etykiet.
Dlaczego potrzebujesz matrycy zamieszania?
Oto zalety i korzyści wynikające ze stosowania macierzy pomyłek.
- Pokazuje, jak model klasyfikacyjny może wprowadzać zamieszanie podczas tworzenia przewidywań.
- Macierz pomyłek pozwala nie tylko poznać błędy popełniane przez klasyfikator, ale także rodzaje błędów, które popełnia.
- Dzięki temu rozbiciu możesz pokonać ograniczenia wynikające ze stosowania wyłącznie dokładności klasyfikacji.
- Każda kolumna macierzy zamieszania reprezentuje instancje tej przewidywanej klasy.
- Każdy wiersz macierzy zamieszania reprezentuje instancje rzeczywistej klasy.
- Zamienia ocenę modelu w diagnozę, wskazując konkretną parę klas, która potrzebuje więcej danych lub lepszej funkcji.
Ta wartość diagnostyczna jest powodem, dla którego macierz pomyłek znajduje się w centrum etapu oceny w każdym przypadku. nauka danych przepływu pracy i dlaczego jest to zazwyczaj pierwsza tabela sprawdzana przed awansowaniem klasyfikatora do środowiska produkcyjnego.
