
Wykres punktowy w R z użyciem ggplot2 z przykładem
 Evelyn Clarke
⚡ Inteligentne podsumowanie
Wykres punktowy w R z użyciem ggplot2 mapuje dwie zmienne ciągłe na osie x i y za pomocą geom_point(). Ten przewodnik obejmuje grupyping według koloru, przekształceń logarytmicznych, dopasowanych linii regresji, etykiet, fasetowania, poprawek nakładania się wykresów, skal, motywów i zapisywania.
Dlaczego wykresy są ważne w analizie danych
Wykresy stanowią trzecią część procesu analizy danych. Pierwsza część dotyczy dane extraccja, o czym traktuje druga część czyszczenie i manipulowanie danymi. W końcu analityk danych może tego potrzebować przedstawić swoje wyniki w formie graficznej.
Poniższy rysunek przedstawia w skrócie przepływ pracy naukowca zajmującego się danymi.
- Pierwszym zadaniem analityka danych jest zdefiniowanie pytania badawczego. To pytanie badawcze zależy od celów i założeń projektu.
- Następnie jednym z najważniejszych zadań jest inżynieria funkcji. Analityk danych musi gromadzić dane, manipulować nimi i je czyścić
- Po zakończeniu tego kroku może rozpocząć eksplorację zbioru danych. Czasami ze względu na nowe odkrycie konieczne jest udoskonalenie i zmiana pierwotnej hipotezy.

- Podczas wyjaśniający analiza danych zostanie osiągnięta, badacz danych musi wziąć pod uwagę możliwości czytelnika zrozumieć podstawowe koncepcje i modele.
- Jego wyniki należy przedstawić w formacie zrozumiałym dla wszystkich zainteresowanych stron. Jedna z najlepszych metod komunikować wyniki są przez a wykres.
- Wykresy są niesamowitym narzędziem pozwalającym na uproszczenie złożonych analiz.
Pozostała część tego samouczka przedstawia tworzenie tych wykresów za pomocą pakietu ggplot2.
Pakiet ggplot2
W tym samouczku skupimy się na tworzeniu wykresów w R z użyciem ggplot2.
W tym samouczku użyjesz pakietu ggplot2. Pakiet ten implementuje gramatykę grafiki opisaną przez Lelanda Wilkinsona w 2005 roku. ggplot2 jest elastyczny, zawiera wiele motywów i pozwala na określenie wykresu na wysokim poziomie abs.tracNależy pamiętać, że nie generuje grafiki trójwymiarowej ani interaktywnej; do jej tworzenia potrzebne są pakiety takie jak plotly lub rgl.
W programie ggplot2 wykres składa się z następujących argumentów:
- dane
- mapa estetycznaping
- obiekt geometryczny
- przekształcenia statystyczne
- waga
- system współrzędnych
- korekty pozycji
- fasetowanie
W samouczku dowiesz się, jak kontrolować te argumenty.
Podstawowa składnia ggplot2 to:
ggplot(data, mapping=aes()) +
geometric object

arguments:
data: Dataset used to plot the graph
mapping: Control the x and y-axis
geometric object: The type of plot you want to show. The most common object are:

- Point: `geom_point()`
- Bar: `geom_bar()`
- Line: `geom_line()`
- Histogram: `geom_histogram()`
Jak utworzyć wykres punktowy w R
Zobaczmy, jak ggplot współpracuje ze zbiorem danych mtcars. Zaczynasz od wykreślenia wykresu rozrzutu zmiennej mpg i zmiennej drat.
Podstawowy wykres punktowy
library(ggplot2)
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point()
Code Wyjaśnienie
- Najpierw przekazujesz zbiór danych mtcars do ggplot.
- Wewnątrz argumentu aes() dodajesz oś x i oś y.
- Znak + oznacza, że chcesz, aby R nadal czytał kod. Kod staje się bardziej czytelny, ponieważ go łamie.
- Użyj geom_point() dla obiektu geometrycznego.
Wyjście:

Wykres punktowy z grupami
Czasami interesujące może być rozróżnienie wartości na podstawie grupy danych (tj. danych na poziomie czynnika).
ggplot(mtcars, aes(x = mpg, y = drat)) +
    geom_point(aes(color = factor(gear)))
Code Wyjaśnienie
- Funkcja aes() wewnątrz geom_point() steruje kolorem każdej grupy. Grupaping zmienna musi być czynnikiem, dlatego koło zębate jest zawarte w factor().
- W sumie masz kod aes(color = Factor(Gear)), który zmienia kolor kropek.
Wyjście:

Zmiana skali osi za pomocą transformacji logarytmicznej
Przeskalowanie danych stanowi istotną część pracy analityka, ponieważ surowe zmienne rzadko przybierają kształt dzwonu. Logarytmowanie to jeden ze sposobów kompresji wartości ekstremalnych i zmniejszenia wrażliwości wykresu na wartości odstające.
ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear)))
Code Wyjaśnienie
- Zmienne x i y transformujesz w log() bezpośrednio wewnątrz mapy aes()ping.
Należy zauważyć, że można zastosować dowolną inną transformację, taką jak standaryzacja lub normalizacja.
Wyjście:

Wykres punktowy z dopasowanymi wartościami
Możesz dodać kolejny poziom informacji do wykresu. Możesz nałożyć dopasowane wartości regresji liniowej.
my_graph <- ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear))) +
    stat_smooth(method = "lm",
        col = "#C42126",
        se = FALSE,
        size = 1)
my_graph
Code Wyjaśnienie
- my_graph: wykres jest przechowywany w obiekcie my_graph, więc późniejsze kroki mogą dodawać warstwy bez powtarzania całego wywołania
- Argument stat_smooth() steruje metodą wygładzania
- metoda = „lm”: Regresja liniowa
- kolumna = “#C42126”: Code dla czerwonego koloru linii
- se = FALSE: Nie wyświetlaj błędu standardowego
- size = 1: grubość linii. W ggplot2 3.4.0 i nowszych ten argument został przemianowany na linewidth dla geometrii liniowych.
Wyjście:

Należy pamiętać, że dostępne są inne metody wygładzania
- glm
- gam
- less: wartość domyślna dla mniej niż 1,000 obserwacji
- rlm: solidny model liniowy z pakietu MASS
Zanim zaczniesz stylizować wykres, warto wiedzieć, kiedy wykres punktowy jest w ogóle właściwym wyborem.
Wykres punktowy vs wykres liniowy vs BubblWykres e w R
Wszystkie trzy wykresy przedstawiają dwie zmienne ciągłe w zestawieniu ze sobą, więc wybór sprowadza się do tego, co czytelnik powinien wywnioskować.
| kryteria | Wykres punktowy | Wykres liniowy | Bubble Wykres |
|---|---|---|---|
| Targi | Korelacja między dwiema zmiennymi | Zmiana jednej zmiennej na osi uporządkowanej | Korelacja plus trzecia wielkość |
| Oś X | Dowolna zmienna ciągła | Zwykle czas lub inna uporządkowana skala | Dowolna zmienna ciągła |
| Kolejność punktów | Bez znaczenia | Krytyczne, punkty są połączone | Bez znaczenia |
| Trzecia zmienna | Poprzez kolor lub kształt | Przez oddzielne linie | Rozmiar punktu przelotowego |
| wywołanie ggplot2 | geom_point() | geom_line() | geom_point(aes(rozmiar = z)) |
Łączenie punktów rozrzutu linią, gdy oś x nie ma naturalnego porządku, to częsty błąd: implikuje to sekwencję, która nie istnieje. Zarezerwuj geom_line() dla osi uporządkowanych, takich jak daty. W przypadku rozkładów pojedynczej zmiennej użyj fabuła pudełkowa zamiast.
Dodaj informacje do wykresu
Jak dotąd wykresy nie zawierają tekstu objaśniającego. Czytelnik powinien być w stanie zrozumieć historię danych na podstawie samego wykresu, bez konieczności sięgania do dodatkowej dokumentacji, co oznacza, że wykres wymaga dobrych etykiet. Etykiety można dodać za pomocą funkcji labs().
Podstawowa składnia funkcji labs() jest następująca:
labs(title = "Hello Guru99")
arguments:
- title: Main title displayed above the plot
- subtitle: Secondary line below the title
- caption: Note below the plot, usually the data source
- x: Rename the x-axis
- y: Rename the y-axis
- color / fill: Rename the legend

Example: labs(title = "Hello Guru99", subtitle = "My first plot")
Dodaj tytuł
Obowiązkową informacją, którą należy dodać, jest oczywiście tytuł.
my_graph +
    labs(
        title = "Plot Mile per hours and drat, in log"
         )
Code Wyjaśnienie
- my_graph: Używasz zapisanego wykresu. Pozwala to uniknąć przepisywania wszystkich kodów za każdym razem, gdy dodajesz nowe informacje do wykresu.
- Tytuł należy umieścić w polu labs().
Wyjście:

Dodaj tytuł z dynamiczną nazwą
Tytuł dynamiczny jest pomocny w dodaniu bardziej precyzyjnych informacji w tytule.
Funkcji paste() można używać do drukowania tekstu statycznego i tekstu dynamicznego. Podstawowa składnia paste() jest następująca:
paste("This is a text", A)
arguments
- " ": Text inside the quotation marks are the static text
- A: Display the variable stored in A
- Note you can add as much static text and variable as you want. You need to separate them with a comma
Przykład:
A <- 2010
paste("The first year is", A)
Wyjście:
## [1] "The first year is 2010"
B <- 2018
paste("The first year is", A, "and the last year is", B)
Wyjście:
## [1] "The first year is 2010 and the last year is 2018"
Do naszego wykresu możesz dodać dynamiczną nazwę, a mianowicie średnią mpg.
mean_mpg <- mean(mtcars$mpg)
my_graph + labs(
    title = paste("Plot Mile per hours and drat, in log. Average mpg is", mean_mpg)
)
Code Wyjaśnienie
- Tworzysz średnią mpg za pomocą średniej (mtcars$mpg) zapisanej w zmiennej mean_mpg
- Używasz funkcji paste() z mean_mpg, aby utworzyć dynamiczny tytuł zwracający średnią wartość mpg
Wyjście:

Dodaj podtytuł
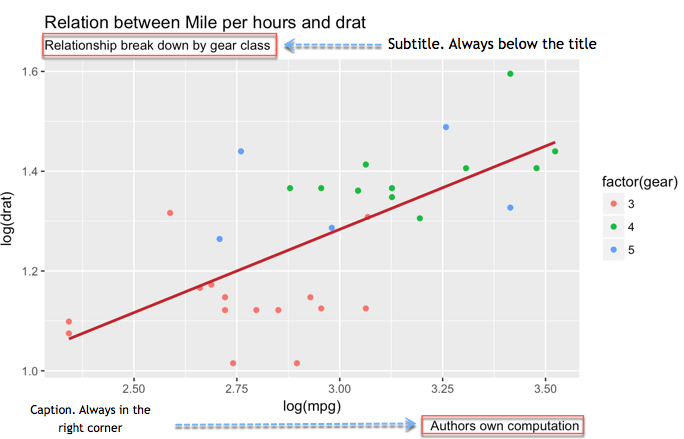
Dwa dodatkowe szczegóły sprawiają, że wykres jest bardziej przejrzysty. Chodzi o podtytuł i podpis. Podtytuł znajduje się tuż pod tytułem. Podpis może informować o tym, kto wykonał obliczenia i skąd pochodzą dane.
my_graph +
    labs(
        title =
        "Relation between Mile per hours and drat",
        subtitle =
        "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Wyjaśnienie
- Wewnątrz labs() dodałeś:
- title = „Związek między milą na godzinę a drat”: Dodaj tytuł
- subtitle = „Podział relacji według klasy sprzętu”: Dodaj podtytuł
- caption = „Własne obliczenia autora: Dodaj podpis
- Każdą nową informację oddzielasz przecinkiem, ,
- Pamiętaj, że łamiesz linie kodu. Nie jest to obowiązkowe, a jedynie pomaga w łatwiejszym czytaniu kodu
Wyjście:
Zmień nazwę osi X i Y
Nazwy kolumn rzadko nadają się do prezentacji. Często są skracane lub zawierają podkreślenia między wyrazami, jak w przypadku GDP_CAP. Zmień ich nazwy na wykresie i dodaj jednostki tam, gdzie to istotne.
my_graph +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Wyjaśnienie
- Wewnątrz labs() dodałeś:
- x = „Definicja pochylenia”: Zmień nazwę osi X
- y = „Mila na godzinę”: Zmień nazwę osi y
Wyjście:

Kontroluj wagę
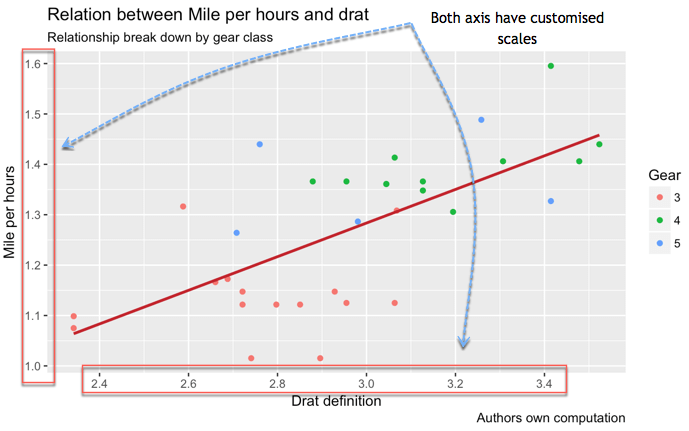
Możesz kontrolować skalę osi.
Funkcja seq() jest wygodna, gdy trzeba utworzyć ciąg liczb. Podstawowa składnia to:
seq(begin, last, by = x)
arguments:
- begin: First number of the sequence
- last: Last number of the sequence
- by= x: The step. For instance, if x is 2, the code adds 2 to `begin-1` until it reaches `last`
Na przykład zakres od 0 do 12 z krokiem 4 zwraca cztery liczby: 0, 4, 8 i 12.
seq(0, 12,4)
Wyjście:
## [1] 0 4 8 12
Możesz kontrolować skalę osi X i Y, jak poniżej
my_graph +
    scale_x_continuous(breaks = seq(1, 3.6, by = 0.2)) +
    scale_y_continuous(breaks = seq(1, 1.6, by = 0.1)) +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Wyjaśnienie
- Funkcja Scale_y_continuous() steruje osi y
- Funkcja Scale_x_continuous() steruje oś x.
- Parametr breaks steruje podziałem osi. Możesz ręcznie dodać sekwencję liczb lub użyć funkcji seq():
- seq(1, 3.6, by = 0.2): Utwórz sekwencję od 1 do 3.6 w krokach co 0.2, czyli 14 punktów przerwania
- seq(1, 1.6, by = 0.1): Utwórz siedem liczb od 1 do 1.6 w krokach co 0.1
Wyjście:
Motyw
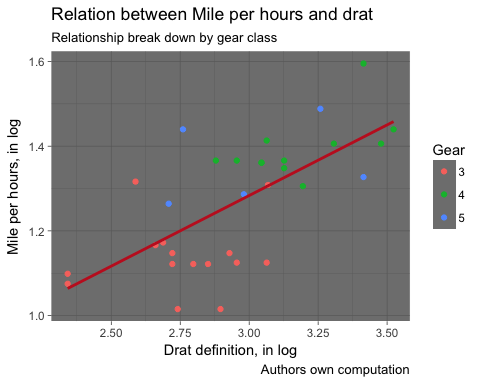
Wreszcie, ggplot2 pozwala na zmianę stylu całego wykresu za pomocą jednej funkcji motywu. W pakiecie znajduje się osiem kompletnych motywów:
- motyw_bw()
- światło_motywu()
- theme_classic()
- motyw_linedraw()
- motyw_ciemny()
- temat_minimalny()
- motyw_szary()
- motyw_pustki()
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Wyjście:

Zapisz działki
Po wykonaniu wszystkich tych kroków nadszedł czas na zapisanie i udostępnienie wykresu. Wywołaj ggsave(“name_of_the_file.png”) zaraz po narysowaniu wykresu, a obraz zostanie zapisany na dysku.
Wykres zostaje zapisany w katalogu roboczym. Aby sprawdzić katalog roboczy, możesz uruchomić ten kod:
directory <- getwd()
directory
Narysuj gotowy wykres, zapisz go i sprawdź, gdzie się znajduje:
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Wyjście:
ggsave("my_fantastic_plot.png")
Wyjście:
## Saving 5 x 4 in image
Note: Wyłącznie do celów pedagogicznych stworzyliśmy funkcję o nazwie open_folder(), która umożliwia otwarcie folderu katalogu. Wystarczy uruchomić poniższy kod i sprawdzić, gdzie przechowywany jest obraz. Powinieneś zobaczyć plik o nazwie my_fantastic_plot.png.
# Run this code to create the function
open_folder <- function(dir) {
    if (.Platform['OS.type'] == "windows") {
        shell.exec(dir)
    } else {
        system(paste(Sys.getenv("R_BROWSER"), dir))
    }
}

# Call the function to open the folder
open_folder(directory)
Jak tworzyć wykresy punktowe fasetowe w R za pomocą funkcji facet_wrap()
Faceting to jeden z ośmiu komponentów ggplot2 wymienionych wcześniej i stanowi najczystszą odpowiedź na zatłoczony wykres. Zamiast ściskać każdą grupę w jednym panelu, ggplot2 rysuje małą wielokrotność dla każdego poziomu zmiennej, wszystkie w tych samych skalach, dzięki czemu panele pozostają porównywalne.
# One panel per gear count
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point() +
    facet_wrap(~ gear) +
    theme_classic()
Najwięcej pracy załatwiają trzy argumenty.
- nkol or nrów: wymusza układ paneli w danym układzie, na przykład facet_wrap(~ gear, ncol = 2).
- waga: Domyślnie „stałe”, więc każdy panel ma jeden zakres osi. Użyj „free_y” lub „free”, gdy grupy różnią się znacznie wielkością, ale pamiętaj, że skale „free” sprawiają, że wizualne porównanie paneli jest mylące.
- labeller: zastępuje surowy poziom czynnika w każdym pasku, na przykład labeller = label_both, aby wydrukować „gear: 4” zamiast „4”.
Dwie grupyping zmiennych. Użyj facet_grid(), aby zbudować macierz paneli, przy czym pierwsza zmienna będzie znajdować się w wierszach, a druga w kolumnach:
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point(aes(color = factor(cyl))) +
    facet_grid(am ~ gear) +
    theme_classic()
Fasety czy kolory? Kolor działa dobrze do około czterech grup na wykresie z ograniczonym nakładaniem się. Powyżej tej wartości lub gdy grupy mocno się nakładają, fasetowanie jest łatwiejsze do odczytania, ponieważ każdy panel zawiera tylko własne punkty. Można połączyć obie funkcje: fasetowanie według jednej zmiennej i kolor według innej, jak w przykładzie facet_grid() powyżej.
Jak radzić sobie z przerysowywaniem wykresów punktowych w programie R
Przy kilkudziesięciu obserwacjach każdy punkt jest widoczny. Przy tysiącach znaczniki układają się jeden na drugim, a najgęstszy obszar wygląda po prostu jak jednolita plama. To znaczy przekreślanie, a ggplot2 oferuje cztery standardowe rozwiązania.
1. Zmniejsz krycie. Najtańsze rozwiązanie. Nakładanie sięping punkty naturalnie ciemnieją, dzięki czemu gęstość staje się widoczna:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    theme_classic()
2. Wartości dyskretne jittera. Gdy zmienna przyjmuje tylko kilka wartości, punkty lądują na tych samych współrzędnych. Niewielkie, losowe przesunięcie je rozdziela:
ggplot(mtcars, aes(x = factor(cyl), y = mpg)) +
    geom_jitter(width = 0.15, height = 0) +
    theme_classic()
Ustaw wysokość na 0, aby wartości y, które niosą rzeczywiste informacje, nigdy nie uległy zmianie.
3. Wyrzuć samolot. W przypadku dużych zbiorów danych należy policzyć obserwacje w każdej komórce i nanieść wynik na kolor. Pojemniki sześciokątne pozwalają uniknąć artefaktów wizualnych, które występują w pojemnikach kwadratowych:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_hex(bins = 40) +
    theme_classic()
4. Narysuj kontury gęstości. Linie konturowe wyznaczają obszary, na których koncentrują się obserwacje, i nakładają się na niewyraźne punkty:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    geom_density_2d(color = "#C42126") +
    theme_classic()
Z reguły algorytm alfa obsługuje kilka tysięcy punktów, algorytm heksagonalny obsługuje dziesiątki tysięcy, a próbkowanie danych za pomocą funkcji dplyr::slice_sample() jest bardziej pragmatyczną opcją.
Wykres punktowy w R: Code Numer Referencyjny
Poniższa tabela przedstawia wywołanie ggplot2 dla każdej z opcji omówionych powyżej:
| Cel | Code |
|---|---|
| Podstawowy wykres punktowy |
ggplot(df, aes(x = x1, y = y)) + geom_point() |
| Wykres punktowy z grupą kolorów |
ggplot(df, aes(x = x1, y = y)) + geom_point(aes(color = factor(x2))) |
| Dodaj dopasowane wartości |
ggplot(df, aes(x = x1, y = y)) + geom_point() + stat_smooth(method = "lm") |
| Dodaj tytuł |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(title = paste("Hello Guru99")) |
| Dodaj napisy |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(subtitle = paste("Hello Guru99")) |
| Zmień nazwę x |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(x = "X1") |
| Zmień nazwę y |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(y = "y1") |
| Kontroluj skalę |
ggplot(df, aes(x = x1, y = y)) + geom_point() + scale_y_continuous(breaks = seq(10, 35, by = 10)) + scale_x_continuous(breaks = seq(2, 5, by = 1)) |
| Utwórz dzienniki |
ggplot(df, aes(x = log(x1), y = log(y))) + geom_point() |
| Motyw |
ggplot(df, aes(x = x1, y = y)) + geom_point() + theme_classic() |
| Aspekt grupy |
ggplot(df, aes(x = x1, y = y)) + geom_point() + facet_wrap(~ x2) |
| Radzenie sobie z nadmiernym nanoszeniem |
ggplot(df, aes(x = x1, y = y)) + geom_point(alpha = 0.3) |
| Zapisz |
ggsave("my_fantastic_plot.png")
|
