
Test T w programowaniu R: jedna próbka i przykład sparowany
 Evelyn Clarke
⚡ Inteligentne podsumowanie
Test t w R porównuje średnie za pomocą funkcji t.test(), obejmując jedną próbkę z ustalonym celem, dwiema niezależnymi grupami i parami powtarzanych pomiarów. Ten przewodnik uruchamia każdy wariant, poprawnie odczytuje wartość p i weryfikuje założenia.
Co to jest wnioskowanie statystyczne?
Wnioskowanie statystyczne to sztuka generowania wniosków na temat rozkładu danych. Analityk danych często staje przed pytaniami, na które można odpowiedzieć wyłącznie naukowo. Dlatego wnioskowanie statystyczne to strategia sprawdzania, czy hipoteza jest prawdziwa, tj. potwierdzona danymi.
Powszechną strategią oceny hipotezy jest test t, który pozwala sprawdzić, czy dwie średnie są równe. Jest on również znany jako Test studenckiTest t można obliczyć dla:
- Pojedynczy wektor względem wartości ustalonej (test t dla jednej próby)
- Dwa wektory z dwóch oddzielnych grup (niezależny test t dla dwóch prób)
- Dwa wektory mierzone na tych samych obiektach (test t dla par)
Każdy test t zakłada, że dane są losowo pobierane, a wartości (lub, w przypadku testu parowanego, różnice) pochodzą z populacji o rozkładzie zbliżonym do normalnego. Wersja z dwiema niezależnymi próbami dodatkowo zakłada, że obie grupy są od siebie niezależne, a wersja klasyczna – że ich wariancje są równe.
Co to jest test T w programowaniu R?
Podstawową ideą testu T jest wykorzystanie statystyk do oceny dwóch przeciwstawnych hipotez:
- H0:hipoteza zerowa, że średnia populacji jest równa testowanej wartości
- H1:hipoteza alternatywna, że średnia populacji różni się od tej wartości
Test t jest przeznaczony do małych prób, gdzie przybliżenie normalne jest zawodne. Wymaga, aby dane miały rozkład w przybliżeniu normalny.
Składnia testu T w R
Podstawowa składnia t.test() w R jest następująca:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
Przed uruchomieniem czegokolwiek dopasuj układ danych do odpowiedniej wersji testu.
Rodzaje testów T w R
Wybór niewłaściwego wariantu to najczęstszy błąd w teście t, dlatego zacznij od dopasowania układu danych do właściwego wywołania.
| Typ | Użyj tego, kiedy | Wywołanie R |
|---|---|---|
| Jedna próbka | Jedna grupa w porównaniu z znaną wartością docelową | t.test(x, mu = wartość) |
| Niezależne dwupróbkowe (Welch) | Dwie oddzielne grupy, możliwe nierówne odchylenia | t.test(x, y) |
| Niezależne dwupróbkowe (zbiorcze) | Dwie oddzielne grupy o równej wariancji | t.test(x, y, var.equal = TRUE) |
| Sparowane | Te same osoby mierzone dwukrotnie | t.test(x, y, sparowane = PRAWDA) |
| Jednostronny | Interesuje Cię tylko różnica w jednym kierunku | t.test(x, mu = wartość, alternatywa = „większa”) |
Powyżej trzech grup test t nie jest już odpowiedni. Przejdź do Test ANOVA, co utrzymuje ogólny wskaźnik błędów na poziomie 5 procent zamiast zwiększać go w przypadku powtarzających się porównań parami.
Test T dla jednej próbki w R
Test t dla jednej próby, zwany też testem Studenta, porównuje średnią wektora ze średnią teoretyczną,  . Wzór używany do obliczenia testu t to:

Tutaj,
 odnosi się do średniej
 do średniej teoretycznej
- s jest odchyleniem standardowym
- n liczba obserwacji.
 odnosi się do średniej
Aby ocenić istotność statystyczną testu t, należy obliczyć Wartość p, Wartość p waha się od 0 do 1 i jest interpretowane w następujący sposób:
- Wartość p niższa niż 0.05 oznacza, że można odrzucić hipotezę zerową. Należy pamiętać, że odrzucenie hipotezy H0 nie jest równoznaczne z potwierdzeniem prawdziwości hipotezy H1, oznacza jedynie, że dane są mało prawdopodobne w przypadku hipotezy H0.
- Wartość p wyższa niż 0.05 oznacza, że nie masz wystarczających dowodów, aby odrzucić hipotezę zerową.
Wartość p można skonstruować, patrząc na odpowiednią wartość bezwzględną testu t w rozkładzie Studenta ze stopniami swobody równymi 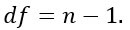
Na przykład, mając 5 obserwacji, porównujesz swoją wartość t z rozkładem Studenta o 4 stopniach swobody przy 95-procentowym poziomie ufności. Aby odrzucić hipotezę zerową w teście dwustronnym, bezwzględna wartość t musi przekraczać 2.776.
Zobacz tabelę poniżej:

Przykład testu T dla jednej próbki w R
Załóżmy, że jesteś firmą produkującą pliki cookie. Każde ciasteczko powinno zawierać 10 gramów cukru. Ciasteczka są produkowane przez maszynę, która dodaje cukier do miski przed wymieszaniem wszystkiego. Uważasz, że maszyna nie dodaje 10 gramów cukru do każdego ciasteczka. Jeśli Twoje założenie jest prawdziwe, maszynę należy naprawić. Zapisałeś poziom cukru trzydziestu ciasteczek.
Note: Możesz utworzyć losowy wektor za pomocą funkcji rnorm(). Ta funkcja generuje wartości o rozkładzie normalnym. Podstawowa składnia to:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
Można utworzyć rozkład z 30 obserwacji ze średnią 9.99 i odchyleniem standardowym 0.04.
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
Wyjście:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
Możesz zastosować test t dla jednej próbki, aby sprawdzić, czy poziom cukru różni się od przepisu. Możesz narysować test hipotezy:
- H0: Średni poziom cukru wynosi 10
- H1: Średni poziom cukru jest inny niż 10
Używasz poziomu istotności 0.05.
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
Oto wynik:

Wartość p w teście t dla jednej próby wynosi 0.1079 i przekracza próg 0.05. 95-procentowy przedział ufności dla średniej wynosi od 9.973 do 10.002 grama i zawiera wartość docelową równą 10. Nie można zatem odrzucić hipotezy H0: nie ma wystarczających dowodów na to, że maszyna odbiega od receptury.
Niezależny dwupróbkowy test t w R
Niezależny dwupróbkowy test t jest najczęściej stosowaną odmianą testu i ma zastosowanie zawsze, gdy dwa zestawy pomiarów pochodzą od różnych podmiotów: dwóch warsztatów, dwóch maszyn, dwóch ramion zabiegowych.
Załóżmy, że w fabryce działają dwie linie produkcyjne i chcesz wiedzieć, czy słoiki napełniane są do tej samej wagi.
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
Przeczytaj wynik w czterech krokach.
- t to znormalizowany rozmiar odstępu między dwiema średnimi. Jego znak odzwierciedla jedynie kolejność przekazywania wektorów.
- df to liczba stopni swobody. Welch oblicza wartość ułamkową; test zbiorczy daje liczbę całkowitą równą n1 + n2 – 2.
- Wartość p jest prawdopodobieństwo zaobserwowania tak dużej różnicy, jeśli prawdziwe średnie byłyby identyczne.
- Przedział ufności ogranicza prawdziwą różnicę. Jeśli zawiera zero, różnica nie jest istotna na tym poziomie.
Jeśli Twoje dane znajdują się w pojedynczej ramce danych z jedną kolumną wartości i jedną kolumną czynnika, użyj interfejsu formuły, który jest łatwiejszy do odczytania i pozwala uniknąć ręcznego dzielenia danych:
t.test(weight ~ line, data = jars)
Którą wersję wybrać? Pozostaw domyślną wartość var.equal FALSE, chyba że przetestowałeś i potwierdziłeś równość wariancji. Korekta Welcha praktycznie nic nie kosztuje, gdy wariancje się zgadzają, i chroni Cię, gdy tak nie jest.
Sparowany test T w R
Test t dla prób parzystych, zwany również testem t dla próby zależnej, ma zastosowanie, gdy ta sama grupa jest mierzona dwukrotnie. Typowe zastosowania to:
- Testowanie A / B: Porównaj dwa warianty
- Badania typu „przypadek-kontrola”:przed i po leczeniu tych samych pacjentów
Przykład sparowanego testu T w R
Firma produkująca napoje jest zainteresowana poznaniem wyników programu rabatowego w sprzedaży. Firma postanowiła śledzić dzienną sprzedaż w jednym ze swoich sklepów, w którym promowany jest program. Pod koniec programu firma chce wiedzieć, czy istnieje statystyczna różnica między średnią sprzedażą sklepu przed i po programie.
- Firma tracCodziennie sprawdzaliśmy sprzedaż przed rozpoczęciem programu. To nasz pierwszy wektor.
- Program jest promowany przez tydzień, a sprzedaż jest rejestrowana każdego dnia. To nasz drugi wektor.
- Przeprowadzisz test t, aby ocenić skuteczność programu. Nazywa się to testem t dla par, ponieważ wartości obu wektorów pochodzą z tego samego rozkładu (tj. tego samego sklepu).
Testowanie hipotez polega na:
- H0: Brak różnicy w średniej
- H1: Te dwa sposoby są różne
Należy pamiętać, że klasyczny test t zakłada nieznaną, ale równą wariancję w obu grupach. Rzeczywiste dane rzadko spełniają to założenie, a zignorowanie różnicy może zniekształcić wynik.
Rozwiązaniem jest test t Welcha, który łagodzi założenie o równej wariancji. R stosuje go domyślnie, ponieważ var.equal ma wartość FALSE, chyba że zaznaczysz inaczej. W tym zbiorze danych oba wektory zostały wygenerowane z tym samym odchyleniem standardowym, więc możesz bezpiecznie ustawić var.equal = TRUE.
Tworzysz dwa losowe wektory z rozkładu Gaussa z wyższą średnią dla sprzedaży po programie.
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

Wartość p wynosi 0.04606, tuż poniżej progu 0.05, więc odrzucasz H0 i wnioskujesz, że obie średnie różnią się znacząco. Program rabatowy najwyraźniej zwiększył sprzedaż.
⚠️ Ważne: powyższe wywołanie porównuje dwa wektory jako niezależny próbki. Ponieważ obie serie to pomiary w tym samym sklepie, statystycznie poprawne wywołanie dodaje sparowane = PRAWDA:
t.test(sales_before, sales_after, paired = TRUE)
W formie sparowanej testowana jest średnia różnic z dnia na dzień, a nie różnica dwóch średnich. Usuwa ona zmienność na poziomie warsztatu, wspólną dla obu wektorów, a zatem ma większą moc statystyczną.
Jak sprawdzić założenia testu T w R
Wartość p w teście t jest znacząca tylko wtedy, gdy spełnione są jej założenia. Każde z nich można bezpośrednio sprawdzić.
1. Normalność. Testy z jedną i dwiema próbkami zakładają, że wartości są w przybliżeniu normalne; test parowany zakłada, że Różnice są. Sprawdź wykres QQ i potwierdź go testem Shapiro-Wilka:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
Wartość p Shapiro-Wilka powyżej 0.05 oznacza, że nie można odrzucić rozkładu normalnego. Przy ponad 30 obserwacjach na grupę, centralne twierdzenie graniczne sprawia, że test t jest odporny na umiarkowane skośności.
2. Równa wariancja. Wymaga tego tylko test z dwiema próbkami zbiorczymi. Przetestuj go za pomocą testu F:
var.test(line_a, line_b)
Wartość p powyżej 0.05 potwierdza równe wariancje, co uzasadnia var.equal = TRUE.
3. Niezależność. Wynika to z projektu badania i nie można tego sprawdzić po fakcie. Jeśli ten sam podmiot ma wkład w oba wektory, test niezależny jest po prostu niewłaściwym narzędziem i wymagane jest sparowanie = PRAWDA.
Kiedy założenie okazuje się błędne. W przypadku danych wyraźnie odbiegających od rozkładu normalnego z małymi próbkami, należy skorzystać z alternatyw opartych na rangach: wilcox.test(x, y) zastępuje test t dla dwóch prób, a wilcox.test(x, y, paired = TRUE) zastępuje wersję sparowaną. Żadna z tych metod nie wymaga rozkładu normalnego, choć obie tracą nieco na mocy, gdy dane są w rzeczywistości normalne.
Test T w R: najważniejsze wnioski i odniesienia do testów
- Wnioskowanie statystyczne to sztuka wyciągania wniosków na temat rozkładu danych.
- Test T należy do rodziny statystyk inferencyjnych. Jest powszechnie stosowany w celu sprawdzenia, czy istnieje różnica statystyczna między średnimi dwóch grup.
- Jednopróbkowy test t, zwany też testem Studenta, porównuje średnią wektora ze średnią teoretyczną.
- Test t dla prób sparowanych lub test t dla prób zależnych stosuje się, gdy tę samą grupę bada się dwukrotnie.
Poniższa tabela podsumowuje każdy z omówionych powyżej testów:
| Testowanie | Hipoteza do sprawdzenia | Wartość p | Code | Argument opcjonalny |
|---|---|---|---|---|
| test t dla jednej próby | Średnia wektora różni się od średniej teoretycznej | 0.05 |
t.test(x, mu = mean)
|
|
| Test t dla sparowanych próbek | Średnia A różni się od średniej B dla tych samych osób | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
Jeśli chcesz założyć równe wariancje w niezależnym teście dwupróbkowym, ustaw var.equal = TRUE. Pozostaw domyślną wartość FALSE, aby zastosować bezpieczniejszą poprawkę Welcha.
