
SAP HANA の DS (データ サービス)
 メイソンガルシア
⚡ スマートサマリー
SAP データサービスは、異種ソースからデータを移動およびクレンジングするエンタープライズETLプラットフォームです。 SAP HANA。Designer、Job Server、Engine、Repository、およびAccess Serverは連携して、データフローの構築、スケジュール設定、および実行を行います。
何ですか SAP データサービス?
SAP データサービスは、ETLツールであり、異種混在のデータソースからターゲットデータベースまたはデータウェアハウスへのデータ統合、変換、データ品質管理、データプロファイリング、テキストデータ処理のための、単一のエンタープライズレベルのソリューションを提供します。
ジョブと呼ばれるアプリケーションは、データマップがping 変換が定義されています。製品は次のようにも呼ばれます。 SAP BusinessObjects Data Services(略称) SAP BODS、そしてどちらの名称も同じツールを指します。 SAP Data Services 4.3が現在のリリースです。バージョン4.2は2023年5月31日にメインストリームメンテナンスが終了したため、新規導入は4.3から開始する必要があります。
内で SAP HANAランドスケープ、 SAP データサービスは、データをそのままコピーするのではなく、取り込む際にデータを再構成する必要がある場合に選択されるオプションです。以下のセクションでは、このツールが提供する機能、各コンポーネントの連携方法、および完全なワークロードについて説明します。 SAP ECCテーブルを SAP ハナ。
の特長 SAP データサービス
以下の機能でその理由がわかります SAP データサービスは、単なるコピーユーティリティではなく、エンタープライズグレードのプラットフォームとして位置づけられています。
- 高性能の並列変換を提供します。
- 包括的な管理ツールとレポート作成ツールを備えています。
- 複数のユーザーをサポートします。
- SAP ボディ ウェブサービスベースのアプリケーションに対して非常に柔軟に対応できます。
- これにより、豊富な関数セットを備えたスクリプト言語が可能になります。
- SAP データサービスは以下と統合できます SAP LTレプリケーションサーバー(SLT) トリガーベースのテクノロジーを使用します。SLTは、すべての SAP または非SAP ソーステーブルは、変更データの取得と、ソーステーブルからの差分データの転送を可能にします。
- ダッシュボードとプロセス監査によるデータ検証。
- スケジュール設定機能と監視ダッシュボードを備えた管理ツール。
- デバッグ、組み込みのプロファイリング、およびデータ表示。
- SAP データサービスは、幅広いソースとターゲットをサポートしています。
- 例えば、あらゆるアプリケーション SAP.
- 一括データ読み込みと変更データキャプチャ機能を備えた、あらゆるデータベースに対応。
- ファイル: 固定幅、カンマ区切り、COBOL、XML、および Excel.
これらの機能は、それぞれが明確な役割を持つ、少数のインストール可能なコンポーネントによって提供されます。
の構成要素 SAP データサービス
SAP データサービスは以下のコンポーネントで構成されています。
- デザイナー これは、データウェアハウスにデータを格納するジョブを作成、テスト、実行できる開発ツールです。開発者は、ソースからターゲットへのフロー図でアイコンを選択することで、オブジェクトを作成し、構成できます。ワークフローとデータフローを指定することで、アプリケーションを作成することもできます。Data Services Designerを開くには、次の場所に移動します。 スタートメニュー -> すべてのプログラム -> SAP データサービス -> データサービスデザイナー.

- ジョブサーバー これは、データサービス処理エンジンを起動し、エンジンおよびデータサービススイートへのインターフェースとして機能するアプリケーションです。
- エンジン – データサービスエンジンは、アプリケーションで定義された個々のジョブを実行します。
- 倉庫 – リポジトリは、Designerで定義済みのオブジェクトとユーザー定義のオブジェクト(ソースとターゲットのメタデータ、変換ルール)を格納するデータベースです。リポジトリには次の2種類があります。
- ローカルリポジトリ (デザイナーおよびジョブサーバーで使用されます。)
- 中央リポジトリ (オブジェクト共有およびバージョン管理に使用されます。)
- アクセスサーバー アクセスサーバーは、Webアプリケーション、データサービスジョブサーバー、およびエンジン間でメッセージを転送します。
- 管理者 – Web管理者は、以下に詳述するように、ブラウザベースのデータサービスリソースの管理を提供します。
- 設定、起動、停止ping リアルタイムサービス。
- バッチジョブのスケジュール設定、監視、および実行。
- ジョブサーバー、アクセスサーバー、およびリポジトリの使用状況を設定します。
- ユーザーの管理。
- バッチジョブとリアルタイムサービスをWebサービスを通じて公開する。
- アダプターの構成と管理。
各コンポーネントの役割を知るだけでは、全体像の半分しか把握できません。以下のアーキテクチャ図は、負荷がかかった際に各コンポーネントがどのように通信するかを示しています。
SAP データサービス Archi構造
データサービスアーキテクチャは、以下のコンポーネントで構成されています。
- 中央リポジトリ – ジョブサーバーのリポジトリ構成、セキュリティ管理、バージョン管理、およびオブジェクト共有に使用されます。
- デザイナー – プロジェクト、ジョブ、ワークフロー、データフローを作成し、それらを実行するために使用されます。
- ローカルリポジトリ – ここでは、ジョブ、ワークフロー、データフローを作成、変更、開始できます。
- ジョブサーバーとエンジン – ジョブを管理します。
- アクセスサーバー – 開発者がリポジトリ内で作成したリアルタイムジョブを実行するために使用されます。
下の図は、データサービスとその構成要素間の関係を示しています。

SAP ボディ Archi構造
デザイナーズウィンドウディテール
デザイナーは開発者が最も多くの時間を費やすコンポーネントであるため、そのレイアウトを最初に習得しておく価値があります。データサービスデザイナーの各セクションの詳細は以下のとおりです。
- ツールバー (開く、保存する、戻る、検証する、実行するなどの操作に使用されます。)
- プロジェクトエリア (ジョブ、ワークフロー、データフローを含む現在のプロジェクトが含まれています。データサービスでは、すべてのエンティティはオブジェクトです。)
- ワークスペース (オブジェクトを定義、表示、変更するアプリケーションウィンドウ領域)
- ローカルオブジェクトライブラリ (これには、変換、ジョブ、ワークフロー、データフローなどのローカルリポジトリオブジェクトが含まれます。)
- ツールパレット (ツールパレットのボタンを使用すると、ワークスペースに新しいオブジェクトを追加できます。)

オブジェクト階層
下の図は、データサービス内の主要なオブジェクトタイプの階層関係を示しています。

注意: 以下の凡例は、階層構造におけるオプション要素を示しています。

ワークフローと条件分岐はオプションです。
使用されるオブジェクト SAP データサービスの詳細は以下のとおりです。
| オブジェクト | 詳細説明 |
|---|---|
| プロジェクト | プロジェクトは、デザイナーウィンドウにおける最上位のオブジェクトです。プロジェクトを使用すると、データサービスで作成した他のオブジェクトを整理できます。一度に開くことができるプロジェクトは1つだけで、「開いている」とは「プロジェクト領域に表示されている」ことを意味します。 |
| Job | 「ジョブ」とは、実行のために個別にスケジュールを組むことができる最小の作業単位のことです。 |
| スクリプト | プロシージャ内の行のサブセット。 |
| ワークフロー | 「ワークフロー」とは、複数のデータフローを統合して、ジョブ全体に対する一貫性のある作業の流れを構築することです。ワークフローは必須ではありません。ワークフローは、以下のことを可能にする手順です。
|
| データフロー | 「データフロー」とは、ソースデータをターゲットデータに変換するプロセスのことです。データフローは再利用可能なオブジェクトであり、常にワークフローまたはジョブから呼び出されます。データフローは、以下の目的で使用されます。
|
| データストア | データサービスをソースデータベースとターゲットデータベースに接続する論理チャネル。データストア:
|
| Target | データサービスがソースからデータをロードするテーブルまたはファイル。 |
SAP データサービス vs SLT vs DXC
SAP データサービスは、 データプロビジョニング のオプション SAP HANAの場合、間違った方法を選択すると、どれだけ調整しても取り戻せないコストが発生します。以下の表は、3つのサーバーサイド方式を比較したものです。
| 基準 | SAP データサービス | SLT | DXC |
|---|---|---|---|
| レイテンシ | バッチ処理またはスケジュール処理 | リアルタイム | データソースによってスケジュールされたバッチ |
| 変換 | 完全なETL、データクレンジング、およびプロファイリング | シンプルなフィルターとフィールドルール | 元以外ではtracトーロジック |
| ソース範囲 | SAP と非SAPファイル、アプリケーション | SAP と非SAP データベースを追加しました | SAP ビジネススイートのみ |
| 追加のサーバーが必要です | はい、ジョブサーバー | 通常ははい | いいえ |
| に最適 | データ品質と複数ソースの統合 | Operaライブデータに関する全国的な報告 | 既存のビジネスコンテンツの再利用例tracトー |
つまり、選択する SAP データが取り込まれる前に、データのクレンジング、結合、または標準化が必要な場合は、データサービスを選択します。レポートがトランザクションの発生を反映する必要がある場合は、SLTを選択します。 DXC 実績のあるビジネスコンテンツtractor は既に必要な意味論を生成します。繰り返しスケジュールのない単発データセットの場合、 フラットファイルのアップロード 3つの方法のどれを設定するよりも速い。
データを読み込む方法 SAP ソーステーブルの使用 SAP データサービス
データサービスにおけるすべての要素はオブジェクトです。ソースデータベースとターゲットデータベースごとに、個別のデータストアが必要です。
データを読み込むための完全な手順 SAP ソーステーブルは以下に示されています。その後、各手順が詳細に説明されています。
- ソースとBODSの間にデータストアを作成する
- メタデータ(構造)をBODSにインポートする
- インポートサーバーの設定
- メタデータをHANAシステムにインポートする
- BODSとHANAの間にデータストアを作成する
- プロジェクトを作成する
- ジョブを作成する(バッチ処理またはリアルタイム処理)
- ワークフローを作成する
- データフローを作成する
- データフローにオブジェクトを追加する
- ジョブを実行する
- HANAでデータプレビューを確認してください
ステップ1) データストアを間に作成します SAP ソースとBODS。
- データを読み込むには SAP ソース SAP HANAを通じて SAP BODSではデータストアが必要です。そのため、まずデータストアを作成します。手順は以下のとおりです。プロジェクト -> 新規 -> データストア

- 「新しいデータストアを作成」というポップアップが表示されます。以下の詳細を入力してください。
- データストア名「ds_ecc」を入力してください。
- データストアタイプ名を「SAP アプリケーション」。
- データベースサーバー名を入力してください。
- ユーザー名とパスワードを入力してください。
- 「適用」ボタンをクリックします。
- 「OK」ボタンをクリックしてください。

- データストアが作成されます。作成されたデータストアは以下のように表示されます。
- ローカルオブジェクトライブラリに移動してください。
- 「データストア」タブを選択してください。
- データストア「ds_ecc」が表示されます。

ステップ2) メタデータ(構造)をBODSサーバーにインポートします。
ECCからBODSへのデータストアを作成しました。次に、ECCからBODSへメタデータをインポートします。インポートするには、以下の手順に従ってください。
- データストア「ds_ecc」を選択して右クリックします。
- 「名前でインポート」オプションを選択してください。

名前によるインポートのポップアップが表示されます。以下の詳細を入力してください。
- 「タイプ」を「テーブル」として選択します。
- インポートするテーブルの名前を入力してください。ここでは、KNA1テーブルをインポートします。
- 「インポート」ボタンをクリックしてください。「ds_ecc」データソースの「テーブル」ノードの下にKNA1テーブルが表示されます。

テーブルのメタデータは、以下のようにデータストアds_eccにインポートされます。

ステップ3) インポートサーバーを設定します。
これまでのところ、ECC用に作成されたデータストア「ds_ecc」にテーブルをインポートしました。 SAP BODS接続。データをインポートするには SAP HANAインポートサーバーを設定する必要があります。
- これを行うには、に行く クイックビュー -> インポートサーバーの設定 に直面します。

- 「システムを選択」のポップアップが表示されます。 SAP HANAシステム(ここではHDB)は以下のとおりです。

- 「次へ」ボタンをクリックしてください。データサービス認証情報の入力を求めるポップアップが再び表示されます。以下の情報を入力してください。
- SAP BODSサーバーのアドレス(ここではBODS:6400)。
- SAP BODSリポジトリ名(HANAUSERリポジトリ名)。
- ODBCデータソース(ZTDS_DS)。
- デフォルトポート SAP BODSサーバー(8080)。

「完了」ボタンをクリックしてください。
ステップ4) メタデータをHANAシステムにインポートします。
インポートサーバーが構成されたので、メタデータをインポートできます。 SAP BODS サーバー。
- クイックビューで「インポート」オプションをクリックします。
- インポートオプションのポップアップが表示されます。「メタデータの選択的インポート」オプションを選択してください。

「次へ」ボタンをクリックしてください。
「メタデータの選択的インポート」というポップアップが表示され、そこで対象システムを選択します。
- まず SAP HANAシステム(ここではHDB)

「次へ」ボタンをクリックしてください。
ステップ5) BODSとHANAの間にデータストアを作成します。
BODSでは、ソースとターゲット用に別々のデータストアが必要です。ソースデータストアは既に存在するため、次にBODSとHANA間のターゲットデータストアを「DS_BODS_HANA」という名前で作成します。
- [プロジェクト] -> [新規] -> [データストア] に移動します。
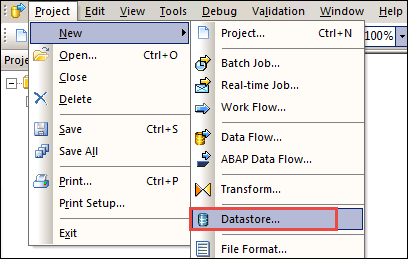
- 以下のような「新規データストアの作成」画面が表示されます。
- データストア名(DS_BODS_HANA)を入力してください。
- データストアの種類として「データベース」を入力してください。
- データベースの種類を入力してください SAP ハナ。
- データベースのバージョンを選択してください。
- 入力する SAP HANAデータベースサーバー名。
- ポート名を入力してください SAP HANA データベース。
- ユーザー名とパスワードを入力してください。
- 「自動データ転送を有効にする」にチェックを入れてください。

「適用」をクリックし、次に「OK」ボタンをクリックしてください。
データストア「DS_BODS_HANA」は、以下のようにローカルオブジェクトライブラリの「データストア」タブに表示されます。

- 次に、テーブルをデータストア「DS_BODS_HANA」にインポートします。
- データストア「DS_BODS_HANA」を選択し、右クリックします。
- 「名前でインポート」を選択してください。

- 以下のように「名前でインポート」のポップアップが表示されます。
- 「タイプ」を「テーブル」として選択します。
- 名前をKNA1と入力してください。
- 所有者はHanauserとして表示されます。
- 「インポート」ボタンをクリックしてください。

このテーブルは「DS_BODS_HANA」データストアにインポートされます。テーブル内のデータを表示するには、以下の手順に従ってください。
- データストア「DS_BODS_HANA」内のテーブル「KNA1」をクリックします。
- データは表形式で表示されます。

ステップ6)プロジェクトを定義する。 プロジェクトは、関連するオブジェクトをグループ化して整理します。プロジェクトには、任意の数のジョブ、ワークフロー、およびデータフローを含めることができます。
- 「デザイナープロジェクト」メニューを開いてください。
- 「新規」オプションを選択してください。
- 「プロジェクト」オプションを選択してください。

以下のように、新規プロジェクト作成用のポップアップが表示されます。プロジェクト名を入力し、「作成」ボタンをクリックしてください。すると、プロジェクトフォルダ(この例ではBODS_DHK)が作成されます。

ステップ7)仕事内容を定義する。 ジョブは再利用可能なオブジェクトです。ワークフローとデータフローが含まれています。ジョブは手動で実行することも、スケジュールに基づいて実行することもできます。BODSプロセスを実行するには、ジョブを定義する必要があります。
JOB_Customerという名前のジョブを作成します。
- 前の手順で作成したプロジェクト(BODS_DHK)を選択し、右クリックして「新規バッチジョブ」を選択します。
- 名前を「JOB_Customer」に変更します。

ステップ8)ワークフローを定義する。
- プロジェクトエリアで「JOB_Customer」というジョブを選択してください。
- ツールパレットのワークフローボタンをクリックします。空白のワークスペース領域をクリックします。ワークスペースにワークフローアイコンが表示されます。
- ワークフローの名前を「WF_Customer」に変更してください。

ワークフロー名をクリックすると、ワークスペースにそのワークフローの空のビューが表示されます。

ステップ9)データフローを定義します。
- ワークフロー「WF_Customer」をクリックしてください。
- ツールパレットのデータフローボタンをクリックします。空白のワークスペース領域をクリックします。ワークスペースにデータフローアイコンが表示されます。
- データフローの名前を「DF_Customer」に変更してください。
- データフローは、左側のプロジェクトエリアのジョブ名の下にも表示されます。

ステップ10)データフローにオブジェクトを追加します。
データフロー内では、ソースデータをターゲットテーブルに適した形式に変換するための指示を提供します。
3つのオブジェクトが使用されます。
- ソースのオブジェクト。
- ターゲットテーブルのオブジェクト。
- クエリ変換用のオブジェクト。ソースからターゲットへの列のマッピングを行います。
データフロー「DF_Customer」をクリックします。以下のような空白のワークスペースが表示されます。
- ソースのオブジェクトを指定します – データストア「ds_ecc」に移動し、テーブルKNA1を選択して、空のデータフロー画面にドラッグアンドドロップします。
- 対象のオブジェクトを指定します – リポジトリからデータストア「DS_BODS_HANA」を選択し、テーブルKNA1を選択します。
- それをワークスペースにドラッグアンドドロップして、「作成」を選択します。 Target「」オプション。これで、ソーステーブルとターゲットテーブルの2つのテーブルが作成されます。

- クエリ変換 これは、ユーザー固有の条件に基づいて入力スキーマに従ってデータを取得し、ソースからターゲットへデータを転送するために使用されるツールです。
- ツールパレットからクエリ変換アイコンを選択し、ワークスペース内のソースオブジェクトとターゲットオブジェクトの間にドラッグアンドドロップします。
- クエリオブジェクトをソースにリンクします。
- クエリオブジェクトを対象テーブルにリンクします。

Doubleクエリアイコンをクリックして、入力スキーマの列を出力スキーマにマッピングします。ping ウィンドウが表示され、そこで以下の操作を行います。
- ソーステーブルKNA1が選択されました。
- ソーステーブルからすべての列を選択し、右クリックして「出力にマッピング」を選択します。
- 出力先としてクエリが選択され、列がマッピングされます。

プロジェクトを保存して検証します。 検証アイコンをクリックしてください。検証が成功したことを示すポップアップが表示されます。

ステップ11)ジョブを実行します。 ジョブを実行するには、以下の手順に従ってください。
- プロジェクトエリアのアイコンを選択してプロジェクトを開き、作成したプロジェクトを選択します。
- ジョブを選択して右クリックします。
- ジョブを実行するには、「実行」オプションを選択してください。
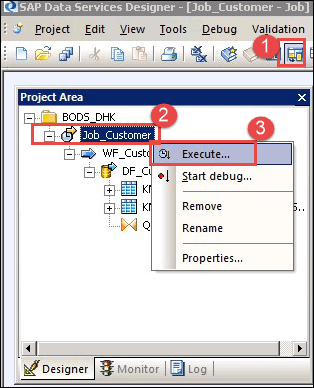
ジョブの実行後、ジョブログウィンドウが表示され、ジョブに関するすべてのメッセージが表示されます。最後のメッセージは「ジョブ」です。正常に完了しました。

ステップ12)データの検証と確認 SAP HANA データベース。
- にログインします。 SAP HANAデータベース経由 SAP ハナスタジオそして、HANAUSERスキーマを選択します。
- 「テーブル」ノードで「KNA1」テーブルを選択します。
- テーブルKNA1を右クリックし、「データプレビューを開く」を選択します。
- BODSプロセスによってロードされたKNA1データは、データプレビュー画面に表示されます。

ソーステーブルとこのプレビューの行数が一致すれば、ロードが正しく完了したことが確認できます。その後、管理者からジョブを繰り返し実行するようにスケジュール設定できます。
