
SAP HANA計算ビュー:種類と作成方法
 メイソンガルシア
⚡ スマートサマリー
計算ビュー SAP HANAは最も強力な情報ビューです。テーブル、カラムビュー、分析ビュー、その他の計算ビューを、結合、ユニオン、射影、集計、ランクノードを通じて組み合わせます。
計算ビューとは何ですか?
SAP HANA 計算ビューは強力な情報ビューです。
SAP HANA 分析ビューのメジャーは、1 つのファクト テーブルからのみ選択できます。情報ビューでさらに多くのファクト テーブルが必要な場合は、計算ビューが役立ちます。計算ビューは複雑な計算をサポートします。
計算ビューのデータ基盤には、テーブル、列ビュー、分析ビュー、計算ビューを含めることができます。
作成できます ジョイン、データ ソースのユニオン、集計、およびプロジェクション。
計算ビューには複数のメジャーを含めることができ、多次元レポートに使用することも、リスト タイプのレポートで使用されるメジャーを使用しないこともできます。
の特徴 SAP HANAの計算ビューは以下のとおりです –
- 複雑な計算をサポートします。
- OLTP および OLAP モデルをサポートします。
- クライアントの処理、言語、通貨換算をサポートします。
- 結合、投影、集計、ランクなどをサポートします。
SAP HANA計算ビューには2つのタイプがあります。
- SAP HANAグラフィカル計算ビュー(作成者: SAP HANA Studio グラフィカル エディター)。
- SAP HANAスクリプトベースの計算ビュー(SQLスクリプトによって作成) SAP ハナスタジオ).
グラフィカル表示とスクリプトベース表示の比較
この2つの方式は同じ種類のオブジェクトを生成するが、構築方法と維持管理方法が大きく異なり、一度ビューが生産段階に入ると、選択を覆すのは困難である。
| グラフィカル | スクリプトベース | |
|---|---|---|
| XNUMXWの出力で | エディターでノードをドラッグアンドドロップします | CE_ または SQL ブロック内の SQLScript |
| 最適化 | エンジンは実行時に未使用のノードを削除できます | 記述通りに実行されるため、最適化の余地は少ない。 |
| 読みやすさ | シナリオ図はそれ自体を文書化する | それは完全に著者次第だ |
| 機能 | ほとんどの要件を満たしています | ノードの組み合わせでは表現できないロジックを処理します |
| メンテナンス | どんなモデラーでも理解できる | SQLScriptのスキルが必要 |
| おすすめ | デフォルトの選択 | グラフィックではどうしてもできない場合にのみ |
パフォーマンスこそが決定的なポイントです。グラフィカルビューでは、クエリのどの列も必要としない出力を持つノードをHANAが破棄できるため、未使用の結合はコストがかかりません。一方、スクリプトベースのビューは、含まれるすべてのステートメントを例外なく実行します。最初はグラフィカルビューを使用し、要件が満たされた場合にのみ、単一のノードをスクリプトビューに移行してください。
SAP HANA グラフィカル計算ビュー
In SAP HANA分析ビュー、メジャーは XNUMX つのテーブルからのみ選択できます。
したがって、別のテーブルのメジャーを含むビューの要件がある場合、分析ビューでは実現できず、計算ビューで実現できます。
したがって、この場合、テーブルごとに XNUMX つの異なる分析ビューを使用し、それらを計算ビューで結合できます。
2 つの分析ビュー「AN_PURCHASE_ORDER」と「AN_FI_DOCUMENT」を結合して、グラフィカル計算ビュー「CA_FI_LEDGER」を作成します。
CA_FI_LEDGER は、発注書に関連する財務文書の詳細を表示します。
ステップ1) このステップでは、
- パッケージ (ここではモデリング) に移動し、右クリックします。
- 新しいオプションを選択します。
- 「計算ビュー」を選択します。
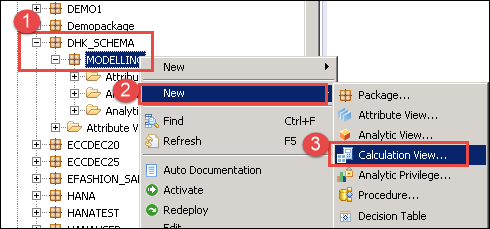
計算ビューエディタが表示され、シナリオパネルが以下のように表示されます。
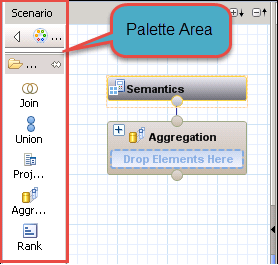
シナリオパネルの詳細は以下の通りです –
パレット: このセクションには、計算ビューを構築するためのソースとして使用できる以下のノードが含まれています。ノードには 5 種類あり、
- 参加: このノードは、XNUMX つのソース オブジェクトを結合し、結果を次のノードに渡すために使用されます。 結合タイプには、内部結合、左外部結合、右外部結合、およびテキスト結合があります。 注意: 結合ノードに追加できるソース オブジェクトは XNUMX つだけです。
- 連合: これは、複数のソース間ですべての結合操作を実行するために使用されます。ソースは n 個のオブジェクトにすることができます。
- 投影: これは、結合、集計、ランクなどの次のノードで使用する前に、列の選択、データのフィルター、追加の列の作成に使用されます。 注意: Projection ノードにはソース オブジェクトを XNUMX つだけ追加できます。
- 集計: これは、選択した属性に基づいて特定の列で集計を実行するために使用されます。
- ランク: これは、SQL の RANK 関数を正確に置き換えるものです。 要件に基づいてパーティションと order by 句を定義できます。
ステップ2)
- パレットから [投影] ノードをクリックし、発注書の分析ビューからシナリオ エリアにドラッグ アンド ドロップします。 名前を「Projection_PO」に変更します。
- パレットから [投影] ノードをクリックし、FI ドキュメント分析ビューのシナリオ領域にドラッグ アンド ドロップします。 名前を「Projection_FI」に変更します。
- コンテンツフォルダから分析ビュー「AN_PURCHASE_ORDER」と「AN_FI_DOCUMENT」をそれぞれ「Projection_PO」ノードと「Projection_FI」ノードにドラッグアンドドロップします。
- パレットから「ノードの結合」をクリックし、シナリオエリアにドラッグ&ドロップします。
- Projection_PO ノードを Join_1 ノードに結合します。
- Projection_FI ノードを Join_1 ノードに結合します。
- パレットから集計ノードをクリックし、シナリオエリアにドラッグ&ドロップします。
- Join_1 ノードを Aggregation ノードに結合します。
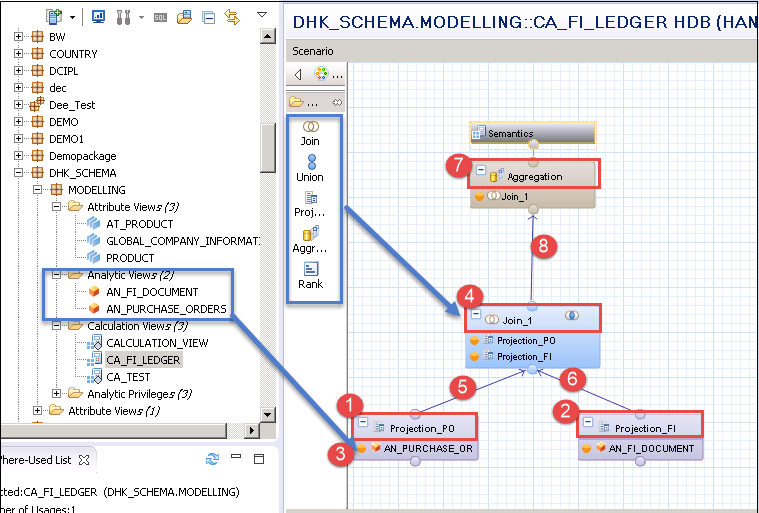
計算ビューを作成するために、XNUMX つの分析ビューを追加しました。
ステップ3) 集計の下の Join_1 ノードをクリックすると、詳細セクションが表示されます。
- 出力のために Projection_PO ノードからすべての列を選択します。
- 出力のために Projection_FI ノードからすべての列を選択します。
- Projection_PO ノードを、列 Projection_PO.PO_Number = Projection_FI.PO_NO で Projection_FI ノードに結合します。
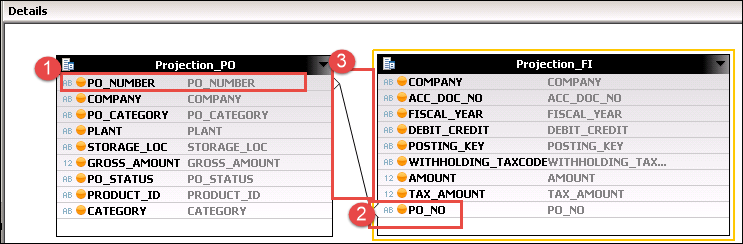
ステップ4) このステップでは、
- 集計ノードをクリックすると、ペインの右側に詳細が表示されます。
- 詳細ウィンドウの右側に表示される Join_1 から出力する列を選択します。
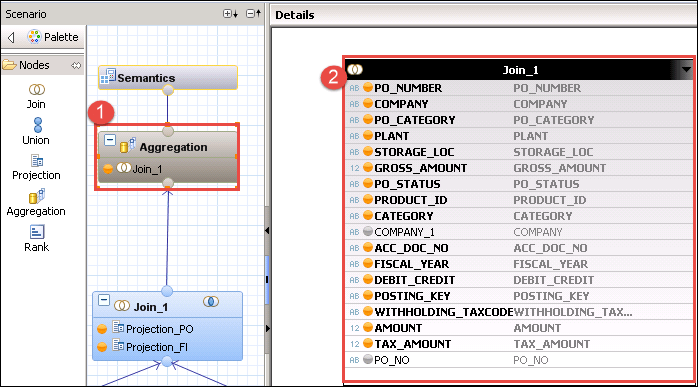
ステップ5) ここで、「セマンティクス ノード」をクリックします。
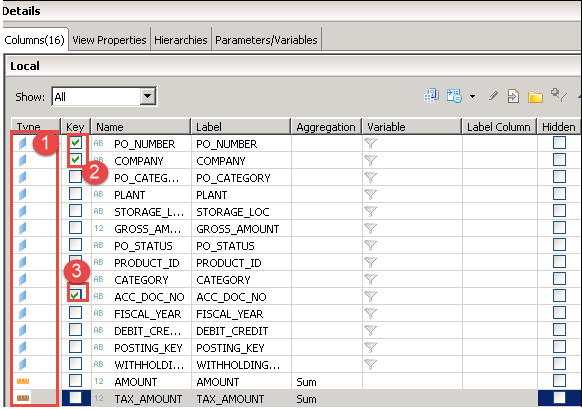
以下のように詳細画面が表示されます。列の属性とメジャータイプを定義し、この出力のキーをマークします。
- 属性と測定値を定義します。
- PO_Number と COMPANY をキーとしてマークします。
- ACC_DOC_NO をキーとしてマークします。
ステップ6) ウィンドウの上部バーから、計算ビューを検証してアクティブにします。
- 「検証」アイコンをクリックします。
- 「アクティブ化」アイコンをクリックします。
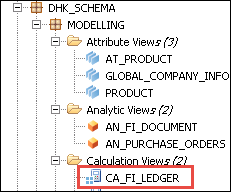
計算ビューがアクティブになり、以下のようにモデリング パッケージの下に表示されます。
計算ビューを選択して右クリックし、データプレビューを選択します。
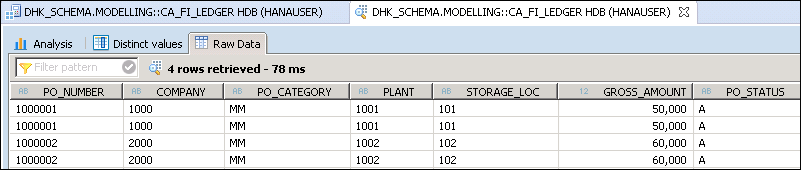
XNUMX つの分析ビューを追加し、両方の分析ビューからメジャー (TAX_AMOUNT、GROSS_AMOUNT) を選択します。
以下のようにデータプレビュー画面が表示されます。
スクリプトベースビューにおけるCE関数
⚠️ バージョンに関する注記: 計算エンジン計画演算子、以下で説明する CE_ 関数は、 SAP既存のコードの多くがこれらを使用しているため、ここに記載されていますが、新規開発では標準SQLを使用してください。オプティマイザは現在、標準SQLを少なくとも同等に処理できます。CE_関数とSQLを1つのステートメントで混在させることも、実行プランの悪化の原因として知られています。
CE 機能は計算エンジン計画とも呼ばれます Operaトール (CE Operators) は SQL ステートメントの代替です。
CE機能はXNUMX種類 –
データソースアクセス機能
この関数は、列テーブルまたは列ビューをテーブル変数にバインドします。以下は、データソースアクセス関数のリストです。
- CE_COLUMN_TABLE
- CE_JOIN_VIEW
- CE_OLAP_VIEW
- CE_CALC_VIEW
リレーショナル Operaトル関数
リレーショナルを使用する Operaユーザーは、 SQL 評価中にプロセッサと直接通信し、計算エンジンと通信します。以下にいくつかの関係式を示します。 Operator 機能一覧 –
- CE_JOIN(2つのソース間で内部結合を実行し、必要な列/データを読み込むために使用されます。)
- CE_RIGHT_OUTER_JOIN(2つのソース間で右外部結合を実行し、クエリされた列を出力に表示するために使用されます。)
- CE_LEFT_OUTER_JOIN(ソース間で左外部結合を実行し、クエリされた列を出力に表示するために使用されます)。
- CE_PROJECTION(この関数は、ソースから特定の列を表示し、フィルターを適用してデータを絞り込みます。列名のエイリアス機能も提供します。)
- CE_CALC(これは、業務要件に基づいて追加の列を計算するために使用されます。グラフィカルモデルの計算列と同じです。)
以下は、 SQL CE 機能といくつかの例-
| クエリ名 | SQLクエリ | CEビルトイン機能 |
|---|---|---|
| 列テーブルに対するクエリの選択 | 「COLUMN_TABLE」から C、D を選択します。 | CE_COLUMN_TABLE(“COLUMN_TABLE”,[C,D]) |
| 属性ビューでクエリを選択 | 「ATTRIBUTE_VIEW」から C、D を選択します | CE_JOIN_VIEW(“ATTRIBUTE_VIEW”,[C,D]) |
| 分析ビューでクエリを選択します | 「ANALYTIC_VIEW」から SELECT C、D、SUM(E) C、D ごとにグループ化 | CE_OLAP_VIEW(“ANALYTIC_VIEW”,[C,D]) |
| 計算ビューでクエリを選択 | 「CALCULATION_VIEW」から C、D、SUM(E) をグループ化して C、D を選択します | CE_CALC_VIEW(“CALCULATION_VIEW”,[C,D]) |
| どこにあるのか | SELECT C, D, SUM(E) FROM “ANALYTIC_VIEW” WHERE C = 'value' | var1 = CE_COLUMN_TABLE(“COLUMN_TABLE”); CE_PROJECTION(:var1,[C,D],'”C” = ”value”') |
計算ビューの種類:ディメンション、キューブ、スター結合付きキューブ
電流プローブ SAP HANAのリリースでは、計算ビューを作成する際にデータカテゴリを指定する必要があり、その選択によってビューの機能やレポートツールによる処理方法が決まります。
| データカテゴリー | 測定項目が含まれています | スター参加可能 | 置き換え |
|---|---|---|---|
| 次元 | いいえ | いいえ | 属性ビュー |
| キューブ | はい | いいえ | 単純な分析シナリオ |
| スター結合キューブ | はい | はい | 分析的視点 |
そのため、現在のプロジェクトでは計算ビューのみを構築することがよくあります。ディメンションカテゴリのビューは、 属性ビュー、そしてスタージョイン付きキューブは、 分析的視点つまり、1つのオブジェクトタイプでモデル全体をカバーできます。既存の属性ビューと分析ビューは引き続き機能し、概念は上記のカテゴリに直接対応します。
計算ビューのパフォーマンスに関するヒント
計算ビューは柔軟性が高いため、構築方法を誤ると、ノードの配置方法によって同じシナリオでも実行時間が1秒から1分になることがあります。この差の大部分は、6つのルールでカバーできます。
- できるだけ早い段階で選別する。 ソースに最も近い投影法にフィルタを適用してください。集計後にフィルタリングを行うということは、まずデータセット全体が集計され、その後その大部分が破棄されることを意味します。
- 可能であれば、参加前に情報を集約する。 2つの大きな詳細データセットを結合してから集約すると、それぞれのデータセットを先に集約するよりもはるかに多くの行が移動します。
- 必要な列のみを選択してください。 ノードを通過するすべての列は、実行全体を通してメモリに保持され、使用されない列はノードの枝刈りを妨げます。
- 類似データを結合する場合は、結合よりもユニオンを使用する方が望ましい。 実績と計画を積み重ねることは、結合です。それを結合として表現すると行が倍増し、その影響を元に戻すためにフィルターが必要になります。
- 結合カーディナリティに注目してください。 データが 1..N であるにもかかわらず 1..1 と宣言すると、行が重複し、すべてのメジャーが膨張します。これは、合計が間違っている最も一般的な原因です。
- ビューを深く重ねすぎないようにしましょう。 分析ビューの計算ビュー、さらにその下の計算ビューという構造は合法ではありますが、最適化が難しく、デバッグも困難です。通常は2階層で十分です。
推測するのではなく、エディタのパフォーマンス分析ツールを使用してください。計画を立ててください。Viz どのノードが時間を消費したかを示し、答えは多くの場合、1ノード遅れて配置されたフィルタです。より広範なアプローチについては、 SAP HANAモデリング チュートリアル、および手続き的な代替案 SQLスクリプト.
