
のロケーター Selenium
 Krishna ルンタ
⚡ スマートサマリー
のロケーター Selenium これらは、テキストボックス、ボタン、チェックボックスなどのGUI要素を識別するように自動化エンジンに指示するコマンドです。このリファレンスでは、ID、名前、リンクテキスト、DOM、およびXPathロケーターの種類について、実用的な例、構文規則、および信頼性の高いWeb自動化スクリプトを作成するための選択戦略を解説します。
ロケーターとは何ですか Selenium?
ロケーターは指示するコマンドです Selenium IDEまたは Selenium WebDriver を、テキスト ボックス、ボタン、リンク、チェックボックスなど、アクションを実行する必要のある正しい GUI 要素に指定します。正しい GUI 要素を識別することは、信頼性の高い自動化スクリプトを作成するための前提条件です。しかし、正確な識別は想像以上に困難です。場合によっては、間違った要素を操作したり、要素を全く操作しなかったりすることがあります。これに対処するために、 Selenium GUI要素を正確にターゲットにできる、さまざまなロケーター戦略を提供します。
「open」コマンドなど一部のコマンドはロケーターを必要としませんが、大多数のコマンドは Selenium コマンドは要素ロケーターに依存します。 ロケーターの選択は、主にテスト対象アプリケーション(AUT)に依存します。 このチュートリアルでは、Facebookと Mercury 各アプリケーションがサポートするロケーターに基づいて、ツアーデモサイト(newtours.demoaut)を使用します。同様に、独自の テスト プロジェクトでは、要素ロケーターを選択します。 Selenium WebDriverは、アプリケーションの構造に基づいて動作します。
IDで探す
これは要素を特定する最も一般的な方法です。なぜなら、IDはページ上の各要素に対して一意になるように設計されているからです。ID属性が存在する場合は、高速で安定した読みやすいテストスクリプトを作成するために、まずID属性を使用することをお勧めします。
Target フォーマット: id=要素のID
この例では、Facebookのデモページを使用します。 Mercury Toursでは、メインのフォームフィールドにID属性を使用していません。
ステップ1) このデモページを使用してください https://demo.guru99.com/test/facebook.html テストのため。ブラウザの組み込み開発者ツールを使用して「Email または Phone」テキスト ボックスを検査します (Chrome、Edge、または Firefox) そしてそのIDをメモします。この場合、IDは「email」です。

ステップ2) 起動する Selenium IDEで「id=email」と入力し、 Target ボックス。検索ボタンをクリックすると、「メールまたは電話」テキストボックスが緑色の枠線で黄色にハイライト表示されます。 Selenium IDEは要素を正しく検出しました。

名前による検索
名前による要素の特定は、ID による特定と似ていますが、 「名前=」 代わりに接頭辞を使用します。この方法は、要素にIDがないが、名前属性が定義されている場合に便利です。
Target フォーマット: name=要素の名前
以下のデモンストレーションでは、 Mercury サイト上の重要なフォーム要素すべてに名前属性が付いているため、ツアー機能が有効になっています。
ステップ1) MFAデバイスに移動する https://demo.guru99.com/test/newtours/ ブラウザの開発者ツールを使用して、「ユーザー名」テキストボックスを調べます。その名前属性をメモしておいてください。

ここで、要素名は「userName」です。
ステップ2) In Selenium IDEでは、 Target ボックスをクリックし、[検索] ボタンをクリックします。 Selenium IDEはユーザー名テキストボックスをハイライト表示することで、その位置を特定する必要があります。

フィルターを使用して名前で要素を検索する方法
フィルターは、複数の要素が同じ名前属性を共有する場合に便利です。 フィルターとは、同じ名前を持つ要素を区別するために使用される追加属性です。 フィルターなし、 Selenium デフォルトでは、最初に一致した要素のみが選択されます。
Target フォーマット: 名前=要素の名前フィルター=フィルターの値
具体例を挙げて説明しましょう。
ステップ1) にログオンします Mercury ツアー。
にサインイン Mercury ユーザー名とパスワードの両方に「tutorial」を使用してツアーに参加してください。以下に示すように、フライト検索ページが表示されます。

ステップ2) 開発者ツールを使用してVALUE属性を調べてください。
往復と片道のラジオボタンは「tripType」という同じ名前を共有していますが、VALUE属性が異なるため、それぞれの値をフィルターとして使用できます。

ステップ3) エディターの最初の行をクリックしてください。
- まず、一方通行のラジオボタンにアクセスします。 Selenium IDEエディタ。
- コマンドボックスに「click」と入力します。
- Target ボックスに「name=tripType value=oneway」と入力します。「value=oneway」の部分がフィルターとして機能します。

ステップ4) 「検索」ボタンをクリックします。
注意してください Selenium IDEは「一方通行」ラジオボタンを緑色で強調表示し、VALUE属性を介して要素に正常にアクセスできたことを確認します。

ステップ5) 「一方通行」のラジオボタンを選択してください。
キーボードの「X」キーを押してクリックコマンドを実行してください。これで「一方通行」ラジオボタンが選択されました。

同じ操作を「往復」ラジオボタンに対しても実行できます。この場合、ターゲットとして「name=tripType value=roundtrip」を使用します。
リンクテキストによる検索
このロケーター戦略は、ハイパーリンクテキストにのみ適用されます。リンクにアクセスするには、ターゲットの先頭に「link=」を付け、その後に表示されているハイパーリンクテキストを続けます。この方法は非常に読みやすく、ナビゲーションテストに適しています。
Target フォーマット: リンク=リンクテキスト
次の例では、 Mercury ツアーのホームページ。
ステップ1)
- まず、ログアウトしていることを確認してください。 Mercury ツアー。
- に移動します Mercury ツアーのホームページ。
ステップ2)
- 開発者ツールを使用して「登録」リンクを調べてください。リンクテキストは、開始アンカータグと終了アンカータグの間に表示されます。
- この場合、リンクテキストは「登録」です。リンクテキストをコピーしてください。
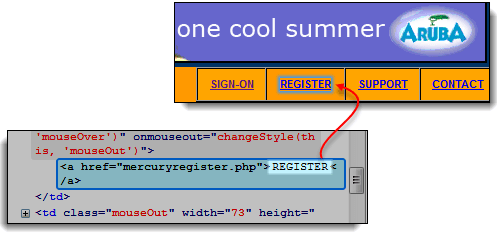
ステップ3) リンクテキストをコピーして貼り付けます Selenium IDE Target ボックス。先頭に「link=」を付けます。

ステップ4) 「検索」ボタンをクリックします。 Selenium IDEはREGISTERリンクを正しくハイライト表示します。

ステップ5) さらに確認するには、コマンドボックスに「clickAndWait」と入力して実行します。 Selenium IDEは「登録」リンクを正常にクリックし、下記の登録ページに移動します。

DOM (ドキュメント オブジェクト モデル) による検索
その ドキュメントオブジェクトモデル(DOM)簡単に言うと、HTML要素がノードのツリーとしてどのように構造化されているかを説明するものです。 Selenium IDE はこのツリーをナビゲートしてページ要素にアクセスできます。この方法を使用すると、 Target box は常に「dom=document…」で始まります。「dom=」という接頭辞は通常省略されます。 Selenium IDEは、「document」で始まる値を自動的にDOMパスとして解釈します。
DOM を介して要素を見つけるには、4 つの基本的な方法があります。 Selenium:
- getElementByIdを
- getElementsByName
- dom:name (名前付きフォーム内の要素にのみ適用されます)
- dom:インデックス
DOM による検索 – getElementById
まず、DOMのgetElementByIdメソッドを調べてみましょう。 Seleniumこのメソッドは、ID属性を照合して単一の要素を返します。
構文
document.getElementById("id of the element")
- 要素のID = アクセスする要素のID属性の値。この値は必ず二重引用符で囲む必要があります。
ステップ1) このデモページを使用してください https://demo.guru99.com/test/facebook.html. その場所に移動し、開発者ツールを使用して「ログイン状態を維持する」チェックボックスを調べます。そのIDをメモしておきます。

使用すべきIDは「persist_box」です。
ステップ2) 店は開いています Selenium IDEと Target ボックスに document.getElementById(“persist_box”) と入力し、[検索] をクリックします。 Selenium IDEは「ログイン状態を維持する」チェックボックスを検出します。チェックボックスの内部をハイライト表示することはできませんが、下図のように、要素を明るい緑色の枠で囲みます。

DOM による検索 – getElementsByName
getElementById メソッドは、指定された ID を持つ要素のみに一度にアクセスできます。一方、getElementsByName メソッドは動作が異なります。指定された名前を持つ要素の配列を返します。個々の要素には、0 から始まる数値インデックスを使用してアクセスします。
 |
getElementByIdを この関数は要素を1つだけ返します。その要素には、getElementById() の括弧内に指定されたIDが付与されています。 |
 |
getElementsByName これは、名前が同じ要素のコレクションを返します。各要素は、配列のように0から始まる番号でインデックス付けされます。特定の要素を選択するには、以下の構文で角括弧内にそのインデックスを指定します。 |
構文
document.getElementsByName("name")[index]
- name = 'name' 属性で定義された要素の名前
- Index = getElementsByName の配列内のどの要素が使用されるかを示す整数。
ステップ1) に移動します Mercury ツアーのホームページにアクセスし、ユーザー名とパスワードに「tutorial」を入力してログインしてください。ブラウザにフライト検索画面が表示されます。
ステップ2) 開発者ツールを使用して、ページ下部にある 3 つのラジオ ボタン (エコノミー クラス、ビジネス クラス、ファースト クラス) を調べてください。それらはすべて「servClass」という同じ名前を共有していることに気づくでしょう。

ステップ3) まず、「エコノミークラス」のラジオボタンにアクセスしてみましょう。3つのラジオボタンのうち、この要素が最初に表示されるため、インデックスは0です。 Selenium IDE で document.getElementsByName(“servClass”)[0] と入力し、[検索] ボタンをクリックします。 Selenium IDEはエコノミークラスのラジオボタンを正しく識別します。

ステップ4) インデックス番号を1に変更すると、 Target document.getElementsByName(“servClass”)[1] になります。検索ボタンをクリックして、 Selenium IDEは、以下に示すように「ビジネスクラス」ラジオボタンをハイライト表示します。

DOM による検索 – dom:name
前述のとおり、この方法は、アクセス対象の要素が名前付きフォーム内に含まれている場合にのみ適用されます。ロケーターパスはフォームから始まり、名前によってターゲット要素まで掘り下げていきます。
構文
document.forms["name of the form"].elements["name of the element"]
- フォーム名 = アクセスしたい要素を含むフォームタグの name 属性の値
- 要素の名前 = アクセスする要素の name 属性の値
ステップ1) MFAデバイスに移動する Mercury ツアーのホームページ https://demo.guru99.com/test/newtours/ 開発者ツールを使用してユーザー名テキストボックスを調べます。それが「home」という名前のフォームに含まれていることに注目してください。

ステップ2) In Selenium IDE で document.forms[“home”].elements[“userName”] と入力し、[検索] ボタンをクリックします。 Selenium IDEは要素に正常にアクセスできます。

DOM による検索 – dom:index
この方法は、要素が名前付きフォーム内にない場合でも適用できます。なぜなら、フォームの名前ではなくインデックスを使用するからです。これは、名前付けができないレガシーページや自動生成フォームで役立ちます。
構文
document.forms[index of the form].elements[index of the element]
- フォームのインデックス = ページ全体に対するフォームのインデックス番号(0から始まる)
- 要素のインデックス = 要素を含むフォームに対する要素のインデックス番号(0から始まる)
「電話」テキストボックスにアクセスします Mercury ツアー登録ページ。このページのフォームには名前もID属性もないので、良い例となります。
ステップ1) に移動します Mercury ツアー登録ページを開き、電話番号入力欄を確認してください。周囲のフォームには、ID属性も名前属性も設定されていないことに気づくでしょう。

ステップ2) document.forms[0].elements[3] を Selenium IDE Target ボックスをクリックし、[検索] ボタンをクリックします。 Selenium IDEは電話テキストボックスに正しくアクセスします。

ステップ3) あるいは、同じ結果を得るために、インデックスの代わりに要素名を使用することもできます。 document.forms[0].elements[“phone”] と入力してください。 Target ボックス。電話番号のテキストボックスは引き続きハイライト表示されます。

XPathによる検索
XPath は XML (Extensible Markup Language) ノードをナビゲートするために使用されるクエリ言語です。HTML は XML の実装とみなすことができるため、 XPath HTML要素も特定できます。これは、 Selenium.
- 利点: クラス、名前、ID属性を持たない要素も含め、ほぼすべての要素にアクセスできます。
- デメリット: 数多くの規則と構文のバリエーションがあるため、これは最も複雑なロケーター戦略である。
最新のブラウザ開発者ツールは、XPath 式を自動的に生成できます。Chrome、Edge、または Firefox要素パネルで要素を右クリックし、[コピー] > [XPath をコピー] を選択します。次の例では、前述の方法では見つけられない画像にアクセスします。
ステップ1) に移動します Mercury ツアーのホームページを開き、開発者ツールを使用して、以下に示すように、黄色の「リンク」ボックスの右側にあるオレンジ色の四角形を調べます。

ステップ2) 要素のHTMLコードを右クリックし、「XPathをコピー」オプションを選択します。

ステップ3) In Selenium IDE、スラッシュ「/」を1つ入力します。 Target ボックスを開き、前の手順でコピーしたXPathを貼り付けます。 エントリ Target ボックスは 2 つのスラッシュ「//」で始まる必要があります。

ステップ4) 「検索」ボタンをクリックします。 Selenium IDEは、以下に示すようにオレンジ色の枠で囲まれた部分をハイライト表示します。

適切なロケーターを選ぶことが重要な理由
適切なロケーター戦略を選択することは、 Selenium 自動化は、スクリプトの安定性、実行速度、および長期的なメンテナンスコストに直接影響するため、非常に重要です。ロケーターの選択を誤ると、テストが不安定になったり、誤ったエラーが発生したり、アプリケーションのUIが変更されるたびに頻繁な手戻りが発生したりする可能性があります。経験豊富な自動化エンジニアが推奨する優先順位は、ID、次に名前、続いてCSSセレクタ、リンクテキスト、最後にXPathです。
IDベースのロケーターは、ブラウザの検索が一意の識別子に最適化されているため、最も高速です。名前ベースのロケーターは、名前が一意であればほぼ同等の効率を発揮します。CSSセレクタとXPathは柔軟性に優れていますが、開発者がDOMをリファクタリングする際には、速度が低下したり、不安定になったりする傾向があります。リンクテキストはナビゲーションリンクに最適ですが、再利用性は限られています。
安定した自動化を実現するには、開発者との連携も不可欠です。テスターがコードレビュー中に一貫性のある意味のあるIDやデータ属性を要求すると、ロケーターの耐久性が大幅に向上します。フレームワークなどで自動生成されるIDはビルドごとに変更される可能性があるため、これらに依存することは避けてください。読みやすく、意図に基づいたロケーターを優先することで、チームはテストスイートの保守性を維持し、アプリケーションの進化に伴う技術的負債を削減できます。
信頼性の高いロケータを作成するためのベストプラクティス
信頼性の高いロケーターは、保守可能なシステムの基盤となる。 Selenium テストスイート。以下のプラクティスは、スクリプトの失敗を減らし、可読性を向上させ、UIの変更に対するテストの耐性を高めるのに役立ちます。
- 一意のIDを推奨します。 まず最初にID属性を確認してください。IDはページ内で一意であることを保証するものであり、最もパフォーマンスの高い選択肢です。
- セマンティックな名前とデータ属性(*)を使用する: 開発者には、data-testidやdata-qaといった安定したテスト属性を追加するよう促しましょう。これらの属性は、CSSクラスが変更されても一貫性を保ちます。
- 絶対XPathを避ける: /html/body/div[2]/div[3]/span のような絶対パスは壊れやすいです。//input[@name='userName'] のような属性を持つ相対 XPath 式を使用してください。
- 精度を高めるために属性を組み合わせる: 単一の属性が一意でない場合は、複数の属性を組み合わせて (たとえば、//button[@type='submit' and @name='login'])、正しい要素をターゲットにします。
- テキストは賢く使いましょう。 表示テキストに依存するロケーターは、言語ローカライズによって正しく動作しない場合があります。テキストベースのロケーターは、コンテンツが安定していて単一言語の場合にのみ使用してください。
- ロケーターを一元化する: ロケーターをページオブジェクトモデル(POM)クラスに格納することで、多数のテストスクリプトにまたがるのではなく、一箇所で更新を行うことができます。
- 開発者ツールで検証する: スクリプトにロケーターを追加する前に、ブラウザのコンソールで、XPath の場合は $x(“//xpath”)、CSS の場合は document.querySelector を使用してテストし、正確に 1 つの要素を返すことを確認してください。
- 可能な限り、インデックスベースのロケーターの使用は避けてください。 [3]のようなインデックス位置は要素の順序に依存します。わずかなレイアウト変更でもインデックスがずれてスクリプトが壊れる可能性があります。
これらの手法を一貫して適用することで、自動化エンジニアは、チーム間で拡張可能で、頻繁なUIアップデートにも最小限のメンテナンスで対応できるテストスイートを作成できます。
