
データ ウェアハウスのディメンション モデリングとは何ですか? 学習タイプ
 デビッドカーター
⚡ スマートサマリー
データウェアハウス設計におけるディメンションモデルは、情報をファクトテーブルとディメンションテーブルに整理することで、アナリストが数値指標を迅速に取得および集計できるようにします。これは、ビジネスプロセス、粒度、ディメンション、ファクト、最終スキーマを特定するキンボールの5段階メソッドに従って行われます。
次元モデリングとは何ですか?
次元モデリング (DM) これは、データウェアハウスにおけるデータストレージに最適化されたデータ構造技術です。その目的は、データベースを調整してデータの高速な取得を実現することです。この概念はラルフ・キンボールによって開発され、「ファクトテーブル」と「ディメンションテーブル」という2種類のテーブルを中心に構築されています。
データウェアハウスにおけるディメンションモデルは、値、残高、件数、重みなどの数値情報を読み取り、集計、分析するように設計されています。一方、リレーショナルモデルは、リアルタイムのオンライン取引処理システムにおいて、データの追加、更新、削除に最適化されています。
これらの手法はそれぞれ独自の方法でデータを保存し、それぞれに明確な利点がある。
関係モデルでは、正規化とERモデルによってデータの冗長性が削減されます。一方、次元モデルは、情報の検索やレポートの作成を容易にするためにデータを整理します。
このため、次元モデルは適しています データウェアハウジング トランザクション重視のリレーショナルシステムではなく、システム。このモデルはより広範な基盤となるため データウェアハウスアーキテクチャ以下のセクションでは、その構成要素、種類、および設計手順について詳しく説明します。
次元データモデルの要素
事実
事実とは、ビジネスプロセスから得られる測定値や指標のことです。例えば、販売プロセスにおいては、四半期ごとの売上高は事実、つまり企業が分析したい数値です。
次元
ディメンションは、ビジネスプロセスイベントを取り巻くコンテキストを提供します。簡単に言うと、ディメンションは事実の「誰が」「何を」「どこで」を提供します。「四半期売上高」という事実の場合、ディメンションは次のようになります。
- 誰 – 顧客名
- どこ – 場所
- 商品名
言い換えれば、次元とは、事実の中に含まれる情報を見るための窓のようなものです。
Attributes
属性とは、次元データモデルにおける次元の様々な特性のことです。
ロケーションディメンションでは、属性は次のようになります。
- 州/地域
- 国
- 郵便番号
属性は事実の検索、フィルタリング、分類に使用され、ディメンションテーブルはそれらの属性が格納される場所です。
ファクトテーブル
ファクトテーブルは、ディメンションモデルにおける主要なテーブルです。
ファクトテーブルには以下が含まれます。
- 測定値または事実
- ディメンションテーブルへの外部キー
寸法表
ディメンションテーブルはファクトのディメンションを保持し、外部キーを介してファクトテーブルと結合します。その主な特徴は以下のとおりです。
- ディメンション テーブルは非正規化されたテーブルです。
- ディメンション属性は、テーブルの列を構成します。
- 次元は、事実の属性を通して、その事実の記述的な特徴を提供する。
- 次元数に固定の制限はありません。
- ディメンションには、1つ以上の階層的な関係を含めることができます。
データ ウェアハウスのディメンションの種類
寸法モデリングでは、それぞれ特定の設計ニーズに適した複数の種類の寸法を使用します。主な データウェアハウスにおけるディメンションの種類 には次の値があります:
- 適合寸法
- アウトリガー寸法
- 縮んだ寸法
- ロールプレイングの次元
- ディメンション対ディメンションテーブル
- ジャンクディメンション
- 次元の縮退
- 交換可能な次元
- ステップ寸法
次元モデリングの手順
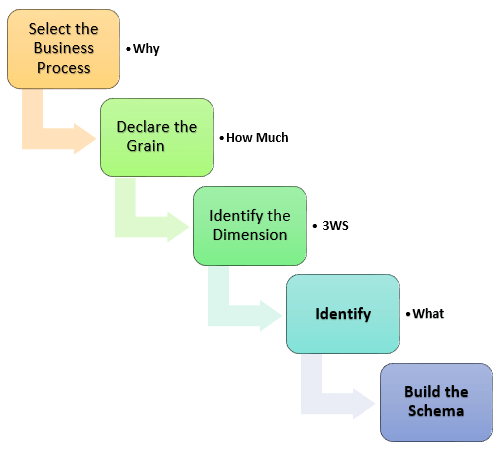
ディメンションモデルの精度は、データウェアハウス実装の成否を左右します。ディメンションモデルを構築するには、次の5つのステップがあります。
- ビジネスプロセスを特定する
- 粒度(詳細度)を特定する
- 寸法を特定する
- 事実を特定する
- スキーマを構築する
全体として、完成したモデルは、ビジネスプロセスの「なぜ」「どれくらい」「いつ」「どこで」「誰が」「何を」を説明するものでなければなりません。
ステップ 1) ビジネス プロセスを特定する
最初のタスクは、組織に基づいて、倉庫がカバーすべきビジネスプロセス(マーケティング、販売、人事など)を特定することです。 データ分析 ニーズと利用可能なデータの質。これは最も重要なステップです。なぜなら、ここでミスを犯すと、連鎖的に修正が困難な不具合が発生するからです。
ビジネスプロセスを記述するには、プレーンテキスト、ビジネスプロセスモデリング表記法(BPMN)、または統一モデリング言語(UML)を使用できます。UML).
ステップ 2) 粒子を特定する
粒度とは、ビジネス上の問題に対する詳細レベルを定義するものであり、あらゆるテーブルに格納される情報の中で最も低いレベルの情報を指します。
テーブルに日ごとの売上データが格納されている場合、そのデータは日単位の粒度を持ち、月ごとの合計データが格納されている場合は、月単位の粒度を持つ。
この段階では、次のような質問に答えていただきます。
- 倉庫には入手可能なすべての製品を保管すべきか、それとも一部の製品タイプのみを保管すべきか?これは、選択された業務プロセスによって異なります。
- 製品の売上データは、月単位、週単位、日単位、時間単位のいずれで保存すべきでしょうか?これは、経営陣が求めるレポートの種類によって異なります。
- これら2つの選択肢は、データベースのサイズにどのような影響を与えますか?
穀物の例: 多国籍企業のCEOが、特定の製品の各地域における売上を日ごとに測定して知りたいと考えていると想像してみてください。
その場合、穀物は「地域別・日別の製品販売情報」となる。
ステップ 3) 寸法を特定する
ディメンションとは、日付、店舗、在庫などの名詞であり、記述的なデータを保持するものです。
例えば、日付ディメンションには、年、月、曜日が含まれる場合があります。
寸法の例: 寸法の選択は、同じ日々の売上要件によって左右される。
このシナリオにおけるディメンションは、製品、場所、および時間です。
製品ディメンションには、製品キー(外部キー)、名前、タイプ、仕様などの属性が含まれます。
場所のディメンションは、国、州、都市、番地、名前という階層構造で構成されています。
ステップ4)事実を特定する
このステップは、システムのビジネスユーザーと密接に関係しています。なぜなら、このステップによって、ユーザーがデータウェアハウスから利用する数値が定義されるからです。
ファクトテーブルのほとんどの行は、価格や単位あたりのコストなどの数値です。
事実の例: 日々の売上目標が、再びその背景を説明する。
ここでいう事実とは、製品別、地域別、時間別の売上高の合計のことである。
ステップ 5) スキーマの構築
この最終ステップでは、ディメンションモデルを実装します。スキーマとは、データベースの構造、つまりテーブルの配置のことで、2つのスキーマを用いるのが一般的です。
最初は、 スタースキーマこれは設計が容易で、その形状から名付けられています。中央にファクトテーブルがあり、そこから星の頂点のように寸法テーブルが放射状に広がっています。
スター型スキーマでは、ファクトテーブルは第3正規形ですが、ディメンションテーブルは非正規化されています。 データウェアハウスモデリングにおけるスタースキーマ このガイドでは、完全な例題を通して解説します。
第二は、 スノーフレークスキーマこれは、各ディメンションが正規化され、さらに別のディメンションテーブルにリンクされるスタースキーマの拡張であり、この中で説明されています。 データウェアハウスモデルにおけるスノーフレークスキーマ ガイド。
次元モデリングのルール
効果的な次元モデリングを行うには、以下の規則と原則に従う必要があります。
- 原子データを次元構造にロードする。
- ビジネスプロセスに基づいた次元モデルを構築します。
- すべてのファクトテーブルに、関連付けられた日付ディメンションテーブルがあることを確認してください。
- すべての事実を、同じ粒度または詳細レベルで単一の事実表にまとめてください。
- レポートラベルとフィルタドメインの値をディメンションテーブルに保存します。
- すべてのディメンションテーブルにサロゲートキーを割り当ててください。
- ビジネス上の意思決定を支援するソリューションを提供するために、要件と現実のバランスを継続的に取る。
次元モデリングの利点
次元モデリングには、以下のような多くの実用的な利点があります。
- 標準化された寸法を用いることで、事業のあらゆる分野において、容易かつ一貫性のある報告が可能となる。
- ディメンション テーブルには、ディメンション情報の履歴が保存されます。
- 事実表に大きな混乱を招くことなく、新たな次元を導入することができます。
- データは、データベースに保存された後、簡単に取り出せるように保存されます。
- 正規化モデルと比較すると、ディメンションテーブルは情報が明確なビジネスカテゴリにグループ化されているため、理解しやすい。
- このモデルはビジネス用語に基づいているため、企業は各事実、次元、属性が何を意味するのかを理解できます。
- このモデルは非正規化されているため、高速なクエリ処理に最適化されており、多くのリレーショナルプラットフォームは実行プランをこのモデルに合わせて最適化している。
- このスキーマは、結合回数を減らし、データ冗長性を最小限に抑えることで、高いパフォーマンスを実現します。
- ディメンションモデルは、既存のビジネスインテリジェンスアプリケーションに影響を与えることなくディメンションテーブルに列を追加できるため、変更への対応が容易です。
データ ウェアハウスの多次元データ モデルとは何ですか?
A 多次元データモデル はデータをデータキューブとして表現し、ディメンションとファクトによって定義された複数のディメンションにわたってデータをモデル化および表示できるようにします。このようなモデルは通常、中心となるテーマを中心に構成され、ファクトテーブルで表現され、 OLAP 解析。
