
MongoDB Expression régulière ($regex) avec exemples
 Stephen Twain
⚡ Résumé intelligent
MongoDB Les expressions régulières effectuent une correspondance de modèles pour trouver des chaînes de caractères dans les documents, en utilisant l'opérateur $regex, l'indicateur $options pour l'insensibilité à la casse, les ancres pour les correspondances exactes et les délimiteurs de barre oblique lorsque la valeur exacte du champ est inconnue.
Les expressions régulières sont utilisées pour la correspondance de modèles, c'est-à-dire pour trouver des chaînes de caractères dans des documents.
Parfois, lors de la récupération de documents dans une collection, vous ne savez peut-être pas exactement quelle est la valeur exacte du champ à rechercher. Par conséquent, on peut utiliser des expressions régulières pour aider à récupérer des données en fonction des valeurs de recherche de correspondance de modèles.
Utilisation de l'opérateur $regex pour la correspondance de modèles
L'opérateur $regex dans MongoDB est utilisé pour rechercher des chaînes spécifiques dans la collection. L'exemple suivant montre comment cela peut être réalisé.
Supposons que nous ayons une collection Employee identique, comportant les champs « Employeeid » et « EmployeeName ». Supposons également que notre collection contienne les documents suivants.
| Identifiant de l'employé | Nom de l'employé |
|---|---|
| 22 | NouveauMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Vieux |
Dans le code ci-dessous, nous avons utilisé l'opérateur $regex pour spécifier les critères de recherche.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Explication:
- Nous souhaitons ici trouver tous les noms d'employés contenant le caractère « Gu ». Pour ce faire, nous utilisons l'opérateur $regex afin de définir le critère de recherche « Gu ».
- Le printjson est utilisé pour mieux imprimer chaque document renvoyé par la requête.
Si la commande est exécutée avec succès, la sortie suivante s'affichera :
Sortie :

Le résultat montre clairement que les documents dans lesquels le nom de l'employé contient les caractères « Gu » sont renvoyés.
Supposons que votre collection contienne les documents suivants, ainsi qu'un document supplémentaire contenant le nom de l'employé sous la forme «Guru999”. Si vous avez saisi les critères de recherche comme «Guru99”, il renverrait également le document qui avait «Guru999". Mais supposons que nous ne voulions pas cela et que nous voulions seulement renvoyer le document avec «Guru99". Nous pouvons alors procéder par correspondance de motif exacte. Pour ce faire, nous utiliserons les caractères ^ et $. Nous ajouterons le caractère ^ au début de la chaîne et le caractère $ à la fin.
| Identifiant de l'employé | Nom de l'employé |
|---|---|
| 22 | NouveauMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Vieux |
| 8 | Guru999 |
L'exemple suivant montre comment cela peut être réalisé.
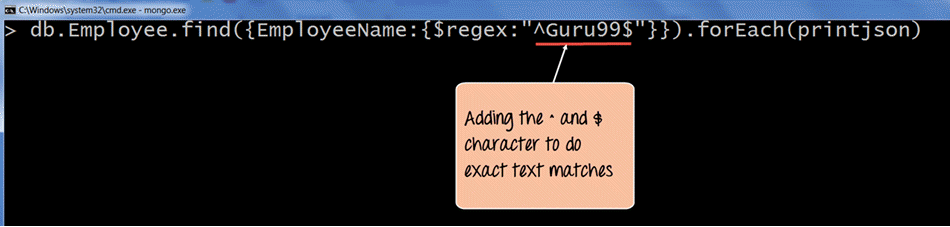
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Explication:
- Dans les critères de recherche, nous utilisons ici les caractères ^ et $. Le ^ permet de s'assurer que la chaîne commence par un certain caractère, et le $ permet de s'assurer qu'elle se termine par un certain caractère. Ainsi, lors de l'exécution du code, seule la chaîne nommée « » sera récupérée.Guru99 ".
- Le printjson est utilisé pour mieux imprimer chaque document renvoyé par la requête.
Si la commande est exécutée avec succès, la sortie suivante s'affichera :
Sortie :
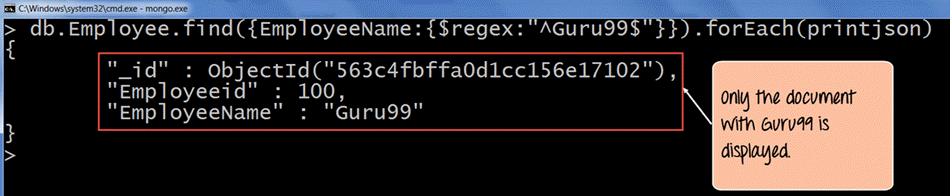
Dans le résultat, il est clairement visible que la chaîne «Guru« 99 » est récupéré.
Correspondance de motifs avec $options
Lorsqu'on utilise l'opérateur $regex, on peut également fournir des options supplémentaires en utilisant $ options mot-clé. Par exemple, supposons que vous souhaitiez rechercher tous les documents contenant « Gu » dans leur nom d'employé, qu'ils soient sensibles ou non à la casse. Si un tel résultat est souhaité, nous devons alors utiliser le $ options avec le paramètre d'insensibilité à la casse.
L'exemple suivant montre comment cela peut être réalisé.
Supposons que nous ayons la même collection Employee qui comporte les noms de champs « Employeeid » et « EmployeeName ».
Supposons également que nous ayons les documents suivants dans notre collection.
| Identifiant de l'employé | Nom de l'employé |
|---|---|
| 22 | NouveauMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Vieux |
| 7 | GOUROU99 |
Si nous exécutons la même requête que dans le sujet précédent, le document contenant « GURU99 » n'apparaîtra jamais dans les résultats. Pour qu'il figure dans le jeu de résultats, il faut ajouter le paramètre « i » à l'option `$options`.
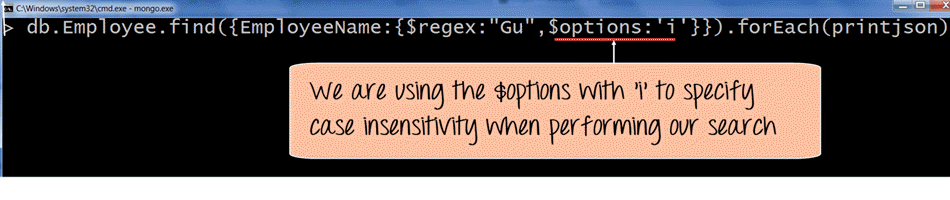
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Explication:
- L'option $options avec le paramètre 'i' (qui signifie insensibilité à la casse) spécifie que nous voulons effectuer la recherche, que nous trouvions les lettres 'Gu' en minuscules ou en majuscules.
Si la commande est exécutée avec succès, la sortie suivante s'affichera :
Sortie :
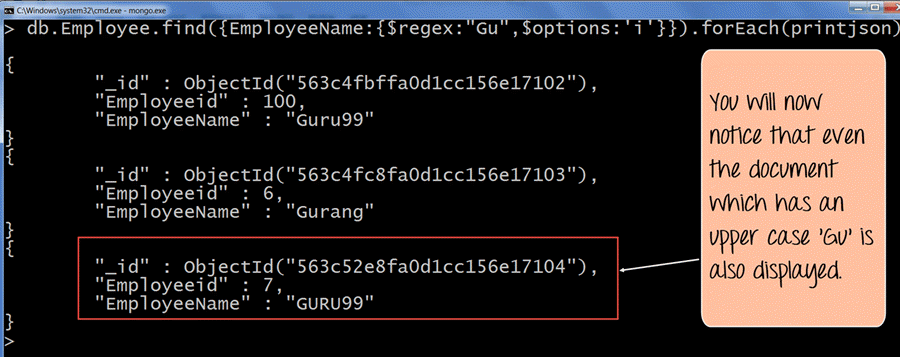
- Les résultats montrent clairement que même si un document contient la lettre « Gu » en majuscules, il apparaît tout de même dans l'ensemble de résultats.
Correspondance de modèles sans l'opérateur regex
Il est également possible d'effectuer une correspondance de motifs sans l'opérateur $regex. L'exemple suivant illustre comment procéder.
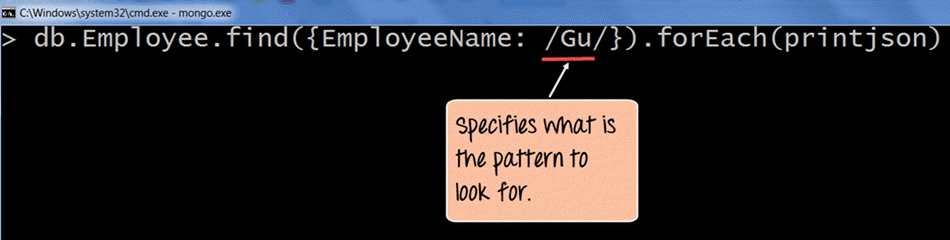
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Explication:
- Les délimiteurs « // » servent à préciser vos critères de recherche. Ainsi, nous spécifions /Gu/ pour retrouver les documents dont le nom d'employé contient « Gu ».
Si la commande est exécutée avec succès, la sortie suivante s'affichera :
Sortie :
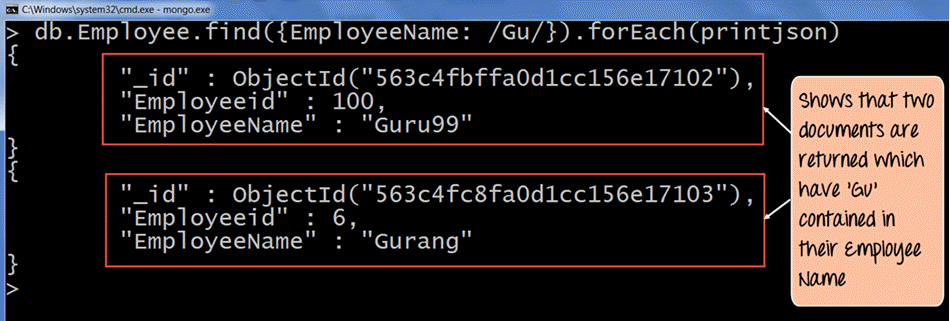
Le résultat montre clairement que les documents dans lesquels le nom de l'employé contient les caractères « Gu » sont renvoyés.
Récupérer les derniers « n » documents d'une collection
Il existe différentes manières d’obtenir les n derniers documents d’une collection.
Examinons l'une des méthodes en suivant les étapes suivantes.
L'exemple suivant montre comment cela peut être réalisé.
Supposons que nous ayons la même collection Employee qui comporte les noms de champs « Employeeid » et « EmployeeName ».
Supposons également que nous ayons les documents suivants dans notre collection :
| Identifiant de l'employé | Nom de l'employé |
|---|---|
| 22 | NouveauMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Vieux |
| 7 | GOUROU99 |
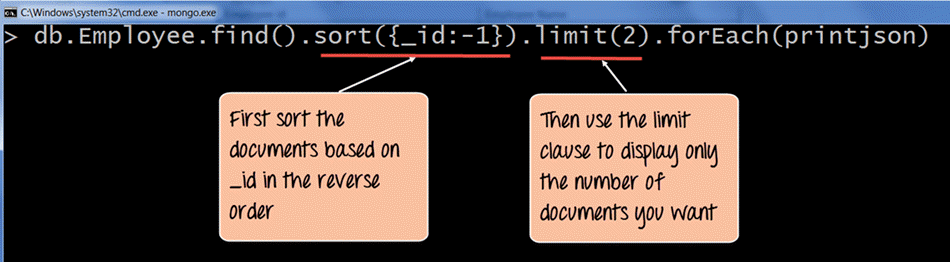
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Explication:
- Lors de la recherche de documents, utilisez la fonction de tri pour trier les enregistrements par ordre décroissant selon la valeur du champ _id dans la collection. L'option -1 indique que les documents doivent être triés par ordre décroissant, le dernier document apparaissant alors en premier.
- Utilisez ensuite la clause LIMIT pour n'afficher que le nombre d'enregistrements souhaités. Ici, nous avons défini la clause LIMIT (2), ce qui permettra de récupérer les deux derniers documents.
Si la commande est exécutée avec succès, la sortie suivante s'affichera :
Sortie :
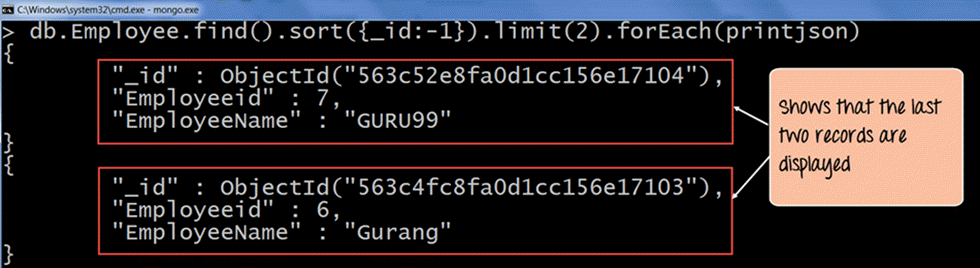
Le résultat montre clairement que les deux derniers documents de la collection sont affichés. Nous avons donc clairement montré que pour récupérer les « n » derniers documents de la collection, nous pouvons d'abord trier les documents par ordre décroissant, puis utiliser la clause limite pour renvoyer le nombre « n » de documents requis.
Note: Si la recherche est effectuée sur une chaîne supérieure à, disons, 38,000 caractères, elle n'affichera pas les bons résultats.
