
SAP HANA Architecture: Descripción general de la base de datos
 Equipo editorial
⚡ Resumen inteligente
SAP HANA ArchiLa arquitectura, el paisaje y el dimensionamiento forman la base de una plataforma de datos en memoria construida sobre SUSE Linux y C++Este artículo explica el servidor de índices, los motores de almacenamiento, los almacenes de filas y columnas, la fusión delta y los métodos de dimensionamiento del hardware.
¿Qué es SAP ¿Base de datos HANA?
SAP HANA es una plataforma de gestión de datos centrada en la memoria principal. La base de datos se ejecuta en SUSE Linux Enterprise Server (SLES) y Red Hat Enterprise Linux (RHEL) y está escrito en C++Puede escalarse horizontalmente a través de múltiples máquinas para cargas de trabajo muy grandes.
Ventajas clave de SAP HANA:
- Rendimiento de consulta extremadamente rápido gracias a que todos los datos se cargan en la memoria, lo que elimina la lenta E/S del disco de la ruta crítica.
- Combinación de OLAP (Procesamiento Analítico en Línea) y OLTP (Procesamiento de Transacciones en Línea) en la misma base de datos, lo que simplifica el panorama de los datos.
SAP La base de datos HANA se compone de un conjunto de motores de procesamiento en memoria. El motor de cálculo es el principal e interactúa con otros motores, como el motor relacional (almacenamiento por filas y columnas), el motor OLAP, el motor de texto y el motor de gráficos. Una tabla relacional reside en el almacenamiento por filas o en el almacenamiento por columnas, y los motores adicionales gestionan los datos de texto y gráficos mientras haya memoria disponible.
SAP HANA Architectura
Los datos en el almacenamiento columnar se comprimen mediante técnicas como la codificación por diccionario, la codificación de longitud variable, la codificación dispersa, la codificación por clúster y la codificación indirecta. Cuando se alcanza el límite de memoria principal, los objetos de la base de datos que no están en uso (tablas, vistas, etc.) se descargan automáticamente al disco y se vuelven a cargar cuando se solicitan de nuevo.
Los administradores también pueden cargar o descargar una tabla individual manualmente haciendo clic con el botón derecho en la tabla. SAP Estudio Hana y eligiendo descargar or Carga.
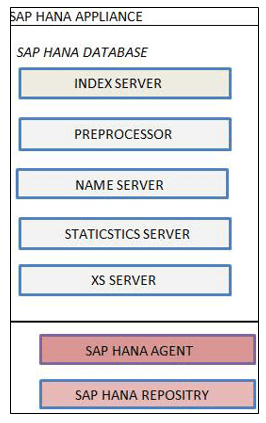
SAP El servidor HANA consta de:
- Servidor de índice
- Servidor de preprocesador
- nombre del servidor
- Servidor de estadísticas
- Motor XS
1. SAP Servidor de índice HANA
El servidor de índices es el principal SAP Componente de base de datos HANA:
- Es el corazón de la SAP Motor de base de datos HANA.
- Contiene los almacenes de datos propiamente dichos y los motores que procesan los datos.
- Ejecuta las sentencias SQL y MDX entrantes.
La arquitectura del servidor de índices se muestra a continuación.

SAP Descripción general del servidor de índice HANA
- Gerente de Sesiones y Transacciones: El componente Session gestiona las conexiones y sesiones de la base de datos. El Transaction Manager coordina y controla todas las transacciones.
- Procesador SQL y MDX: El procesador SQL envía las consultas al motor correspondiente (SQL / SQL Script / R / Calc Engine). El procesador MDX gestiona las consultas multidimensionales (por ejemplo, contra una vista analítica).
- SQL / SQL Script / R / Motor Calc: Ejecuta SQL, scripts SQL, R y modelos de cálculo sobre los datos.
- Repositorio: Mantiene el control de versiones para SAP Objetos de metadatos de HANA, como vistas de atributos, vistas analíticas y procedimientos almacenados.
- Capa de persistencia: Proporciona la capacidad integrada de recuperación ante desastres mediante la escritura de puntos de guardado y registros en el volumen de datos del disco.
2. Servidor de preprocesamiento
El servidor de preprocesamiento es utilizado por el análisis de texto.tracts y prepara datos a partir del contenido textual cuando se invoca la función de búsqueda.
3. Servidor de nombres
El servidor de nombres contiene información sobre todo el entorno del sistema. En una implementación distribuida, tracconoce cada componente en ejecución y la ubicación de los datos en todos los nodos, para que las consultas se puedan enrutar al servidor correcto.
4. Servidor de estadísticas
El servidor de estadísticas recopila datos de estado, asignación de recursos, consumo y rendimiento para el SAP Sistema HANA. Nota: en HANA SPS 7 y versiones posteriores, el servicio de estadísticas integrado se ejecuta dentro del servidor de índices en lugar de como un proceso independiente.
5. Servidor XS
El servidor XS aloja el motor XS, que permite que las aplicaciones y los desarrolladores externos consuman el SAP Base de datos HANA a través de HTTP. El propio motor XS actúa como un servidor HTTP ligero, lo que permite que los clientes basados en navegador y REST se comuniquen directamente con HANA.
SAP Paisaje Hana
“HANA” significa Aparato analítico de alto rendimiento y se ofrece como una plataforma combinada de hardware y software.
- El hardware moderno ofrece muchos más núcleos de CPU, RAM y ancho de banda de almacenamiento de los que los servidores de bases de datos antiguos estaban diseñados para utilizar.
- SAP HANA aprovecha esto mediante keeping Todos los datos de trabajo se almacenan en la memoria principal, eliminando el cuello de botella de E/S del disco que limita las bases de datos tradicionales.
El diagrama a continuación resume la SAP Innovaciones de hardware y software de HANA.

SAP HANA admite dos almacenes de datos relacionales: Tienda de fila y Tienda de columnas.
Tienda de fila
Row Store se comporta como una base de datos tradicional (Oracle, SQL Server). La diferencia clave es que todas las filas residen en la memoria principal en SAP HANA, mientras que una base de datos tradicional los mantiene principalmente en disco.
Tienda de columnas
Column Store almacena los datos en formato columnar en memoria. Aquí se guardan las tablas columnares y el motor equilibra un buen rendimiento de escritura con un rendimiento de lectura optimizado. El siguiente diagrama muestra las dos estructuras que logran este equilibrio.

Almacenamiento principal
El almacenamiento principal contiene la mayor parte de los datos. Se aplican métodos de compresión como la codificación por diccionario, la codificación por clúster, la codificación dispersa y la codificación de longitud variable para ahorrar memoria y acelerar las búsquedas.
- Modificar los datos comprimidos directamente en el almacenamiento principal es costoso, por lo que las escrituras no se realizan en el almacenamiento principal.
- En cambio, cada cambio se escribe en un área separada llamada Delta AlmacenajeLas lecturas pueden acceder tanto al almacenamiento principal como al almacenamiento delta.
Los datos se pueden cargar o descargar manualmente utilizando el Cargar en memoria y Descargar de la memoria Opciones que se muestran a continuación.

Delta Almacenaje
Delta El almacenamiento está optimizado para escrituras y utiliza una compresión más ligera. Todos los cambios no confirmados en una tabla de columnas se guardan aquí. Cuando sea necesario fusionar los cambios de nuevo en el almacenamiento principal, ejecute el Delta ir operación desde SAP Estudio HANA.

- La fusión delta traslada los cambios recopilados en el almacenamiento delta al almacenamiento principal.
- Tras la fusión, el nuevo contenido de almacenamiento principal se guarda en el disco y se recalcula la compresión.
Cómo se mueven los datos desde Delta al almacenamiento principal

Un búfer organizado por filas llamado L1-Delta Se sitúa delante de cada tabla de columnas, razón por la cual una tabla de columnas puede absorber escrituras de alto rendimiento.
- El usuario ejecuta una operación de ACTUALIZACIÓN o INSERCIÓN en la tabla.
- Los datos llegan primero a L1-Delta (datos no confirmados).
- Una vez confirmados, los datos se mueven a la capa L2 orientada a columnas.Delta tampón.
- Cuando L2-Delta Si el almacenamiento está lleno o se ejecuta la fusión, los datos se escriben en el almacenamiento principal.
Por lo tanto, el almacenamiento columnar está optimizado tanto para escritura (mediante las capas L1 y L2 delta) como para lectura (mediante el almacenamiento principal). Tras el procesamiento, la capa de persistencia guarda los datos en el disco.
Ejemplo de una tabla basada en filas:

La misma tabla lógica se almacena en disco de forma diferente según el tipo de almacenamiento. En el almacenamiento por filas, las filas se escriben de forma contigua:

En Column Store, los valores de la misma columna se almacenan juntos:

Debido a que los valores de las columnas comparten el mismo tipo de datos y a menudo se repiten, la disposición de las columnas se comprime extremadamente bien, lo cual es la principal ventaja de memoria del almacenamiento en columnas.

SAP Talla HANA
El dimensionamiento es el proceso de determinar los recursos de hardware (RAM, disco y CPU) necesarios para un SAP Sistema HANA. La memoria es el factor más importante, la CPU ocupa el segundo lugar y el disco se deriva de los dos primeros.
En un SAP En la implementación de HANA, seleccionar el tamaño de servidor adecuado para la carga de trabajo empresarial es una de las tareas más críticas. En comparación con un DBMS tradicional, el dimensionamiento de HANA difiere en tres áreas:
- Memoria principal: impulsado por los metadatos más el volumen de datos transaccionales y analíticos almacenados en la memoria.
- UPC: Estimado en lugar de medido, basado en patrones de consulta y carga previstos.
- Disco: Diseñado para la persistencia de datos y volúmenes de registro, no para datos de consultas en línea.
La CPU y la memoria del servidor de aplicaciones permanecen sin cambios en comparación con la base de datos anterior, ya que HANA solo reemplaza la capa de la base de datos.
SAP Proporciona varios métodos para calcular el tamaño correcto:
- Dimensionamiento mediante un informe ABAP (código de transacción) ST03 datos e informe /SDF/HDB_SIZING).
- Dimensionamiento mediante un script de base de datos para sistemas que no son ABAP.
- Dimensionamiento mediante el SAP Dimensionador rápido herramienta en el SAP Mercado de servicios.
Cuando se utiliza la herramienta Quick Sizer, el requisito se muestra en el formato que se indica a continuación.

