
SAP DS (servicios de datos) en HANA
 Equipo editorial
⚡ Resumen inteligente
SAP Data Services es la plataforma ETL empresarial que mueve y limpia datos de fuentes heterogéneas a SAP HANA. Designer, Job Server, Engine, Repository y Access Server trabajan juntos para crear, programar y ejecutar flujos de datos.
¿Qué es SAP ¿Servicios de datos?
SAP Data Services es una herramienta ETL que proporciona una solución única a nivel empresarial para la integración, transformación, calidad y perfilado de datos, así como para el procesamiento de datos de texto desde una fuente heterogénea a una base de datos o almacén de datos de destino.
Las aplicaciones, llamadas trabajos, se crean en el Diseñador, donde se asignan los datos.ping y la transformación se definen. El producto también se denomina SAP BusinessObjects Data Services, abreviado como SAP BODS, y ambos nombres describen la misma herramienta. SAP La versión actual de Data Services es la 4.3; la versión 4.2 finalizó su mantenimiento principal el 31 de mayo de 2023, por lo que las nuevas implementaciones deberían comenzar con la versión 4.3.
Dentro de un SAP Paisaje HANA, SAP Data Services es la opción elegida cuando los datos necesitan ser remodelados al ingresar en lugar de copiados tal como están. Las secciones siguientes cubren lo que ofrece la herramienta, cómo encajan sus partes y una carga de trabajo completa desde un SAP Tabla ECC en SAP HANA.
Caracteristicas de SAP Servicios de datos
Las capacidades que se describen a continuación explican por qué. SAP Data Services se posiciona como una plataforma de nivel empresarial, en lugar de una simple utilidad de copia.
- Proporciona transformaciones paralelas de alto rendimiento.
- Dispone de herramientas administrativas completas y una herramienta de generación de informes.
- Es compatible con múltiples usuarios.
- SAP CUERPOS Es muy flexible con las aplicaciones basadas en servicios web.
- Permite un lenguaje de scripting con un amplio conjunto de funciones.
- SAP Los servicios de datos pueden integrarse con SAP Servidor de replicación LT (SLT) utilizando tecnología basada en disparadores. SLT agrega capacidades delta a cada SAP o noSAP tabla de origen, que permite la captura de datos modificados y la transferencia de datos delta desde la tabla de origen.
- Validación de datos con cuadros de mando y auditoría de procesos.
- Una herramienta de administración con funciones de programación y paneles de control para la monitorización.
- Depuración, creación de perfiles integrada y visualización de datos.
- SAP El servicio de datos admite una amplia gama de fuentes y destinos:
- Cualquier aplicación, por ejemplo SAP.
- Cualquier base de datos, con carga masiva y captura de cambios de datos.
- Archivos: ancho fijo, delimitado por comas, COBOL, XML y Excel.
Estas funcionalidades se proporcionan mediante un pequeño conjunto de componentes instalables, cada uno con una función específica.
Componentes de SAP Servicios de datos
SAP El servicio de datos consta de los siguientes componentes.
- Diseño – Es una herramienta de desarrollo que nos permite crear, probar y ejecutar un trabajo que llena un almacén de datos. Permite al desarrollador crear objetos y configurarlos seleccionando un icono en un diagrama de flujo de origen a destino. Se puede utilizar para crear una aplicación especificando flujos de trabajo y flujos de datos. Para abrir Data Services Designer, vaya a Menú Inicio -> Todos los programas -> SAP Servicios de datos -> Diseñador de servicios de datos.

- Servidor de trabajos – Se trata de una aplicación que inicia el motor de procesamiento de Data Services y sirve como interfaz para dicho motor y para el conjunto de herramientas de Data Services.
- Motor – El motor de servicios de datos ejecuta las tareas individuales que se definen en la aplicación.
- Repositorio – El repositorio es una base de datos que almacena objetos predefinidos de Designer y objetos definidos por el usuario (metadatos de origen y destino, reglas de transformación). Existen dos tipos de repositorios:
- Repositorio local (utilizado por Designer y Job Server).
- Repositorio central (utilizado para compartir objetos y control de versiones).
- Acceder al servidor – El servidor de acceso transmite mensajes entre las aplicaciones web, el servidor de trabajos de servicios de datos y los motores.
- Administradora – El administrador web proporciona administración basada en navegador de los recursos de Servicios de datos, tal como se detalla a continuación:
- Configuración, inicio y paradaping Servicios en tiempo real.
- Programación, supervisión y ejecución de trabajos por lotes.
- Configuración del servidor de trabajos, el servidor de acceso y el uso del repositorio.
- Gestión de usuarios.
- Publicación de trabajos por lotes y servicios en tiempo real a través de servicios web.
- Configuración y gestión de adaptadores.
Saber qué hace cada componente es solo una parte de la historia. La arquitectura que se muestra a continuación ilustra cómo se comunican durante una carga.
SAP Servicios de datos Architectura
La arquitectura de servicios de datos tiene los siguientes componentes:
- Repositorio central: se utiliza para la configuración de repositorios en servidores de trabajos, gestión de seguridad, control de versiones y compartición de objetos.
- Diseñador: se utiliza para crear un proyecto, un trabajo, un flujo de trabajo y un flujo de datos, y para ejecutarlos.
- Repositorio local: aquí puede crear, modificar e iniciar trabajos, flujos de trabajo y flujos de datos.
- Servidor y motor de trabajos: gestiona los trabajos.
- Servidor de acceso: se utiliza para ejecutar las tareas en tiempo real creadas por los desarrolladores en los repositorios.
En la imagen que aparece a continuación, se muestran los Servicios de Datos y las relaciones entre sus componentes.

SAP CUERPOS Architectura
Detalle de ventana de diseño
El Diseñador es el componente en el que un desarrollador pasa la mayor parte del tiempo, por lo que conviene familiarizarse primero con su estructura. A continuación se detallan las características de cada sección del Diseñador de Servicios de Datos:
- Barra de herramientas (utilizado para Abrir, Guardar, Retroceder, Validar, Ejecutar, etc.).
- Área del proyecto (Contiene el proyecto actual, que incluye el trabajo, el flujo de trabajo y el flujo de datos. En Data Services, todas las entidades son objetos).
- Espacio de trabajo (el área de la ventana de la aplicación en la que definimos, mostramos y modificamos objetos).
- Biblioteca de objetos locales (contiene objetos del repositorio local, como transformaciones, trabajos, flujos de trabajo, flujos de datos, etc.).
- Paleta de herramientas (Los botones de la paleta de herramientas permiten añadir nuevos objetos al espacio de trabajo).

Jerarquía de objetos
El siguiente diagrama muestra las relaciones jerárquicas de los principales tipos de objetos dentro de los Servicios de Datos.

Nota: La leyenda que aparece a continuación identifica los elementos opcionales de la jerarquía.

Los flujos de trabajo y las condiciones son opcionales.
Los objetos utilizados en SAP Los servicios de datos se detallan a continuación.
| Objetos | Mareas Ideales para Lecciones |
|---|---|
| Proyectos | Un proyecto es el objeto de nivel superior en la ventana del Diseñador. Los proyectos permiten organizar los demás objetos que se crean en Data Services. Solo un proyecto puede estar abierto a la vez, donde "abierto" significa "visible en el área de proyectos". |
| Trabajos | Una “tarea” es la unidad de trabajo más pequeña que se puede programar de forma independiente para su ejecución. |
| Scripts | Un subconjunto de líneas en un procedimiento. |
| Flujo de trabajo | Un “flujo de trabajo” es la incorporación de varios flujos de datos en un flujo de trabajo coherente para una tarea completa. Un flujo de trabajo es opcional. Un flujo de trabajo es un procedimiento que puede:
|
| Flujo de datos | Un “flujo de datos” es el proceso mediante el cual los datos de origen se transforman en datos de destino. Un flujo de datos es un objeto reutilizable. Siempre se invoca desde un flujo de trabajo o una tarea. Se utiliza para:
|
| Almacenamiento de Datos | Un canal lógico que conecta los servicios de datos con las bases de datos de origen y destino. Almacenes de datos:
|
| Target | La tabla o archivo en el que Data Services carga los datos desde la fuente. |
SAP Servicios de datos frente a SLT frente a DXC
SAP Data Services es uno de varios aprovisionamiento de datos opciones para SAP HANA, y elegir el incorrecto genera costos que ninguna optimización puede recuperar. La siguiente tabla compara los tres métodos del lado del servidor.
| Criterios | SAP Servicios de datos | SLT | DXC |
|---|---|---|---|
| Estado latente | Por lotes o programado | Tiempo real | Lote, programado por DataSource |
| ETL completo, limpieza y perfilado. | Reglas simples de filtro y campo | Ninguno más allá de extraclógica de Tor | |
| Alcance de la fuente | SAP y noSAParchivos, aplicaciones | SAP y noSAP bases de datos | SAP Solo para Business Suite |
| Se requiere un servidor adicional | Sí, servidor de trabajos | Por lo general si | No |
| Mejores adecuados para | Calidad de los datos y consolidación de múltiples fuentes | Operainformes nacionales sobre datos en tiempo real | Reutilización de contenido empresarial existente, por ejemplotractoros |
En resumen, elige SAP Servicios de datos cuando los datos deben limpiarse, unirse o estandarizarse antes de su llegada. Elija SLT cuando el informe deba reflejar la transacción tal como ocurre, y DXC cuando un experto en contenido empresarial probadotracTor ya produce la semántica que necesitas. Para un conjunto de datos único sin programación repetitiva, un carga de archivo plano es más rápido que configurar cualquiera de los tres.
Cómo cargar datos desde un SAP Tabla de origen que utiliza SAP Servicios de datos
En Data Services, todo es un objeto. Se necesita un almacén de datos independiente para cada base de datos de origen y destino.
La secuencia completa para cargar datos desde un SAP La tabla de origen se muestra a continuación. Cada paso se detalla posteriormente.
- Cree un almacén de datos entre el origen y BODS.
- Importar los metadatos (estructuras) en BODS.
- Configurar el servidor de importación
- Importar los metadatos al sistema HANA.
- Cree un almacén de datos entre BODS y HANA.
- Crear un proyecto
- Crear un trabajo (por lotes o en tiempo real)
- Crear un flujo de trabajo
- Crea un flujo de datos
- Agregar objetos al flujo de datos
- ejecutar el trabajo
- Compruebe la vista previa de los datos en HANA.
Paso 1) Cree un almacén de datos entre el SAP fuente y BODS.
- Para cargar datos desde un SAP fuente en SAP HANA a través de SAP BODS requiere un almacén de datos. Por lo tanto, primero creamos un almacén de datos, como se muestra a continuación: Proyecto -> Nuevo -> Almacén de datos

- Aparecerá una ventana emergente para crear un nuevo almacén de datos. Introduzca los detalles como se indica a continuación:
- Introduzca el nombre del almacén de datos “ds_ecc”.
- Seleccione el nombre del tipo de almacén de datos como “SAP Aplicaciones”.
- Introduzca el nombre del servidor de la base de datos.
- Introduzca el nombre de usuario y la contraseña.
- Haga clic en el botón "Aplicar".
- Haga clic en el botón "Aceptar".

- Se creará el almacén de datos. Vea el almacén de datos creado como se muestra a continuación.
- Ve a la Biblioteca de objetos local.
- Seleccione la pestaña Almacén de datos.
- Se mostrará el almacén de datos “ds_ecc”.

Paso 2) Importar metadatos (estructura) al servidor BODS.
Hemos creado un almacén de datos para ECC a BODS; ahora importaremos los metadatos de ECC a BODS. Para importar, siga los pasos que se indican a continuación.
- Seleccione el almacén de datos “ds_ecc” y haga clic con el botón derecho.
- Seleccione la opción Importar por nombre.

Aparecerá una ventana emergente para importar por nombre. Introduzca los detalles como se indica a continuación:
- Seleccione Tipo como tabla.
- Introduzca el nombre de la tabla que desea importar. En este caso, importaremos la tabla KNA1.
- Haz clic en el botón “Importar”. La tabla KNA1 aparecerá en el nodo Tabla de la fuente de datos “ds_ecc”.

Los metadatos de la tabla se importarán al almacén de datos ds_ecc como se indica a continuación.

Paso 3) Configure el servidor de importación.
Hasta ahora hemos importado una tabla al almacén de datos “ds_ecc” creado para el ECC. SAP Conexión BODS. Para importar datos a SAP HANANecesitamos configurar el servidor de importación.
- Para hacer esto, ve a Vista rápida -> Configurar servidor de importación como se muestra a continuación.

- Aparecerá una ventana emergente para Seleccionar sistema. Seleccione el SAP Sistema HANA (HDB aquí) como se muestra a continuación.

- Haz clic en el botón “Siguiente”. Aparecerá otra ventana emergente para las credenciales de Servicios de datos. Introduce los siguientes datos:
- SAP Dirección del servidor BODS (en este caso, BODS:6400).
- SAP Nombre del repositorio BODS (nombre del repositorio HANAUSER).
- Fuente de datos ODBC (ZTDS_DS).
- Puerto predeterminado para el SAP Servidor BODS (8080).

Haz clic en el botón “Finalizar”.
Paso 4) Importar los metadatos al sistema HANA.
El servidor de importación ya está configurado, por lo que se pueden importar metadatos desde el SAP Servidor BODS.
- Haz clic en la opción Importar en Vista rápida.
- Aparecerá una ventana emergente con las opciones de importación. Seleccione la opción "Importación selectiva de metadatos".

Haga clic en el botón "Siguiente".
Aparecerá una ventana emergente de “Importación selectiva de metadatos”, en la que seleccionaremos el sistema de destino.
- Seleccione el elemento SAP Sistema HANA (HDB aquí).

Haga clic en el botón "Siguiente".
Paso 5) Cree un almacén de datos entre BODS y HANA.
En BODS se requiere un almacén de datos independiente para el origen y el destino. El almacén de datos de origen ya existe, por lo que a continuación se crea un almacén de datos de destino entre BODS y HANA con el nombre "DS_BODS_HANA".
- Vaya a Proyecto -> Nuevo -> Almacén de datos.
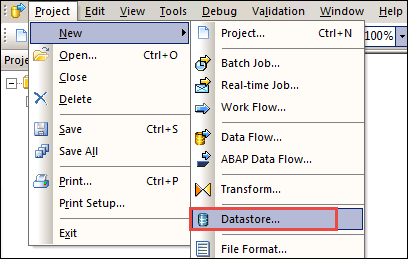
- Aparecerá una pantalla para crear un nuevo almacén de datos, como se muestra a continuación.
- Introduzca el nombre del almacén de datos (DS_BODS_HANA).
- Introduzca el tipo de almacén de datos como Base de datos.
- Introduzca el tipo de base de datos como SAP HANA.
- Seleccione la versión de la base de datos.
- Escriba el SAP Nombre del servidor de la base de datos HANA.
- Introduzca el nombre del puerto para el SAP Base de datos HANA.
- Introduzca el nombre de usuario y la contraseña.
- Marque la casilla “Habilitar la transferencia automática de datos”.

Haz clic en “Aplicar” y luego en el botón “Aceptar”.
El almacén de datos “DS_BODS_HANA” se mostrará en la pestaña Almacén de datos de la Biblioteca de objetos local, como se muestra a continuación.

- Ahora importamos una tabla al almacén de datos “DS_BODS_HANA”.
- Seleccione el almacén de datos “DS_BODS_HANA” y haga clic con el botón derecho.
- Seleccione Importar por nombre.

- Aparecerá una ventana emergente para importar por nombre, como se muestra a continuación.
- Seleccione Tipo como tabla.
- Introduzca el nombre como KNA1.
- El propietario se mostrará como Hanauser.
- Haz clic en el botón Importar.

La tabla se importará al almacén de datos “DS_BODS_HANA”. Para ver los datos de la tabla, siga los pasos que se indican a continuación.
- Haga clic en la tabla “KNA1” en el almacén de datos “DS_BODS_HANA”.
- Los datos se mostrarán en formato tabular.

Paso 6) Definir el proyecto. Un proyecto agrupa y organiza objetos relacionados. Un proyecto puede contener cualquier número de trabajos, flujos de trabajo y flujos de datos.
- Ve al menú Proyecto de diseño.
- Seleccione la opción Nuevo.
- Seleccione la opción Proyecto.

Aparecerá una ventana emergente para crear un nuevo proyecto, como se muestra a continuación. Introduzca el nombre del proyecto y haga clic en el botón Crear. Se creará una carpeta para el proyecto, en nuestro caso BODS_DHK.

Paso 7) Defina el trabajo. Un trabajo es un objeto reutilizable. Contiene flujos de trabajo y flujos de datos. Los trabajos se pueden ejecutar manualmente o de forma programada. Para ejecutar un proceso BODS, es necesario definir un trabajo.
Creamos un trabajo llamado JOB_Customer.
- Seleccione el proyecto (BODS_DHK) creado en el paso anterior, haga clic con el botón derecho y seleccione "Nuevo trabajo por lotes".
- Cambie el nombre a "JOB_Customer".

Paso 8) Definir el flujo de trabajo.
- Seleccione el trabajo “JOB_Customer” en el área del proyecto.
- Haz clic en el botón de flujo de trabajo en la paleta de herramientas. Haz clic en el área de trabajo en blanco. Aparecerá un icono de flujo de trabajo en el espacio de trabajo.
- Cambie el nombre del flujo de trabajo a “WF_Customer”.

Haga clic en el nombre del flujo de trabajo y aparecerá una vista vacía del flujo de trabajo en el espacio de trabajo.

Paso 9) Defina el flujo de datos.
- Haga clic en el flujo de trabajo “WF_Customer”.
- Haz clic en el botón de flujo de datos en la paleta de herramientas. Haz clic en el área de trabajo en blanco. Aparecerá un icono de flujo de datos en el espacio de trabajo.
- Cambie el nombre del flujo de datos a “DF_Customer”.
- El flujo de datos también aparece en el área del proyecto, a la izquierda, debajo del nombre del trabajo.

Paso 10) Agregar objetos al flujo de datos.
Dentro del flujo de datos, proporcionamos instrucciones para transformar los datos de origen al formato deseado para la tabla de destino.
Se utilizan tres objetos:
- Un objeto para la fuente.
- Un objeto para la tabla de destino.
- Un objeto para la transformación de consulta, que asigna las columnas de origen a destino.
Haz clic en el flujo de datos DF_Customer. Aparecerá un espacio de trabajo en blanco como se muestra a continuación.
- Especifique el objeto para la fuente – Vaya al almacén de datos “ds_ecc”, seleccione la tabla KNA1 y arrástrela y suéltela en la pantalla de flujo de datos en blanco.
- Especifique el objeto para el destino. – Seleccione el almacén de datos “DS_BODS_HANA” del repositorio y seleccione la tabla KNA1.
- Arrástralo y suéltalo en el espacio de trabajo y selecciona “Hacer TargetOpción ”. Ahora habrá dos tablas, una de origen y otra de destino.

- Transformación de consultas – Esta es una herramienta que se utiliza para recuperar datos basándose en el esquema de entrada para una condición específica del usuario, y para transportar datos desde el origen al destino.
- Seleccione el icono de Transformación de consulta en la paleta de herramientas y arrástrelo y suéltelo entre los objetos de origen y destino en el espacio de trabajo.
- Vincula el objeto Query con el origen.
- Vincula el objeto Query a la tabla de destino.

Double-Haga clic en el icono de Consulta para asignar columnas del esquema de entrada al esquema de salida. Un mapaping Aparece una ventana en la que hacemos lo siguiente:
- Se ha seleccionado la tabla de origen KNA1.
- Seleccione todas las columnas de la tabla de origen, haga clic con el botón derecho y seleccione Asignar a salida.
- Se selecciona la opción de salida "Consulta" y se asignarán las columnas.

Guarda y valida el proyecto. Haz clic en el icono Validar. Aparecerá una ventana emergente que confirma que la validación se ha realizado correctamente.

Paso 11) Ejecutar el trabajo. Para ejecutar la tarea, siga la ruta que se indica a continuación.
- Seleccione el icono del área de proyecto para abrir el proyecto y seleccione el proyecto creado.
- Seleccione el trabajo y haga clic con el botón derecho.
- Seleccione la opción Ejecutar para ejecutar la tarea.
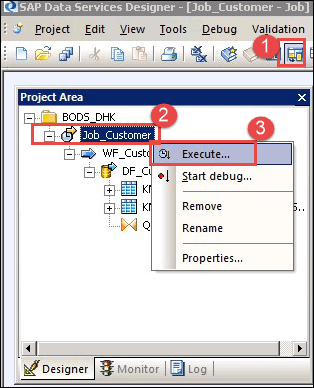
Después de ejecutar el trabajo, se muestra una ventana de registro de trabajo, en la que aparecen todos los mensajes relacionados con el trabajo. El último mensaje será “Trabajo se ha completado con éxito”.

Paso 12) Validar y comprobar los datos en el SAP Base de datos HANA.
- Inicie sesión en el SAP base de datos HANA a través de SAP Estudio Hanay seleccione el esquema HANAUSER.
- Seleccione la tabla KNA1 en el nodo Tabla.
- Haga clic con el botón derecho en la tabla KNA1 y seleccione Vista previa de datos.
- Los datos KNA1 cargados por el proceso BODS se mostrarán en la pantalla de vista previa de datos.

Si el número de filas coincide entre la tabla de origen y esta vista previa, se confirma que la carga se ha completado correctamente y, a continuación, se puede programar la tarea desde el Administrador para que se ejecute repetidamente.
