
Funciones en programación R con ejemplo
 evelyn clarke
⚡ Resumen inteligente
Las funciones en R agrupan un conjunto de instrucciones bajo un mismo nombre, de modo que una tarea repetida se ejecuta con una sola llamada. Ayudantes integrados para matemáticas y estadística, funciones definidas por el usuario, entorno de ejecuciónpingy los argumentos condicionales se tratan aquí con ejemplos resueltos.
¿Qué es una función en R?
A función, en un entorno de programación, es un conjunto de instrucciones. Un programador construye una función para evitar repitiendo la misma tarea, o reducir complejidad.
Una función debe ser
- escrito para llevar a cabo una tarea específica
- puede o no incluir argumentos
- contener un cuerpo
- puede devolver uno o más valores o no.
Un enfoque general para una función es utilizar la parte del argumento como entradas, alimentar el cuerpo parte y finalmente devolver un salidaLa sintaxis de una función es la siguiente:
function (arglist)  {
  #Function body
}
R funciones integradas importantes
Hay muchas funciones integradas en R. R hace coincidir sus parámetros de entrada con los argumentos de su función, ya sea por valor o por posición, y luego ejecuta el cuerpo de la función. Los argumentos de la función pueden tener valores predeterminados: si no especifica estos argumentos, R tomará el valor predeterminado.
Nota: :
Es posible ver el código fuente de una función ejecutando el nombre de la función en la consola.
Typing Un nombre de función sin corchetes imprime su código fuente, como muestra la consola a continuación.

Veremos tres grupos de funciones en acción.
- Función general
- función matemática
- Función estadística
Funciones generales
Ya estamos familiarizados con funciones generales como cbind(), rbind(), range(), ordenar()y order(). Cada una de estas funciones tiene una tarea específica, toma argumentos para devolver una salida. A continuación se presentan funciones importantes que uno debe conocer:
función diferencia()
Si trabajas en series de tiempo, necesitas estacionar la serie tomando sus valores de retraso. En proceso estacionario Permite mantener constantes la media, la varianza y la autocorrelación a lo largo del tiempo. Esto mejora principalmente la predicción de una serie temporal. Esto se puede lograr con la función diff(). Podemos construir una serie temporal aleatoria con una tendencia y luego usar la función diff() para estandarizarla. La función diff() acepta un argumento, un vector, y devuelve la diferencia iterada y con retardo adecuada.
Nota: A menudo necesitamos generar datos aleatorios, pero para el aprendizaje y la comparación, queremos que los números sean idénticos en todas las máquinas. Para garantizar que todas generemos los mismos datos, utilizamos la función `set.seed()` con valores arbitrarios de 123. `set.seed()` fija el punto de partida del generador de números pseudoaleatorios, de modo que cada máquina produce la misma secuencia. Sin `set.seed()`, cada ejecución devuelve una secuencia diferente.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
Los dos paneles que aparecen a continuación muestran la serie acumulativa original junto a la serie diferenciada, que ahora fluctúa alrededor de una media constante.

función longitud()
En muchos casos, necesitamos conocer la longitud de un vector para realizar cálculos o para usarlo en un bucle for. La función length() cuenta el número de filas del vector x. El siguiente código importa el conjunto de datos cars y devuelve el número de filas.
Nota: : length() devuelve el número de elementos en un vector. Si la función se pasa a un matriz o un marco de datos, se devuelve el número de columnas.
dt <- cars
## number columns
length(dt)
Salida:
## [1] 1
## number rows
length(dt[,1])
Salida:
## [1] 50
Funciones matemáticas
Además de las funciones auxiliares generales, R dispone de una serie de funciones matemáticas que operan elemento por elemento sobre un vector.
| Operator | Mareas Ideales para Lecciones |
|---|---|
| abs (x) | Toma el valor absoluto de x |
| registro (x, base = y) | Toma el logaritmo de x con base y; si no se especifica la base, devuelve el logaritmo natural |
| exp (x) | Devuelve la exponencial de x |
| sqrt (x) | Devuelve la raíz cuadrada de x |
| factoriales(x) | Devuelve el factorial de x (x!) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
Salida:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
Salida:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
Salida:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
Funciones estadisticas
Mientras que las funciones matemáticas transforman valores, las funciones estadísticas los resumen. La instalación estándar de R incluye una amplia gama de funciones estadísticas. En este tutorial, analizaremos brevemente las más importantes.
Funciones estadísticas básicas
| Operator | Mareas Ideales para Lecciones |
|---|---|
| media(x) | Media de x |
| mediana(x) | Mediana de x |
| var(x) | Varianza de x |
| SD(x) | Desviación estándar de x |
| escala(x) | Puntuaciones estándar (puntuaciones z) de x |
| cuantil(x) | Los cuartiles de x |
| resumen(x) | Resumen de x: media, mínimo, máximo, etc. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
Salida:
## [1] 15.4
# Median speed of cars dataset
median(speed)
Salida:
## [1] 15
# Variance speed of cars dataset
var(speed)
Salida:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
Salida:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
Salida:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
Salida:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
Salida:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
Hasta este punto, hemos aprendido muchas funciones integradas de R.
Nota: : Tenga cuidado con el clase del argumento, es decir, numérico, booleano o cadena. Por ejemplo, si necesitamos pasar un valor de cadena, debemos encerrar la cadena entre comillas: “ABC”.
Escribir función en R
En algunas ocasiones, necesitamos escribir nuestra propia función porque tenemos que realizar una tarea particular y no existe una función predefinida. Una función definida por el usuario implica una nombre , argumentos y cuerpo.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
Nota: : Una buena práctica es nombrar una función definida por el usuario diferente de una función integrada. Evita confusiones.
Función de un argumento
En el siguiente fragmento, definimos una función cuadrada simple. La función acepta un valor y devuelve el cuadrado del valor.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code Explicación
- La función se llama función_cuadrada; se puede llamar como queramos.
- Recibe un argumento "n". Nosotros no especificó el tipo de variable para que el usuario pueda pasar un número entero, un vector o una matriz
- La función toma la entrada "n" y devuelve el cuadrado de la entrada. Cuando haya terminado de usar la función, podemos eliminarla con la función rm().
# después de crear la función
rm(square_function)
square_function
En la consola, podemos ver un mensaje de error: Error: objeto 'square_function' no encontrado que indica que la función no existe.
Medio Ambiente Scoping
En R, el entorno empresarial es una colección de objetos como funciones, variables, marcos de datos, etc.
R abre un entorno cada vez que se inicia RStudio.
El entorno de nivel superior disponible es el ambiente global, llamado R_GlobalEnv. Y tenemos el ambiente local.
Podemos enumerar el contenido del entorno actual.
ls(environment())
Resultado
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
Puede ver todas las variables y funciones creadas en R_GlobalEnv.
La lista anterior variará en función del código histórico que ejecute en RStudio.
Tenga en cuenta que n, el argumento de la función square_function no está en este entorno global.
Se crea un nuevo entorno para cada función. En el ejemplo anterior, la función square_function() crea un nuevo entorno dentro de ambiente global.
Para aclarar la diferencia entre global y local Entorno, estudiemos el siguiente ejemplo.
Esta función toma un valor x como argumento y lo agrega a y define fuera y dentro de la función

La función f devuelve la salida 15. Esto se debe a que y está definido en el entorno global. Cualquier variable definida en el entorno global se puede utilizar localmente. La variable y tiene el valor de 10 durante todas las llamadas a funciones y es accesible en cualquier momento.
Veamos qué sucede si la variable y se define dentro de la función.
Necesitamos eliminar `y` antes de ejecutar este código usando rm r
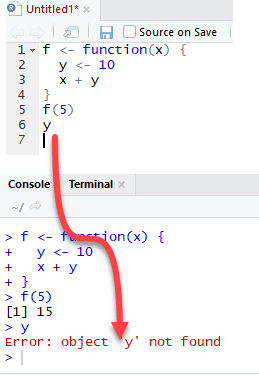
La salida también es 15 cuando llamamos a f(5) pero devuelve un error cuando intentamos imprimir el valor y. La variable y no está en el entorno global.
Por último, R utiliza la definición de variable más reciente para pasarla dentro del cuerpo de una función. Consideremos el siguiente ejemplo:

R ignora los valores de y definidos fuera de la función porque creamos explícitamente una variable y dentro del cuerpo de la función.
Función de múltiples argumentos
Podemos escribir una función con más de un argumento. Considere la función llamada "veces". Es una función sencilla que multiplica dos variables.
times <- function(x,y) {
  x*y
	}
times(2,4)
Salida:
## [1] 8
¿Cuándo deberíamos escribir función?
Los científicos de datos necesitan realizar muchas tareas repetitivas. La mayoría de las veces, copiamos y pegamos fragmentos de código repetidamente. Por ejemplo, se recomienda encarecidamente la normalización de una variable antes de ejecutar un aprendizaje automático algoritmo. La fórmula para normalizar una variable es:

Ya sabemos cómo usar las funciones min() y max() en R. Usamos la biblioteca tibble para crear el marco de datos. Tibble es hasta ahora la función más conveniente para crear un conjunto de datos desde cero.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
Procederemos en dos pasos para calcular la función descrita anteriormente. En el primer paso, crearemos una variable llamada c1_norm, que representa el reescalado de c1. En el segundo paso, simplemente copiaremos y pegaremos el código de c1_norm y lo reemplazaremos con c2 y c3.
Detalle de la función con la columna c1:
Nominador: : data_frame$c1 -min(data_frame$c1))
Denominador: max(data_frame$c1)-min(data_frame$c1))
Por tanto, podemos dividirlos para obtener el valor normalizado de la columna c1:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Podemos crear c1_norm, c2_norm y c3_norm:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
Salida:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
Funciona. Podemos copiar y pegar
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
luego cambie c1_norm a c2_norm y c1 a c2. Hacemos lo mismo para crear c3_norm.
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
Reescalamos perfectamente las variables c1, c2 y c3.
Sin embargo, este método es propenso a errores. Podríamos copiar y olvidar cambiar el nombre de la columna después de pegar. Por lo tanto, una buena práctica es escribir una función cada vez que necesitemos pegar el mismo código más de dos veces. Podemos reorganizar el código en una fórmula y llamarla cuando sea necesario. Para escribir nuestra propia función, necesitamos proporcionar:
- Nombre: normalizar.
- el número de argumentos: solo necesitamos un argumento, que es la columna que usamos en nuestro cálculo.
- El cuerpo: esta es simplemente la fórmula que queremos devolver.
Procederemos paso a paso para crear la función normalizar.
Paso 1) Creamos el numerador, que es x – min(x). En R, podemos almacenar el numerador en una variable de esta manera:
nominator <- x-min(x)
Paso 2) Calculamos el denominador: max(x) – min(x). Podemos replicar la idea del paso 1 y almacenar el cálculo en una variable:
denominator <- max(x)-min(x)
Paso 3) Realizamos la división entre nominador y denominador.
normalize <- nominator/denominator
Paso 4) Para devolver el valor a la función que llama, debemos pasar normalize dentro de return() para obtener el resultado de la función.
return(normalize)
Paso 5) Estamos listos para usar la función mediante envoltorioping todo lo que está dentro del paréntesis.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
Probemos nuestra función con la variable c1:
normalize(data_frame$c1)
Funciona perfectamente. Creamos nuestra primera función.
Una función es una forma más completa de realizar una tarea repetitiva. Podemos usar la fórmula de normalización en diferentes columnas, como se muestra a continuación:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
Aunque el ejemplo es sencillo, podemos apreciar la eficacia de una fórmula. El código anterior es más fácil de leer y evita los errores que suelen producirse al copiar y pegar código.
Funciones con condición
La función normalize() siempre hace lo mismo. A veces, necesitamos incluir condiciones en una función para que el código devuelva resultados diferentes.
En las tareas de aprendizaje automático, necesitamos dividir el conjunto de datos entre un conjunto de trenes y un conjunto de pruebas. El conjunto de trenes permite que el algoritmo aprenda de los datos. Para probar el rendimiento de nuestro modelo, podemos utilizar el conjunto de prueba para devolver la medida de rendimiento. R no tiene una función para crear dos conjuntos de datos. Podemos escribir nuestra propia función para hacer eso. Nuestra función toma dos argumentos y se llama split_data(). La idea detrás es simple: multiplicamos la longitud del conjunto de datos (es decir, el número de observaciones) por 0.8. Por ejemplo, si queremos dividir el conjunto de datos 80/20 y nuestro conjunto de datos contiene 100 filas, entonces nuestra función multiplicará 0.8*100 = 80. Se seleccionarán 80 filas para convertirse en nuestros datos de entrenamiento.
Usaremos el conjunto de datos de calidad del aire para probar nuestra función definida por el usuario. El conjunto de datos sobre calidad del aire tiene 153 filas. Podemos verlo con el siguiente código:
nrow(airquality)
Salida:
## [1] 153
Procederemos de la siguiente manera:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
Nuestra función tiene dos argumentos. El argumento train es un parámetro booleano. Si se establece en VERDADERO, nuestra función crea el conjunto de datos de entrenamiento; de lo contrario, crea el conjunto de datos de prueba.
Podemos proceder como lo hicimos con la función normalize(). Escribimos el código como si fuera un código de uso único y luego envolvemos todo con la condición dentro del cuerpo para crear la función.
Paso 1:
Necesitamos calcular la longitud del conjunto de datos. Esto se hace con la función nrow(). Nrow devuelve el número total de filas del conjunto de datos. A la variable la llamamos longitud.
length<- nrow(airquality)
length
Salida:
## [1] 153
Paso 2:
Multiplicamos la longitud por 0.8. Devolverá el número de filas para seleccionar. Debería ser 153*0.8 = 122.4
total_row <- length*0.8
total_row
Salida:
## [1] 122.4
Queremos seleccionar 122 filas entre las 153 filas del conjunto de datos de calidad del aire. Creamos una lista que contiene valores desde 1 hasta total_row. Almacenamos el resultado en la variable llamada split
split <- 1:total_row
split[1:5]
Salida:
## [1] 1 2 3 4 5
split elige las primeras 122 filas del conjunto de datos. Por ejemplo, podemos ver que nuestra variable split reúne los valores 1, 2, 3, 4, 5, etc. Estos valores serán el índice cuando seleccionemos las filas a devolver.
Paso 3:
Necesitamos seleccionar las filas en el conjunto de datos de calidad del aire en función de los valores almacenados en la variable dividida. Esto se hace así:
train_df <- airquality[split, ]
head(train_df)
Salida:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
Paso 4:
Podemos crear el conjunto de datos de prueba utilizando las filas restantes, 123:153. Esto se hace usando – delante de split.
test_df <- airquality[-split, ]
head(test_df)
Salida:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
Paso 5:
Podemos crear la condición dentro del cuerpo de la función. Recuerde, tenemos un argumento train que es un valor booleano establecido en VERDADERO de forma predeterminada para devolver el conjunto de trenes. Para crear la condición, usamos la sintaxis if:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
Esto es todo, podemos escribir la función. Sólo necesitamos cambiar la calidad del aire a df porque queremos probar nuestra función en cualquier marco de datos, no sólo la calidad del aire:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
Vamos a probar nuestra función con el conjunto de datos de calidad del aire. Deberíamos tener un conjunto de entrenamiento con 122 filas y un conjunto de prueba con 31 filas.
train <- split_data(airquality, train = TRUE)
dim(train)
Salida:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
Salida:
## [1] 31 6
