
Marco de datos R: cómo crear, agregar, seleccionar y crear subconjuntos
 evelyn clarke
⚡ Resumen inteligente
R Data Frame almacena columnas de diferentes tipos con la misma longitud, lo que lo convierte en la estructura rectangular estándar para el análisis. Los corchetes dividen filas y columnas, el signo de dólar selecciona una columna y subset() filtra por condición.
¿Qué es un marco de datos?
A marco de datos Es una lista de vectores de igual longitud. Una matriz contiene un solo tipo de datos, mientras que un marco de datos acepta diferentes tipos de datos (numéricos, caracteres, factores, etc.).
Esa definición sitúa el marco de datos entre dos vecinos que encontrarás constantemente en R. matriz es rectangular pero de un solo tipo, y un lista es multitipo pero irregular. El marco de datos toma prestada una propiedad de cada uno.
| Estructura | Tipos de columna | longitudes de los elementos | Uso típico |
|---|---|---|---|
| Vector | Un solo tipo | Secuencia única | Una variable |
| Matrix | Un solo tipo | Rectangular | Álgebra numérica |
| Lista | Cualquier mezcla de tipos | Puede variar según el elemento. | Cobranzas arbitrarias |
| Marco de datos | Cualquier mezcla de tipos | Cada columna tiene la misma longitud. | Análisis tabular |
Dado que un marco de datos es en realidad una lista en su interior, los métodos de acceso utilizados en las listas también funcionan aquí, razón por la cual el signo de dólar vuelve a aparecer más adelante en este tutorial.
Cómo crear un marco de datos
Podemos crear un marco de datos en R Al pasar las variables a, b, c y d a la función data.frame(), podemos crear el marco de datos y nombrar las columnas con names(), simplemente especificando el nombre de cada variable.
data.frame(df, stringsAsFactors = TRUE)
Argumentos:
- df: Puede ser una matriz para convertir como un marco de datos o una colección de variables para unir
- cadenasAsFactorsControla si los vectores de caracteres se convierten en columnas de factores. El valor predeterminado de fábrica era TRUE en versiones anteriores y ha sido FALSE desde R 4.0.0, así que páselo explícitamente cuando el comportamiento sea importante.
Podemos crear un marco de datos en R para nuestro primer conjunto de datos combinando cuatro variables de la misma longitud.
# Create a, b, c, d variables
a <- c(10,20,30,40)
b <- c('book', 'pen', 'textbook', 'pencil_case')
c <- c(TRUE,FALSE,TRUE,FALSE)
d <- c(2.5, 8, 10, 7)
# Join the variables to create a data frame
df <- data.frame(a,b,c,d)
df
Salida:
##     a         b     c     d
## 1  10        book  TRUE   2.5
## 2  20         pen  FALSE  8.0
## 3  30    textbook  TRUE   10.0
## 4  40 pencil_case  FALSE  7.0
Cada vector se convirtió en una columna, y los cuatro valores de cada vector se convirtieron en las cuatro filas. Cabe destacar que los argumentos no tenían nombre, por lo que R derivó los encabezados de columna a partir de los nombres de las variables.
Podemos ver que los encabezados de las columnas tienen el mismo nombre que las variables. Podemos cambiar el nombre de la columna en R con los nombres de función(). Consulte el ejemplo de creación de marco de datos de R a continuación:
# Name the data frame
names(df) <- c('ID', 'items', 'store', 'price')
df
Salida:
##   ID       items store price
## 1 10        book  TRUE   2.5
## 2 20         pen FALSE   8.0
## 3 30    textbook  TRUE  10.0
## 4 40 pencil_case FALSE   7.0
Asignar un valor a names() reemplaza todos los encabezados a la vez, por lo que el vector de reemplazo debe tener exactamente una entrada por columna. Para renombrar una sola columna, indexe el vector names, como en names(df)[2] <- 'product'.
# Print the structure
str(df)
Salida:
## 'data.frame':    4 obs. of  4 variables:
##  $ ID   : num  10 20 30 40
##  $ items: Factor w/ 4 levels "book","pen","pencil_case",..: 1 2 4 3
##  $ store: logi  TRUE FALSE TRUE FALSE
##  $ price: num  2.5 8 10 7
Nota de versión. La salida anterior se produjo en una versión de R anterior a la 4.0.0, donde data.frame() convertía los vectores de caracteres en factores por defecto, razón por la cual items se informa como un factor con cuatro niveles. La documentación base de R registra que esta configuración predeterminada de fábrica Se cambió a stringsAsFactors = FALSE para R 4.0.0Al ejecutar el mismo código en una versión actual, los elementos aparecen como una columna de caracteres simple, y str() imprime chr en su lugar. Agregue stringsAsFactors = TRUE a la llamada data.frame() para reproducir la salida impresa, o lea el Tutorial de factor para cuando realmente se desean ciertos factores.
Marco de datos de corte
Una vez construido el marco, la siguiente tarea consiste en extraer partes del mismo. El método básico de R para hacerlo es mediante el seccionamiento, que utiliza los mismos corchetes que los vectores, solo que con dos posiciones en lugar de una.
Es posible segmentar los valores de un DataFrame. Seleccionamos las filas y columnas que se desean devolver, entre paréntesis, precedidas por el nombre del DataFrame.
Un marco de datos se compone de filas y columnas, df[A, B]. A representa las filas y B las columnas. Podemos dividir especificando las filas y/o columnas.
En la imagen 1 a continuación, la parte izquierda representa la filas y la parte derecha es la columnas. Tenga en cuenta que el símbolo : significa a. Por ejemplo, 1:3 pretende seleccionar valores de 1 a 3.

En el siguiente diagrama mostramos cómo acceder a diferentes selecciones del marco de datos:
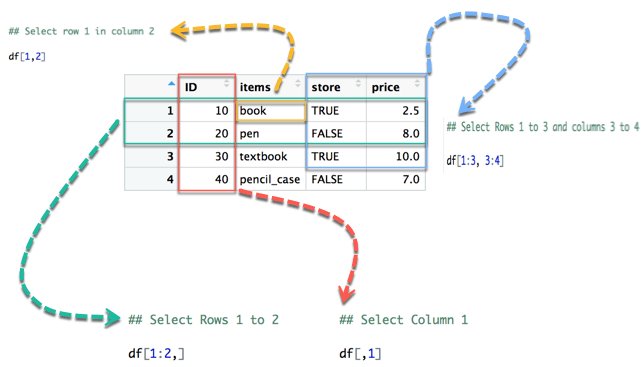
- La flecha amarilla selecciona el fila 1 plg columna 2
- La flecha verde selecciona el filas 1 a 2
- La flecha roja selecciona el columna 1
- La flecha azul selecciona el filas 1 a 3 y columnas 3 a 4
Tenga en cuenta que, si dejamos la parte izquierda en blanco, R seleccionará todas las filas. Por analogía, si dejamos la parte derecha en blanco, R seleccionará todas las columnas.
Podemos ejecutar el código en la consola:
## Select row 1 in column 2
df[1,2]
Salida:
## [1] book
## Levels: book pen pencil_case textbook
La línea Niveles aparece porque items es un factor en esta sesión. En R 4.0.0 y versiones posteriores, la misma llamada imprime la cadena simple “book” sin la línea Niveles.
## Select Rows 1 to 2
df[1:2,]
Salida:
##   ID items store price
## 1 10  book  TRUE   2.5
## 2 20   pen FALSE   8.0
## Select Columns 1
df[,1]
Salida:
## [1] 10 20 30 40
Al seleccionar una sola columna con df[,1], se elimina el contenedor del marco de datos y se devuelve un vector simple. Añada drop = FALSE, como en df[, 1, drop = FALSE], cuando se necesite un marco de datos de una sola columna.
## Select Rows 1 to 3 and columns 3 to 4
df[1:3, 3:4]
Salida:
##   store price
## 1  TRUE   2.5
## 2 FALSE   8.0
## 3  TRUE  10.0
También es posible seleccionar las columnas por sus nombres. Por ejemplo, el código a continuación muestra:tracTiene dos columnas: ID y tienda.
# Slice with columns name
df[, c('ID', 'store')]
Salida:
##   ID store
## 1 10  TRUE
## 2 20 FALSE
## 3 30  TRUE
## 4 40 FALSE
Los nombres son más seguros que las posiciones en el código de producción, porque insertar o reordenar una columna cambia silenciosamente a qué se refiere df[, 3] mientras que df[, 'store'] sigue apuntando a los mismos datos.
Agregar una columna al marco de datos
También puedes agregar una columna a un DataFrame. Para ello, debes usar el símbolo $ para nombrar la nueva variable y añadir una columna al DataFrame en R.
# Create a new vector
quantity <- c(10, 35, 40, 5)

# Add `quantity` to the `df` data frame
df$quantity <- quantity
df
Salida:
##   ID       items store price quantity
## 1 10        book  TRUE   2.5       10
## 2 20         pen FALSE   8.0       35
## 3 30    textbook  TRUE  10.0       40
## 4 40 pencil_case FALSE   7.0        5
Nota: El número de elementos en el vector debe ser igual al número de elementos en el marco de datos. Ejecutando la siguiente instrucción para agregar una columna al marco de datos en R
quantity <- c(10, 35, 40)
# Add `quantity` to the `df` data frame
df$quantity <- quantity
Da error:
Error in `lt;-.data.frame`(`*tmp*`, quantity, value = c(10, 35, 40))
replacement has 3 rows, data has 4
El mensaje especifica el operador de reemplazo para los data frames e indica ambos recuentos, por lo que le indica exactamente qué debe corregir. R solo reutiliza un reemplazo cuando su longitud divide exactamente el número de filas, razón por la cual se acepta un valor de longitud 1 como df$currency <- 'EUR', mientras que se rechaza un vector de longitud 3 con cuatro filas. cbind() agrega una columna de la misma manera, y rbind() es su equivalente para agregar filas.
Seleccionar una columna de un marco de datos
En ocasiones, necesitamos guardar una columna de un marco de datos para usarla posteriormente o realizar alguna operación sobre ella. Podemos usar el signo $ para seleccionar la columna deseada.
# Select the column ID
df$ID
Salida:
## [1] 1 2 3 4
Lea la salida con atención. El ID se construyó a partir del vector c(10, 20, 30, 40), por lo que una consola en vivo imprime 10 20 30 40 aquí; los números 1 2 3 4 que se muestran arriba son posiciones de fila, no los valores almacenados. El [1] al comienzo de la línea es simplemente el índice del primer elemento de esa línea, no forma parte de los datos.
Tres rutas llegan a la misma columna: df$ID, df[['ID']] y df[, 'ID']. El signo de dólar realiza una coincidencia parcial, por lo que df$I aún encontraría ID, lo cual es conveniente en la consola pero arriesgado en un script guardado.
Subconjunto de un marco de datos
En la sección anterior, seleccionamos una columna completa sin condición. Es posible subconjunto en función de si una determinada condición era cierta o no.
Usamos la función subconjunto().
subset(x, condition)
arguments:
- x: data frame used to perform the subset
- condition: define the conditional statement
Queremos devolver únicamente los artículos con un precio superior a 5, por lo que podemos hacer lo siguiente:
# Select price above 5
subset(df, subset = price > 5)
Salida:
ID       items store price
2 20         pen FALSE     8
3 30    textbook  TRUE    10
4 40 pencil_case FALSE     7
Las etiquetas de fila 2, 3 y 4 son los nombres de fila originales que se conservan de df, lo que permite saber que la primera fila se filtró. subset() también acepta un argumento select para seleccionar columnas simultáneamente, y la forma equivalente entre corchetes es df[df$price > 5, ]. La forma entre corchetes conserva las filas con valores NA cuando falta la condición, mientras que subset() las elimina, por lo que no siempre son intercambiables.
