
ANOVA en R: Pruebas unidireccionales y bidireccionales con ejemplos
 Equipo editorial
⚡ Resumen inteligente
El análisis de varianza (ANOVA) en R compara las medias de tres o más grupos dividiendo la variación total en componentes intergrupales e intragrupales. Este tutorial ejecuta pruebas unidireccionales y bidireccionales en el conjunto de datos de venenos, verifica los supuestos y aísla los pares que difieren con la prueba HSD de Tukey.
¿Qué es ANOVA?
Análisis de variación (ANOVA) es una técnica estadística que se utiliza para comparar las medias de dos o más grupos. La prueba funciona dividiendo la variación total de una medición en la parte explicada por la pertenencia al grupo y la parte restante como ruido aleatorio. Por lo tanto, ANOVA en R indica si al menos una media de grupo difiere de las demás, no cuál. Es una extensión directa de la prueba t a situaciones en las que la variable factorial tiene más de dos niveles.
Antes de realizar una prueba, conviene saber qué miembro de la familia ANOVA se ajusta mejor a su diseño.
Tipos de pruebas ANOVA en R
El análisis de varianza (ANOVA) es un conjunto de pruebas, no un procedimiento único. La elección de la prueba adecuada depende de la cantidad de factores que se tengan y de cómo se hayan recopilado los datos.
| Prueba | Cuando usarlo | Llamada R |
|---|---|---|
| ANOVA unidireccional | Un factor con tres o más niveles | aov(y ~ x, datos = df) |
| ANOVA bidireccional | Dos factores independientes | aov(y ~ x1 + x2, datos = df) |
| Bidireccional con interacción | El efecto de un factor depende del otro. | aov(y ~ x1 * x2, datos = df) |
| ANOVA de medidas repetidas | Los mismos sujetos fueron medidos más de una vez. | aov(y ~ x + Error(sujeto/x)) |
| ÁNCOVA | Se debe controlar una covariable continua | aov(y ~ x + covariable, datos = df) |
| MANOVA | Dos o más variables de respuesta a la vez | manova(cbind(y1, y2) ~ x) |
Este tutorial cubre las tres primeras. Las variantes restantes utilizan la misma interfaz aov(), así que una vez que sepas leer una tabla de salida, podrás leerlas todas.
ANOVA frente a prueba t en R: diferencias clave
Ambas pruebas comparan medias, por lo que conviene ser precisos sobre dónde una reemplaza a la otra.
| Criterios | Prueba T | ANOVA |
|---|---|---|
| Número de grupos | Exactamente dos | Dos o más |
| Estadística de prueba | t | F, igual a t al cuadrado cuando hay dos grupos |
| Resultado | Indica la dirección de la diferencia | Solo se informa que existe una diferencia. |
| Se necesita seguimiento | Ninguna | Pruebas post hoc como la prueba HSD de Tukey |
| Función R | prueba t() | aov() |
La tentación con tres grupos es realizar tres pruebas t separadas. Resístase. Cada prueba tiene su propia tasa de error del 5 por ciento, por lo que tres comparaciones aumentan la probabilidad de un falso positivo a aproximadamente el 14 por ciento. ANOVA responde a la misma pregunta con una sola prueba, y Tukey HSD luego maneja el detalle de pares con la tasa de error controlada. Para el caso de dos grupos, vea la Tutorial de la prueba t.
ANOVA unidireccional
Hay muchas situaciones en las que es necesario comparar la media entre varios grupos. Por ejemplo, el departamento de marketing quiere saber si tres equipos tienen el mismo rendimiento de ventas.
- Equipo: factor de 3 niveles: A, B y C
- Venta: una medida de desempeño
La prueba ANOVA puede determinar si los tres grupos tienen rendimientos similares.
Para aclarar si los datos provienen de la misma población, se puede realizar una Análisis de varianza de una sola vía (ANOVA unidireccional en adelante). Al igual que cualquier otra prueba estadística, proporciona evidencia sobre si se puede rechazar la hipótesis nula (H0). Cabe señalar que no rechazar H0 no equivale a demostrar su veracidad.
Hipótesis en la prueba ANOVA de una vía
- H0: Las medias entre grupos son idénticas
- H1: Al menos, la media de un grupo es diferente
En otras palabras, no rechazar H0 significa que no hay suficiente evidencia para concluir que la media de algún grupo difiere de las demás.
Esta prueba es similar a la prueba t, pero el análisis de varianza (ANOVA) es la opción correcta cuando hay más de dos grupos. Con exactamente dos grupos, ambas pruebas son equivalentes y el estadístico F es igual al cuadrado del estadístico t.
Supuestos
El análisis de varianza unidireccional (ANOVA) se basa en tres condiciones: las observaciones se seleccionan aleatoriamente y son independientes entre sí, los residuos dentro de cada grupo siguen una distribución aproximadamente normal y la varianza es la misma en todos los grupos (homogeneidad de la varianza). La sección sobre la verificación de supuestos que se presenta a continuación muestra cómo comprobar cada uno de ellos en R.
Interpretar la prueba ANOVA
El estadístico F se utiliza para probar si los datos provienen de poblaciones significativamente diferentes, es decir, medias muestrales diferentes.
Para calcular el estadístico F, es necesario dividir el variabilidad entre grupos sobre la variabilidad dentro del grupo.
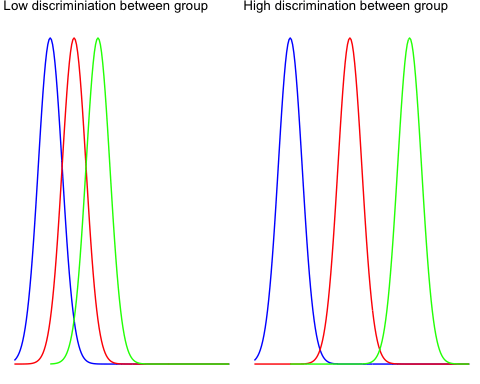
El entre grupos La variabilidad refleja la distancia entre la media de cada grupo y la media general. Compare los dos gráficos a continuación para comprender mejor este concepto.
El gráfico de la izquierda muestra muy poca variación entre los tres grupos, por lo que las medias de los tres grupos se sitúan cerca de la total media.
El gráfico de la derecha muestra tres distribuciones muy separadas sin superposición, por lo que la diferencia entre la media general y la media de cada grupo es grande.
El dentro del grupo La variabilidad mide qué tan lejos se encuentran las observaciones individuales de la media de su propio grupo. Algunos puntos se sitúan lejos del promedio de su grupo, y el término intragrupal captura precisamente esa dispersión, que es el error de muestreo.
Para comprender visualmente el concepto de variabilidad dentro del grupo, observe el siguiente gráfico.
La parte izquierda muestra la distribución de tres grupos diferentes. Al aumentar la dispersión de cada muestra, queda claro que la varianza individual es grande. El estadístico F disminuye, por lo que no se rechazaría la hipótesis nula.
La parte derecha muestra muestras con las mismas medias pero con una dispersión mucho menor. Esto eleva el estadístico F y apunta a favor de la hipótesis alternativa.

Puede utilizar ambas medidas para construir el estadístico F. Es muy intuitivo comprender el estadístico F. Si el numerador aumenta, significa que la variabilidad entre grupos es alta y es probable que los grupos de la muestra provengan de distribuciones completamente diferentes.
En otras palabras, un valor bajo del estadístico F indica que existe poca o ninguna diferencia significativa entre las medias de los grupos.
Ejemplo de prueba ANOVA unidireccional
Utilizará el conjunto de datos de veneno para implementar la prueba ANOVA unidireccional. El conjunto de datos contiene 48 filas y 3 variables:
- Tiempo: Tiempo de supervivencia del animal.
- veneno: Tipo de veneno utilizado: nivel de factor: 1,2 y 3
- tratar: Tipo de tratamiento utilizado: nivel de factor: 1,2 y 3
Antes de comenzar a calcular la prueba ANOVA, debe preparar los datos de la siguiente manera:
- Paso 1: importar los datos
- Paso 2: eliminar la variable innecesaria
- Paso 3: convertir la variable veneno como nivel ordenado
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/poisons.csv"
df <- read.csv(PATH) %>%
select(-X) %>%
mutate(poison = factor(poison, ordered = TRUE))
glimpse(df)
Salida:
## Observations: 48
## Variables: 3
## $ time   <dbl> 0.31, 0.45, 0.46, 0.43, 0.36, 0.29, 0.40, 0.23, 0.22, 0...
## $ poison <ord> 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 1, 1, 1, 1, 2, 2, 2...
## $ treat  <fctr> A, A, A, A, A, A, A, A, A, A, A, A, B, B, B, B, B, B, ...
Nuestro objetivo es probar la siguiente suposición:
- H0: No hay diferencia en el tiempo promedio de supervivencia entre los grupos.
- H1: El promedio del tiempo de supervivencia es diferente para al menos un grupo.
En otras palabras, se quiere saber si existe una diferencia estadística entre la media del tiempo de supervivencia según el tipo de veneno administrado al conejillo de indias.
Procederá de la siguiente manera:
- Paso 1: Verifique el formato de la variable veneno
- Paso 2: Imprima el resumen estadístico: recuento, media y desviación estándar
- Paso 3: Dibuje un diagrama de caja
- Paso 4: Calcule la prueba ANOVA unidireccional
- Paso 5: Realizar una comparación por pares con la prueba HSD de Tukey.
Paso 1) Comprueba los niveles de veneno con el código que aparece a continuación. Deberías ver tres valores de caracteres, ya que el verbo mutate convirtió la columna en un factor ordenado.
levels(df$poison)
Salida:
## [1] "1" "2" "3"
Paso 2) Calcula la media y la desviación estándar.
df %>%
	group_by(poison) %>%
	summarise(
		count_poison = n(),
		mean_time = mean(time, na.rm = TRUE),
		sd_time = sd(time, na.rm = TRUE)
	)
Salida:
##
# A tibble: 3 x 4
##   poison count_poison mean_time    sd_time
##    <ord>        <int>     <dbl>      <dbl>
## 1      1           16  0.617500 0.20942779
## 2      2           16  0.544375 0.28936641
## 3      3           16  0.276250 0.06227627
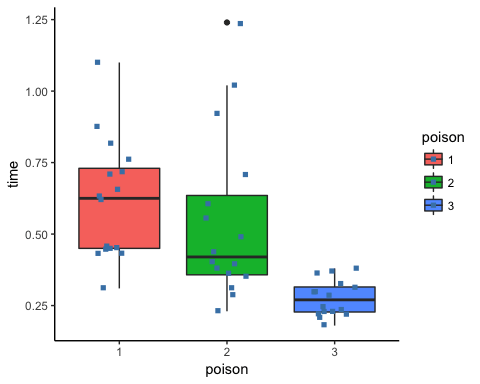
Paso 3) En el paso tres, puedes comprobar gráficamente si hay una diferencia entre la distribución. Tenga en cuenta que incluye el punto nervioso.
ggplot(df, aes(x = poison, y = time, fill = poison)) +
    geom_boxplot() +
    geom_jitter(shape = 15,
        color = "steelblue",
        position = position_jitter(0.21)) +
    theme_classic()
Salida:
Paso 4) Puede ejecutar la prueba ANOVA unidireccional con el comando aov. La sintaxis básica de una prueba ANOVA es:
aov(formula, data)
Arguments:
- formula: The equation you want to estimate
- data: The dataset used
La sintaxis de la fórmula es:
y ~ X1+ X2+...+Xn # X1 +  X2 +... refers to the independent variables
y ~ . # use all the remaining variables as independent variables
Ahora puedes responder a la pregunta: ¿existe alguna diferencia en el tiempo de supervivencia entre los conejillos de indias, dado el tipo de veneno administrado?
Almacena el modelo en un objeto y pásalo a summary() para obtener una impresión legible de los resultados.
anova_one_way <- aov(time~poison, data = df)
summary(anova_one_way)
Code Explicación
- aov(tiempo ~ veneno, datos = df): Ejecute la prueba ANOVA con la siguiente fórmula
- summary(anova_one_way): Imprime el resumen de la prueba
Salida:
##             Df Sum Sq Mean Sq F value   Pr(>F)
## poison       2  1.033  0.5165   11.79 7.66e-05 ***
## Residuals   45  1.972  0.0438
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
El valor p es 7.66e-05, muy por debajo del umbral habitual de 0.05, y los tres asteriscos indican la mayor significancia estadística. Se puede rechazar H0 y concluir que al menos un grupo de veneno tiene un tiempo medio de supervivencia diferente.
Cómo comprobar los supuestos del ANOVA en R
Un valor p de ANOVA solo es fiable cuando se cumplen las tres condiciones mencionadas anteriormente. Cada una de ellas se verifica directamente en R, y todas se ejecutan sobre el objeto del modelo ajustado.
1. Independencia de las observaciones. Esta es una característica del diseño del estudio, no de los datos, por lo que ninguna prueba puede corregirla. Cada cobaya debe medirse una sola vez y asignarse a su grupo al azar. Si el mismo sujeto aparece en varias filas, se necesita un modelo de medidas repetidas.
2. Normalidad de los residuos. El análisis de varianza (ANOVA) asume que los residuos, no los datos brutos, siguen una distribución aproximadamente normal. Examine el gráfico QQ y confirme con la prueba de Shapiro-Wilk:
par(mfrow = c(2, 2))
plot(anova_one_way)          # four diagnostic plots

shapiro.test(residuals(anova_one_way))
Los puntos que se aproximan a la diagonal del gráfico QQ normal indican residuos normales. Un valor p de Shapiro-Wilk superior a 0.05 significa que no se puede rechazar la normalidad.
3. Homogeneidad de la varianza. Cada grupo debería mostrar una dispersión similar. El gráfico de residuos frente a valores ajustados debería tener forma de banda plana en lugar de embudo. Confírmelo con la prueba de Levene, que es más robusta ante la falta de normalidad que la de Bartlett.
library(car)
leveneTest(time ~ poison, data = df)

bartlett.test(time ~ poison, data = df)
Un valor p superior a 0.05 respalda la igualdad de varianzas.
Qué hacer cuando una suposición resulta ser incorrecta. Si las varianzas son desiguales, ejecute oneway.test(time ~ poison, data = df, var.equal = FALSE), la corrección de Welch. Si los residuos no siguen una distribución normal y la muestra es pequeña, cambie a la prueba de rangos de Kruskal-Wallis, kruskal.test(time ~ poison, data = df). Con muestras grandes y equilibradas, el ANOVA es bastante robusto ante desviaciones moderadas de la normalidad, por lo que un resultado límite de Shapiro-Wilk rara vez es fatal.
Comparación por pares
Una prueba F significativa indica que las medias de los grupos no son todas iguales, pero no especifica qué par difiere. La prueba de diferencia significativa honesta de Tukey responde a esta pregunta comparando cada par y controlando la tasa de error global.
TukeyHSD(anova_one_way)
Salida:

Lea la salida una fila por par. diff La columna contiene la diferencia entre las medias de los dos grupos, lvr y licencia acotar el intervalo de confianza del 95 por ciento para esa diferencia, y p adj es el valor p ajustado para comparaciones múltiples. Un par difiere significativamente cuando su intervalo excluye el cero, lo que equivale a cuando p adj es inferior a 0.05. En este conjunto de datos, las comparaciones que involucran al veneno 3 son las significativas, lo que coincide con el diagrama de caja: el grupo 3 tiene un tiempo de supervivencia medio claramente menor que los grupos 1 y 2, mientras que los grupos 1 y 2 son estadísticamente indistinguibles entre sí.
ANOVA bidireccional
Un ANOVA bidireccional añade un segundo factor a la fórmula. Funciona exactamente igual que la prueba unidireccional, solo que la fórmula cambia:
y ~ x1 + x2
Aquí, y es la variable de respuesta cuantitativa, mientras que x1 y x2 son factores categóricos.
Hipótesis en la prueba ANOVA de dos vías
- H0: Las medias de los grupos son iguales para ambas variables factoriales.
- H1: Al menos una media grupal difiere, para al menos uno de los dos factores.
Se añade la variable de tratamiento al modelo. Esta variable registra el tratamiento administrado al conejillo de indias. La fórmula aditiva que se muestra a continuación evalúa si cada factor afecta al tiempo de supervivencia de forma individual, teniendo en cuenta el efecto de los demás.
Modifique el código agregando "tratar" junto a la primera variable independiente.
anova_two_way <- aov(time~poison + treat, data = df)
summary(anova_two_way)
Salida:
##             Df Sum Sq Mean Sq F value  Pr(>F)
## poison       2 1.0330  0.5165   20.64 5.7e-07 ***
## treat        3 0.9212  0.3071   12.27 6.7e-06 ***
## Residuals   42 1.0509  0.0250
## ---
Ambos valores p (5.7e-07 para el veneno y 6.7e-06 para el tratamiento) están muy por debajo de 0.05, por lo que se rechaza H0 para ambos factores y se concluye que cambiar el veneno o el tratamiento afecta el tiempo de supervivencia.
Agregar un término de interacción
El modelo aditivo anterior supone que el efecto del veneno es el mismo independientemente del tratamiento. Para comprobar esta suposición, sustituya el signo más por un asterisco, que representa tanto los efectos principales como su interacción:
anova_interaction <- aov(time~poison * treat, data = df)
summary(anova_interaction)
Si la fila de veneno/tratamiento no es significativa, el modelo aditivo es la mejor opción porque consume menos grados de libertad.
ANOVA en R: Guía rápida de pruebas
La tabla que aparece a continuación enumera cada prueba utilizada anteriormente, la llamada a R que la ejecuta y la hipótesis que evalúa:
| Prueba | Code | Hipótesis | P-valor |
|---|---|---|---|
| ANOVA de una vía |
aov(y ~ X, data = df)
|
H1: El promedio es diferente para al menos un grupo | 0.05 |
| Por parejas |
TukeyHSD(ANOVA summary) |
0.05 | |
| ANOVA de dos vías |
aov(y ~ X1 + X2, data = df)
|
H1: Al menos una media de grupo difiere para cualquiera de los factores. | 0.05 |
