
Prueba t en programación R: Ejemplo con una muestra y un ejemplo con datos pareados.
 Equipo editorial
⚡ Resumen inteligente
La prueba t en R compara medias mediante la función t.test(), abarcando una muestra frente a un objetivo fijo, dos grupos independientes y medidas repetidas pareadas. Este tutorial ejecuta cada variante, lee correctamente el valor p y verifica los supuestos subyacentes.
¿Qué es la inferencia estadística?
La inferencia estadística es el arte de generar conclusiones sobre la distribución de los datos. Un científico de datos a menudo se enfrenta a preguntas que solo pueden responderse científicamente. Por lo tanto, la inferencia estadística es una estrategia para comprobar si una hipótesis es verdadera, es decir, si está validada por los datos.
Una estrategia común para evaluar una hipótesis es la prueba t, que indica si dos medias son iguales. También se conoce como la Prueba del estudianteSe puede calcular una prueba t para:
- Un único vector frente a un valor fijo (prueba t de una muestra)
- Dos vectores de dos grupos separados (prueba t de Student para dos muestras independientes)
- Dos vectores medidos en los mismos sujetos (prueba t pareada)
Toda prueba t presupone que los datos se obtienen mediante muestreo aleatorio y que los valores (o, en el caso de una prueba pareada, las diferencias) provienen de una población con distribución aproximadamente normal. La versión para dos muestras independientes presupone, además, que los dos grupos son independientes entre sí, y la versión clásica presupone que sus varianzas son iguales.
¿Qué es la prueba T en la programación R?
La idea básica detrás de una prueba T es utilizar estadísticas para evaluar dos hipótesis contrarias:
- H0: la hipótesis nula, que establece que la media poblacional es igual al valor que se está probando.
- H1: la hipótesis alternativa, que la media poblacional difiere de ese valor.
La prueba t está diseñada para muestras pequeñas, donde la aproximación normal no es fiable. Requiere que los datos tengan una distribución aproximadamente normal.
Sintaxis de prueba T en R
La sintaxis básica para t.test() en R es:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
Antes de ejecutar cualquier prueba, asegúrese de que el formato de sus datos coincida con la variante correcta de la prueba.
Tipos de prueba t en R
Elegir la variante incorrecta es el error más común en las pruebas t, así que comience por hacer coincidir la estructura de sus datos con la llamada correcta.
| Tipo | Úselo cuando | Llamada R |
|---|---|---|
| Una muestra | Un grupo comparado con un valor objetivo conocido | t.test(x, mu = valor) |
| Muestra independiente de dos muestras (Welch) | Dos grupos separados, con varianzas posiblemente desiguales. | t.test(x, y) |
| Muestra independiente de dos muestras (agrupadas) | Dos grupos separados con varianza igual | t.test(x, y, var.equal = TRUE) |
| Emparejado | Los mismos sujetos fueron medidos dos veces. | t.test(x, y, paired = TRUE) |
| Unilateral | Solo te importa una diferencia en una dirección. | t.test(x, mu = valor, alternativa = “mayor”) |
Más allá de tres grupos, una prueba t ya no es apropiada. Cambie a la Prueba ANOVA, lo que mantiene la tasa de error general en un 5 por ciento en lugar de aumentarla en comparaciones por pares repetidas.
Prueba T de una muestra en R
La prueba t de una muestra, o prueba de Student, compara la media de un vector con una media teórica,  . La fórmula utilizada para calcular la prueba t es:

Aquí,
 se refiere a la media
 a la media teórica
- s es la desviación estándar
- n el número de observaciones.
 se refiere a la media
Para evaluar la significancia estadística de la prueba t, es necesario calcular la valor de p. La función de valor de p varía de 0 a 1 y se interpreta de la siguiente manera:
- Un valor p inferior a 0.05 significa que se puede rechazar la hipótesis nula. Cabe destacar que rechazar H0 no equivale a demostrar que H1 es verdadera; simplemente significa que los datos son poco probables bajo H0.
- Un valor p superior a 0.05 indica que no hay pruebas suficientes para rechazar la hipótesis nula.
Puede construir el valor p observando el valor absoluto correspondiente de la prueba t en la distribución de Student con un grado de libertad igual a 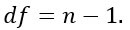
Por ejemplo, con 5 observaciones, se compara el valor t con la distribución t de Student con 4 grados de libertad y un nivel de confianza del 95 %. Para rechazar la hipótesis nula en una prueba bilateral, el valor t absoluto debe ser superior a 2.776.
Véase la siguiente tabla:

Un ejemplo de prueba T de muestra en R
Supongamos que es una empresa que produce cookies. Se supone que cada galleta contiene 10 gramos de azúcar. Las galletas se producen mediante una máquina que añade el azúcar en un bol antes de mezclarlo todo. Crees que la máquina no añade 10 gramos de azúcar por cada galleta. Si su suposición es cierta, es necesario reparar la máquina. Almacenaste el nivel de azúcar de treinta galletas.
Nota: : Puedes crear un vector aleatorio con la función rnorm(). Esta función genera valores distribuidos normalmente. La sintaxis básica es:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
Puede crear una distribución con 30 observaciones con una media de 9.99 y una desviación estándar de 0.04.
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
Salida:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
Puede utilizar una prueba t de una muestra para comprobar si el nivel de azúcar es diferente al de la receta. Puedes dibujar una prueba de hipótesis:
- H0: El nivel medio de azúcar es igual a 10
- H1: El nivel medio de azúcar es diferente a 10
Se utiliza un nivel de significancia de 0.05.
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
Aquí está el resultado:

El valor p de la prueba t de una muestra es 0.1079, superior al umbral de 0.05. El intervalo de confianza del 95 % para la media abarca desde 9.973 hasta 10.002 gramos e incluye el valor objetivo de 10. Por lo tanto, no se puede rechazar H0: no hay suficiente evidencia de que la máquina se desvíe de la receta.
Prueba t de dos muestras independientes en R
La prueba t de Student para dos muestras independientes es la variante más utilizada y se aplica siempre que los dos conjuntos de mediciones provengan de sujetos diferentes: dos tiendas, dos máquinas, dos grupos de tratamiento.
Supongamos que una fábrica tiene dos líneas de producción y quieres saber si llenan los frascos con el mismo peso.
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
Lee el resultado en cuatro pasos.
- t es el tamaño estandarizado de la diferencia entre las dos medias. Su signo solo refleja el orden en que se pasaron los vectores.
- df son los grados de libertad. Welch produce un valor fraccional; la prueba combinada da un número entero igual a n1 + n2 – 2.
- valor de p es la probabilidad de ver una brecha tan grande si las medias reales fueran idénticas.
- Intervalo de confianza delimita la diferencia real. Cuando contiene cero, la diferencia no es significativa a ese nivel.
Si sus datos se encuentran en un único marco de datos con una columna de valores y una columna de factores, utilice la interfaz de fórmulas, que es más fácil de leer y evita tener que dividir los datos manualmente:
t.test(weight ~ line, data = jars)
¿Qué versión usar? Deje var.equal en su valor predeterminado de FALSE a menos que haya probado y confirmado que las varianzas son iguales. La corrección de Welch prácticamente no consume energía cuando las varianzas coinciden y le protege cuando no lo hacen.
Prueba T emparejada en R
La prueba t pareada, también llamada prueba t para muestras dependientes, se aplica cuando se mide dos veces el mismo grupo. Las aplicaciones típicas son:
- Pruebas A / B: Compara dos variantes
- Estudios de casos y controles: antes y después de un tratamiento en los mismos sujetos
Ejemplo de prueba T pareada en R
Una empresa de bebidas está interesada en conocer el desempeño de un programa de descuentos en las ventas. La empresa decidió hacer un seguimiento de las ventas diarias de una de sus tiendas donde se promociona el programa. Al final del programa, la empresa quiere saber si existe una diferencia estadística entre las ventas promedio de la tienda antes y después del programa.
- La compañía tracRegistramos las ventas todos los días antes de que comenzara el programa. Este es nuestro primer vector.
- El programa se promociona durante una semana y las ventas se registran todos los días. Este es nuestro segundo vector.
- Realizará la prueba t para juzgar la efectividad del programa. Esto se llama prueba t pareada porque los valores de ambos vectores provienen de la misma distribución (es decir, la misma tienda).
La prueba de hipótesis es:
- H0: No hay diferencia en la media
- H1: Los dos medios son diferentes
Recuerda que la prueba t clásica presupone una varianza desconocida pero igual en ambos grupos. Los datos reales rara vez cumplen esta condición exactamente, e ignorar la diferencia puede distorsionar el resultado.
La solución es la prueba t de Welch, que flexibiliza el supuesto de varianza igual. R la aplica por defecto porque var.equal es FALSE a menos que se especifique lo contrario. En este conjunto de datos, ambos vectores se generaron con la misma desviación estándar, por lo que puede establecer var.equal = TRUE sin problemas.
Crea dos vectores aleatorios a partir de una distribución gaussiana con una media más alta para las ventas después del programa.
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

El valor p es 0.04606, justo por debajo del umbral de 0.05, por lo que se rechaza H0 y se concluye que las dos medias difieren significativamente. El programa de descuentos parece haber impulsado las ventas.
⚠️ Importante: La llamada anterior compara los dos vectores como independiente muestras. Debido a que ambas series son mediciones en el mismo taller, la llamada estadísticamente correcta añade emparejado = VERDADERO:
t.test(sales_before, sales_after, paired = TRUE)
La prueba de comparación por pares evalúa la media de las diferencias diarias en lugar de la diferencia entre dos medias. Elimina la variación a nivel de tienda que comparten ambos vectores y, por lo tanto, tiene mayor potencia estadística.
Cómo comprobar los supuestos de la prueba t en R
El valor p de una prueba t solo tiene sentido cuando se cumplen sus supuestos. Cada uno tiene una verificación directa.
1. Normalidad. Las pruebas de una muestra y de dos muestras suponen que los valores son aproximadamente normales; la prueba pareada supone que diferencias son. Inspeccione un gráfico QQ y confirme con la prueba de Shapiro-Wilk:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
Un valor p de Shapiro-Wilk superior a 0.05 significa que no se puede rechazar la normalidad. Con más de 30 observaciones por grupo, el teorema del límite central hace que la prueba t sea robusta ante una asimetría moderada.
2. Varianza igual. Solo la prueba combinada de dos muestras necesita esto. Pruébelo con una prueba F:
var.test(line_a, line_b)
Un valor p superior a 0.05 respalda la igualdad de varianzas, lo que justifica var.equal = TRUE.
3. Independencia. Esto se desprende del diseño del estudio y no puede comprobarse a posteriori. Si el mismo sujeto contribuye a ambos vectores, la prueba independiente es simplemente la herramienta incorrecta y se necesita la condición paired = TRUE.
Cuando una suposición falla. Para datos claramente no normales con muestras pequeñas, utilice las alternativas basadas en rangos: wilcox.test(x, y) reemplaza la prueba t de dos muestras y wilcox.test(x, y, paired = TRUE) reemplaza la versión para muestras pareadas. Ninguna requiere normalidad, aunque ambas pierden algo de potencia cuando los datos son, de hecho, normales.
Prueba t en R: Aspectos clave y referencia de la prueba
- La inferencia estadística es el arte de generar conclusiones sobre la distribución de los datos.
- La prueba T pertenece a la familia de la estadística inferencial. Se emplea habitualmente para averiguar si existe una diferencia estadística entre las medias de dos grupos.
- La prueba t de una muestra, o prueba t de Student, compara la media de un vector con una media teórica.
- La prueba t pareada, o prueba t para muestras dependientes, se aplica cuando se mide dos veces el mismo grupo.
La siguiente tabla resume cada una de las pruebas mencionadas anteriormente:
| Prueba | Hipótesis a probar | valor de p | Code | Argumento opcional |
|---|---|---|---|---|
| prueba t de una muestra | La media de un vector es diferente de la media teórica. | 0.05 |
t.test(x, mu = mean)
|
|
| prueba t de muestras pareadas | La media A es diferente de la media B para los mismos sujetos. | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
Si está dispuesto a asumir varianzas iguales en una prueba independiente de dos muestras, establezca var.equal = TRUE. Déjelo en el valor predeterminado FALSE para ejecutar la corrección de Welch, que es más segura.
