
Tutorial de prueba de fuzz (fuzzing)
 Equipo editorial
⚡ Resumen inteligente
Las pruebas de fuzzing introducen datos no válidos, inesperados o aleatorios en un programa y observan si se producen fallos, bloqueos o errores de memoria, lo que permite detectar defectos de seguridad que las pruebas funcionales basadas en scripts casi nunca detectan por sí solas.
¿Qué es la prueba Fuzz?
Pruebas de fuzzing o fuzzing Fuzz es una técnica de prueba de software que consiste en introducir datos no válidos o aleatorios (conocidos como FUZZ) en un sistema informático para descubrir errores de codificación y vulnerabilidades de seguridad. El objetivo de las pruebas Fuzz es insertar datos mediante técnicas automatizadas o semiautomatizadas y probar el sistema en busca de diversas excepciones, como fallos del sistema o errores en el código integrado.
Las pruebas de fuzzing fueron desarrolladas originalmente por Barton Miller en la Universidad de Wisconsin-Madison, quien acuñó el término después de que el ruido de la línea en un enlace de módem provocara el fallo de los programas que estaba utilizando. Sus estudiantes ejecutaron los primeros fuzzers en 1989 y descubrieron que aproximadamente un tercio de las utilidades UNIX a las que apuntaban fallaban o se bloqueaban. Las pruebas de fuzzing son una herramienta para detectar errores de programación. pruebas de software técnica, y es un tipo de Pruebas de seguridad.
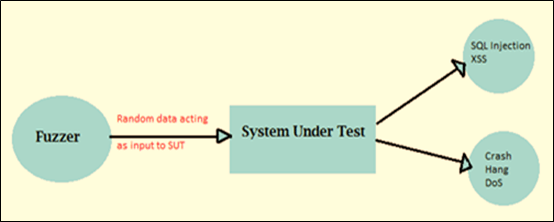
El diagrama que aparece a continuación muestra el ciclo básico de pruebas de fuzzing, donde se envían datos generados a la aplicación que se está probando y se observa la respuesta.
¿Por qué hacer pruebas Fuzz?
El fuzzing se justifica en un plan de pruebas porque explora entradas para las que nadie pensó en escribir un caso de prueba. Las principales razones por las que los equipos lo adoptan se enumeran a continuación.
- Las pruebas de fuzzing suelen detectar los fallos y defectos de seguridad más graves, ya que un fallo del sistema es una prueba directa de una ruta de entrada no gestionada correctamente.
- Las pruebas de fuzz dan un resultado más efectivo cuando se utilizan con Negro Box Pruebas, Pruebas Beta y otros métodos de depuración.
- Las pruebas de fuzzing se utilizan para comprobar la vulnerabilidad del software y son una técnica de prueba muy rentable porque las entradas se generan automáticamente en lugar de escribirse manualmente.
- Las pruebas de fuzzing son una de las técnicas de prueba de caja negra. Además, son uno de los métodos más comunes que utilizan los hackers para encontrar vulnerabilidades en un sistema, por lo que ejecutarlas primero elimina la vía de acceso más fácil para un atacante.
Tipos de pruebas de fuzzing
Los fuzzers suelen clasificarse según el nivel de conocimiento que poseen sobre el programa que atacan. Cuanto más conocimiento tenga el fuzzer, más podrá penetrar en el código.
| Tipo | Lo que sabe el fuzzer | Uso típico |
| Fuzzing de caja negra | No muestra nada sobre el funcionamiento interno; solo detecta entradas y salidas. | Pruebas rápidas de humo contra un binario o un punto final en tiempo real. |
| Fuzzing de caja blanca | Código fuente completo, a menudo combinado con ejecución simbólica para resolver bifurcaciones de difícil acceso. | Análisis exhaustivo de un componente cuya fuente está disponible. |
| Fuzzing de caja gris | No se realiza una revisión del código fuente, sino que se proporciona retroalimentación en tiempo de ejecución, como por ejemplo a qué ramas del código llegó una entrada. | El valor predeterminado para motores modernos como AFL++ y libFuzzer. |
Una segunda división, más antigua, separa fuzzing tonto desde Fuzzing inteligenteUn fuzzer básico manipula los bits sin tener idea del formato de entrada, por lo que la mayor parte de sus datos son rechazados por el primer analizador sintáctico que encuentra. Un fuzzer inteligente comprende las sumas de verificación, los campos de longitud y la estructura del mensaje, por lo que sus entradas superan la validación y llegan a la lógica subyacente. Fuzzing guiado por cobertura Es el refinamiento de la caja gris lo que hizo que el fuzzing se popularizara: el motor instrumenta el binario, conserva cualquier entrada que llegue a una nueva rama y muta los supervivientes, de modo que el corpus evoluciona constantemente hacia código inexplorado en lugar de reiniciarse desde ruido aleatorio.
Cómo hacer pruebas difusas
Los pasos para realizar pruebas de fuzzing incluyen los pasos básicos de prueba:
Paso 1) Identificar el sistema objetivo — Elija el binario, la biblioteca, el servicio o el punto final del protocolo que se atacará y confirme que tiene permiso para probarlo.
Paso 2) Identificar las entradas — enumera todos los puntos de entrada desde los que lee el objetivo: archivos, argumentos de línea de comandos, variables de entorno, paquetes de red, campos de formulario y cargas útiles de API.
Paso 3) Generar datos difusos — producir entradas mal formadas mutando muestras válidas, generándolas a partir de un modelo del formato o combinando ambos métodos.
Paso 4) Ejecutar la prueba utilizando datos difusos — Ejecutar el programa objetivo con los datos de entrada generados, idealmente en un bucle que reinicie el proceso automáticamente después de cada fallo.
Paso 5) Monitorear el comportamiento del sistema — Presta atención a los fallos, bloqueos, errores de aserción, uso excesivo de memoria e informes del analizador, en lugar de limitarte a comprobar la salida impresa.
Paso 6) Registrar defectos — guarda la entrada exacta que desencadenó cada fallo, redúcela al caso reproducible más pequeño y archívala con la pila. trace adjunto.
Ejemplos de fuzzers
Los fuzzers también se clasifican según cómo construyen su entrada, y los tres enfoques que se describen a continuación son los que encontrará con mayor frecuencia.
- Fuzzers basados en mutaciones Modificar muestras de datos existentes para crear nuevos datos de prueba. Este es un método muy simple y directo: comienza con muestras válidas de un protocolo y va alterando cada byte o archivo.
- Fuzzers basados en generación definen nuevos datos basándose en la entrada del modelo. Comienzan a generar la entrada desde cero basándose en la especificación.
- Fuzzers basados en protocolos Dependen de un conocimiento detallado del formato del protocolo que se está probando, y esa comprensión proviene de la especificación. Implica escribir una matriz de la especificación en la herramienta y luego usar una técnica de generación de pruebas basada en modelos para recorrer la especificación y agregar irregularidades en el contenido de los datos, la secuencia, etc. Esto también se conoce como prueba de sintaxis, prueba de gramática o prueba de robustez. Un fuzzer puede generar casos de prueba a partir de uno existente, o puede usar entradas válidas o inválidas.
Existen dos limitaciones de la fuzzing basada en protocolos:
- Las pruebas no pueden continuar hasta que la especificación esté madura.
- Muchos protocolos útiles son una extensión de los protocolos publicados. Si las pruebas fuzz se basan en especificaciones publicadas, Cobertura de prueba para nuevos protocolos será limitado.
La técnica de fuzzing más sencilla consiste en enviar datos aleatorios al software, ya sea como paquetes de protocolo o como eventos. Esta técnica es muy eficaz para detectar errores en numerosas aplicaciones y servicios. Existen otras técnicas, muy fáciles de implementar. Para implementarlas, basta con modificar las entradas existentes, simplemente intercambiando sus bits.
Tipos de errores detectados por Fuzz Testing
Dado que las pruebas de fuzzing evalúan una ejecución en función del comportamiento del programa y no de un valor esperado, los defectos que detecta se agrupan en tres familias.
- Fallos de aserción y fugas de memoria: Esta metodología se utiliza ampliamente en aplicaciones de gran tamaño donde los errores afectan a la seguridad de la memoria, lo que constituye una vulnerabilidad grave. Buffer Aquí aparecen los desbordamientos, el uso de memoria liberada y las lecturas fuera de límites.
- Entrada no válida: En las pruebas de fuzzing, los fuzzers se utilizan para generar entradas no válidas que se utilizan para probar rutinas de manejo de errores, y esto es importante para el software que no controla su entrada. El fuzzing simple puede verse como una forma de automatizar prueba negativa.
- Errores de corrección: Las pruebas de fuzzing también pueden utilizarse para detectar ciertos tipos de errores de "corrección", como una base de datos corrupta o resultados de búsqueda deficientes. El fuzzing diferencial, que consiste en introducir la misma entrada en dos implementaciones y comparar las respuestas, es la forma habitual de detectarlos.
Herramientas de prueba de fuzz
Las herramientas que se utilizan en la seguridad web se pueden utilizar ampliamente en las pruebas de fuzzing, como por ejemplo: Burp Suite y Peach Fuzzer. Varios de los nombres clásicos que aparecen a continuación están archivados, por lo que su estado actual se indica junto a cada entrada.
- Melocotón Fuzzer: Peach Fuzzer proporciona una cobertura de seguridad más robusta que un escáner. Otras herramientas de prueba solo pueden buscar amenazas conocidas, mientras que Peach Fuzzer permite a los usuarios encontrar amenazas conocidas y desconocidas. Peach Tech fue adquirida por GitLab, y Community Edition v3 ya no recibe mantenimiento; el sucesor con mantenimiento es el GitLab Protocol Fuzzer Edición Comunitaria.
- Proxy de pico: una herramienta de nivel profesional que busca vulnerabilidades a nivel de aplicación en aplicaciones web. SPIKE Proxy cubre los aspectos básicos, como: SQL Inyección y secuencias de comandos entre sitios, en un entorno completamente abierto. Python infraestructura, y estaba disponible para Linux y WindowsNo se le ha dado mantenimiento durante muchos años y se incluye aquí a modo de contexto histórico.
- Escarabajo web: WebScarab está escrito en Java Por lo tanto, es compatible con múltiples plataformas. El framework WebScarab se comunica mediante los protocolos HTTP y HTTPS y funciona como un proxy interceptor: permite al operador revisar y modificar las solicitudes creadas por el navegador antes de que el servidor las reciba, así como revisar y actualizar las respuestas generadas por el servidor antes de que el navegador las reciba. Cualquier vulnerabilidad que WebScarab detecte se añade a su lista de problemas reportados. El repositorio se archivó en abril de 2024 y actualmente es de solo lectura.
- Fusible OWASP WSFuzzer: WSFuzzer es un programa con licencia GPL escrito en Python que se dirigía a los servicios web y en su última versión basada en HTTP. Servicios SOAP eran el objetivo principal. Se lanzó como parte de WebScarab y se retiró con él; OWASP ZAP y su complemento Fuzzer son el reemplazo recomendado.
- Alternativas mantenidas: AFL++ y libFuzzer son los motores estándar de cobertura guiada para código nativo, OSS-Fuzz Los ejecuta de forma continua y gratuita para proyectos de código abierto, y boofuzz cubre el fuzzing de protocolos de red en Python. Una lista más amplia se recoge en la guía de herramientas de prueba de seguridad.
Mejores prácticas de pruebas fuzz
Un fuzzer que apunta a un objetivo y se deja solo rara vez encuentra algo útil. Las prácticas que se describen a continuación distinguen una campaña que genera defectos registrados de una que solo consume tiempo de CPU.
- Comience con un buen corpus semilla. Recopila datos de entrada reales y válidos que la aplicación ya acepta. Modificar un archivo auténtico permite acceder al código de análisis mucho más rápido que modificar bytes aleatorios.
- Escribe un arnés pequeño y rápido. El punto de entrada debe realizar una sola acción por ejecución, evitar llamadas de red y escrituras en disco, y devolver un resultado rápidamente, ya que el rendimiento se mide en ejecuciones por segundo.
- Enciende los desinfectantes. La corrupción silenciosa de la memoria a menudo no provoca un fallo del sistema. AddressSanitizer y UndefinedBehaviorSanitizer la convierten en un fallo inmediato y diagnosticable.
- Corre mucho y corre sin parar. Una ejecución de una o dos horas detecta errores superficiales; los problemas más complejos suelen requerir muchas horas, por lo que las pruebas de fuzzing deben realizarse en un proceso de integración continua nocturno en lugar de una sesión manual.
- Minimiza y elimina los duplicados de cada fallo. Reduzca la entrada que falla a su forma más pequeña y agrupe los fallos por pila. trace, de lo contrario, un error se convierte en cientos de tickets.
- Mantén un corpus de regresión. Agregue cada entrada que reproduce el problema a un conjunto permanente que se ejecuta en cada compilación, de modo que un defecto corregido no pueda volver a aparecer sin previo aviso.
- Delimite el alcance del objetivo legalmente. Realizar pruebas de fuzzing en un servicio de terceros en funcionamiento sin permiso por escrito es indistinguible de un ataque.
Ventajas de las pruebas fuzz
Utilizada con expectativas realistas, la técnica de fuzzing añade un valor que otras técnicas no logran igualar.
- Las pruebas de fuzzing mejoran las pruebas de seguridad del software.
- Los errores detectados en las pruebas de fuzzing a veces son graves y suelen ser los mismos que utilizan los atacantes, incluyendo fallos del sistema, fugas de memoria y excepciones no controladas.
- Si algún error no es detectado por los evaluadores debido a limitaciones de tiempo y recursos, esos errores también se encuentran en las pruebas de fuzzing.
- Los datos de entrada son generados por una máquina, por lo que la cobertura sigue creciendo durante la noche sin necesidad de esfuerzo manual adicional.
Desventajas de las pruebas Fuzz
Las mismas propiedades que hacen que el fuzzing sea barato también limitan lo que puede demostrar.
- Las pruebas de fuzzing por sí solas no pueden proporcionar una imagen completa de una amenaza de seguridad general o de un conjunto de errores.
- Las pruebas de fuzzing son menos efectivas para hacer frente a las amenazas de seguridad que no provocan fallos en los programas, como algunos virus, gusanos y troyanos.
- Las pruebas de fuzzing solo pueden detectar fallos o amenazas relativamente simples y no razonan sobre la lógica empresarial.
- Para funcionar eficazmente, requiere un tiempo de máquina considerable.
- Establecer una condición de valor límite con entradas aleatorias es muy problemático, aunque los evaluadores ahora resuelven gran parte de esto con algoritmos deterministas basados en las entradas del usuario.
Pruebas de fuzzing frente a pruebas de penetración
Ambas actividades buscan fallos de seguridad, pero responden a preguntas diferentes y rara vez son intercambiables.
| Criterios | Prueba de fuzz | Pruebas de penetración |
| Accionada por | Un motor automatizado que genera una entrada mal formada | Un probador experto razonando sobre el sistema |
| Busca | Bloqueos, cuelgues y fallos de seguridad de memoria. | Debilidades explotables, incluyendo fallos de lógica y configuración. |
| Profundidad | Cobertura de entrada muy amplia, razonamiento superficial. | Cobertura limitada, razonamiento profundo |
| Resultado | Reproducción de entradas y pila traces | Un informe de resultados con rutas de explotación y calificaciones de riesgo. |
| Mejores momentos | De forma continua, en la canalización de compilación | Periódicamente, contra un candidato a lanzamiento |
En la práctica, ambos procesos se retroalimentan: las pruebas de fuzzing eliminan los fallos fáciles de automatizar, de modo que las limitadas horas de un probador se dediquen a detectar los fallos que solo un ser humano podría identificar.
