
บทช่วยสอน Hadoop Pig: Apache Pig คืออะไร Archiการสอน, ตัวอย่าง
 ปราฟูลลา รานาไดฟ์
⚡ สรุปอย่างชาญฉลาด
Apache Pig เป็นแพลตฟอร์มระดับสูงสำหรับการวิเคราะห์ชุดข้อมูลขนาดใหญ่บน Hadoop โดยผสานภาษาการไหลของข้อมูล Pig Latin เข้ากับรันไทม์ที่คอมไพล์สคริปต์แต่ละตัวเป็น MapReduce, Tez หรือ Spark งานต่างๆ โดยอัตโนมัติ
บทแนะนำนี้เริ่มต้นด้วยแนวคิดเบื้องหลัง Apache Pig จากนั้นจะอธิบายขั้นตอนการติดตั้งและการเรียกใช้สคริปต์ Pig Latin ตั้งแต่ต้นจนจบ
อาปาเช่หมูคืออะไร?
หมูเป็นสัตว์ระดับสูง ภาษาโปรแกรม มีประโยชน์สำหรับการวิเคราะห์ชุดข้อมูลขนาดใหญ่ Pig เป็นผลมาจากการพัฒนาของ Yahoo!
ในเฟรมเวิร์ก MapReduce โปรแกรมจำเป็นต้องถูกแปลงเป็นขั้นตอน Map และ Reduce หลายขั้นตอน อย่างไรก็ตาม นี่ไม่ใช่รูปแบบการเขียนโปรแกรมที่นักวิเคราะห์ข้อมูลคุ้นเคย ดังนั้น เพื่อเชื่อมช่องว่างนี้ จึงจำเป็นต้องใช้ abstracสิ่งก่อสร้างที่เรียกว่า Pig ถูกสร้างขึ้นบนยอดของ Hadoop.
Apache Pig ช่วยให้ผู้คนสามารถมุ่งเน้นไปที่การวิเคราะห์ชุดข้อมูลขนาดใหญ่ได้มากขึ้น และใช้เวลาน้อยลงในการเขียนโปรแกรม MapReduce เช่นเดียวกับหมูที่กินได้ทุกอย่าง ภาษาโปรแกรม Apache Pig ถูกออกแบบมาให้ทำงานกับข้อมูลทุกประเภท นั่นคือเหตุผลที่ชื่อว่า Pig! มาสคอตของโครงการด้านล่างก็สื่อความหมายเดียวกันนี้

โครงการนี้ยังคงดำเนินอยู่ Apache Pig 0.18.0 เปิดตัวเมื่อวันที่ 15 กันยายน 2025 และเพิ่มการรองรับ Hadoop 3, Tez 0.10, Hive 3 Spark 3, HBase 2 และ Python ตามข้อมูลของ 3 หน้าดาวน์โหลด Apache Pigคำแนะนำด้านล่างนี้เขียนขึ้นโดยอ้างอิงจากเวอร์ชัน 0.12.1 ซึ่งเก่ากว่ามาก ดังนั้นบางขั้นตอนจึงมีหมายเหตุเพิ่มเติม เนื่องจากเวอร์ชันปัจจุบันมีพฤติกรรมที่แตกต่างออกไป
หมู Archiเทคเจอร์
โครงสร้างของ Pig ประกอบด้วยสองส่วน:
- หมูละติน ซึ่งเป็นภาษา
- สภาพแวดล้อมรันไทม์ สำหรับใช้ในการดำเนินโปรแกรม Pig Latin
โปรแกรม Pig Latin ประกอบด้วยชุดของการดำเนินการหรือการแปลงข้อมูล ซึ่งนำไปใช้กับข้อมูลขาเข้าเพื่อสร้างข้อมูลขาออก การดำเนินการเหล่านี้อธิบายถึงการไหลของข้อมูล ซึ่งจะถูกแปลงเป็นรูปแบบที่สามารถเรียกใช้งานได้โดยสภาพแวดล้อมการทำงานของ Hadoop Pig โดยพื้นฐานแล้ว ผลลัพธ์ของการแปลงเหล่านี้คือชุดของ... แผนที่ลด งานบางอย่างที่โปรแกรมเมอร์ไม่รู้ตัว ดังนั้น ในแง่หนึ่ง Pig ใน Hadoop ช่วยให้โปรแกรมเมอร์สามารถมุ่งเน้นไปที่ข้อมูลมากกว่าลักษณะการทำงานของโปรแกรม
ภาษา Pig Latin เป็นภาษาที่มีโครงสร้างค่อนข้างตายตัว โดยใช้คำหลักที่คุ้นเคยจากการประมวลผลข้อมูล เช่น Join, Group และ Filter ดังแสดงในแผนภาพด้านล่าง tracคือสคริปต์จากเชลล์ Grunt ผ่านตัวแยกวิเคราะห์ ตัวปรับแต่งประสิทธิภาพ และตัวคอมไพเลอร์ ก่อนที่จะถึงกลไกการประมวลผล

โหมดการดำเนินการ
Pig ใน Hadoop มีโหมดการทำงานสองโหมด และขั้นตอนการติดตั้งด้านล่างนี้จะใช้ทั้งสองโหมด:
- โหมดโลคอล: ในโหมดนี้ ภาษา Hadoop Pig จะทำงานในโหมดเดียว JVM และใช้ระบบไฟล์ในเครื่อง โหมดนี้เหมาะสำหรับการวิเคราะห์ชุดข้อมูลขนาดเล็กโดยใช้ Pig ใน Hadoop เท่านั้น
- โหมด MapReduce: ในโหมดนี้ คำสั่งค้นหาที่เขียนด้วย Pig Latin จะถูกแปลงเป็นงาน MapReduce และรันบนคลัสเตอร์ Hadoop (คลัสเตอร์อาจเป็นแบบกึ่งกระจายหรือแบบกระจายอย่างสมบูรณ์) โหมด MapReduce กับคลัสเตอร์แบบกระจายอย่างสมบูรณ์มีประโยชน์สำหรับการรัน Pig บนชุดข้อมูลขนาดใหญ่
สองอย่างนั้นเป็นคู่คลาสสิก เวอร์ชันปัจจุบันมีประเภทการดำเนินการหรือ exectypes ให้เลือกถึงหกแบบ โดยแต่ละแบบสามารถเลือกได้ด้วยวิธีเดียวกัน -x ธง ตามที่บันทึกไว้ใน คู่มือเริ่มต้นใช้งาน Pig เวอร์ชัน 0.18.0.
| ประเภทการดำเนินการ | คำสั่ง | สถานที่ที่งานดำเนินไป |
|---|---|---|
| องถิ่น | หมู -x ท้องถิ่น | JVM เดียวที่ใช้งานกับระบบไฟล์ในเครื่อง |
| เทซ โลคอล | pig -x tez_local | JVM เดียวที่ใช้รันไทม์ Tez (ทดลอง) |
| Spark ในประเทศ | pig -x spark_local | JVM เดียวที่ใช้ Spark ระยะเวลาการทำงาน (ทดลอง) |
| แผนที่ลด | pig หรือ pig -x mapreduce | คลัสเตอร์ Hadoop ที่ใช้ HDFS; นี่คือค่าเริ่มต้น |
| Tez | หมู -x tez | คลัสเตอร์ Hadoop ที่ทำงานบนเอนจิน Tez |
| Spark | หมู -x ประกายไฟ | A Sparkคลัสเตอร์ YARN หรือ Mesos ที่ใช้ HDFS |
ประเภทข้อมูล Pig Latin และ Operaโปร
ก่อนที่จะเขียนสคริปต์ สิ่งสำคัญคือต้องรู้ว่า Pig สามารถเก็บข้อมูลอะไรได้บ้างและทำอะไรกับข้อมูลเหล่านั้นได้บ้าง โมเดลข้อมูลของ Pig เป็นแบบซ้อนกันอย่างสมบูรณ์ ซึ่งเป็นสิ่งที่ทำให้ Pig สามารถอ่านไฟล์บันทึกและข้อมูลป้อนเข้าที่มีโครงสร้างหลวมๆ อื่นๆ ที่ตารางเชิงสัมพันธ์ไม่สามารถทำได้
ภาษา Pig Latin แบ่งออกเป็นสองกลุ่มหลัก:
- ประเภทสเกลาร์:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerและbigdecimalตัวอย่างสคริปต์ในภายหลังจะประกาศคอลัมน์ทุกคอลัมน์เป็นchararray. - ประเภทที่ซับซ้อน: a ทูเพิล เป็นชุดของฟิลด์ที่เรียงลำดับและมีลักษณะการทำงานเหมือนแถว; ถุง เป็นชุดของทูเปิลที่ไม่มีลำดับ และมีลักษณะการทำงานเหมือนตาราง แผนที่ คือชุดของคู่คีย์และค่า โดยที่คีย์จะต้องเป็น
chararray.
พนักงานฝ่ายปฏิบัติการมีหน้าที่รับผิดชอบงานเพียงไม่กี่อย่าง และมีคนเพียงไม่กี่คนเท่านั้นที่รับผิดชอบงานท่อส่งเกือบทั้งหมด:
| OperaTor | สิ่งที่มันไม่ |
|---|---|
| โหลด / จัดเก็บ | อ่านความสัมพันธ์จากระบบไฟล์และเขียนผลลัพธ์กลับเข้าไป |
| FILTER | เก็บเฉพาะทูเปิลที่ตรงตามเงื่อนไขเท่านั้น |
| สำหรับแต่ละ... สร้าง | ทำงานทีละคอลัมน์ สร้างฟิลด์ใหม่ |
| กลุ่ม / กลุ่มร่วม | จัดกลุ่มความสัมพันธ์หนึ่งรายการ หรือความสัมพันธ์สองรายการขึ้นไป โดยใช้กุญแจกำหนด |
| สมัคร | รวมความสัมพันธ์โดยใช้การเชื่อมต่อภายในหรือภายนอก |
| สหภาพ / สปลิต | รวมความสัมพันธ์เข้าด้วยกัน หรือแบ่งความสัมพันธ์หนึ่งออกเป็นหลายส่วน |
| เรียงลำดับตาม / ที่ไม่ซ้ำกัน / จำกัด | จัดเรียง ลบข้อมูลซ้ำ และจำกัดจำนวนทูเปิล |
| ดัมพ์ / อธิบาย / ชี้แจง / ยกตัวอย่าง | ตรวจสอบผลลัพธ์ โครงสร้างข้อมูล แผนการดำเนินการ และตัวอย่างการทำงาน |
พนักงานตรวจสอบทั้งสี่คนมีทางลัดของ Grunt เช่นกัน ซึ่งช่วยประหยัดเวลาได้มากping ระหว่างการดีบัก: \d สำหรับ DUMP, \de สำหรับคำอธิบาย (DESCRIBE) \e เพื่ออธิบายและ \i เพื่อประกอบการอธิบาย
เบื้องต้น
Pig เป็นเครื่องมือฝั่งไคลเอ็นต์ มันวิเคราะห์สคริปต์ วางแผนการทำงาน และส่งงาน แต่ไม่ได้ให้พื้นที่จัดเก็บข้อมูลหรือคลัสเตอร์ของตัวเอง ดังนั้นจึงต้องมีการติดตั้ง Hadoop ที่ใช้งานได้ก่อน ส่วนข้อกำหนดของ Apache นั้นสั้นมาก
| ตัวแทน | ความต้องการ | ทำไมจึงจำเป็นต้องใช้ |
|---|---|---|
| Hadoop | Hadoop เวอร์ชัน 2.x หรือ 3.x โดยต้องส่งออกค่า HADOOP_HOME ด้วย | จัดเตรียม HDFS และเอนจินการประมวลผล หากไม่มี HADOOP_HOME, Pig 0.18.0 จะเปลี่ยนไปใช้ Hadoop 2.7.3 แบบฝังตัวแทน |
| Java | Java เวอร์ชัน 1.7 หรือใหม่กว่า โดยตั้งค่า JAVA_HOME ให้เป็นไดเร็กทอรีการติดตั้งหลัก | Pig และ Hadoop daemons คือ Java โปรแกรม |
| Python (ถ้ามี) | Python 2.7 | จำเป็นสำหรับการสตรีมมิ่งเท่านั้น Python ฟังก์ชันที่ผู้ใช้กำหนด |
| มด (ไม่จำเป็น) | มด 1.8 | จำเป็นเฉพาะเมื่อทำการสร้างหรือคอมไพล์ Pig ใหม่จากซอร์สโค้ดเท่านั้น |
นอกจากรายการดังกล่าวแล้ว ยังมีประเด็นสำคัญอีกสองข้อที่ควรพิจารณา ข้อแรกคือ ให้รันทุกอย่างในฐานะผู้ใช้ Linux ที่มีไดเร็กทอรีโฮมอยู่แล้ว เอชดีเอฟเอส และได้รับอนุญาตให้เขียนลงในนั้น บทช่วยสอนนี้ใช้ hduserบัญชีที่สร้างขึ้นระหว่างการติดตั้ง Hadoop ประการที่สอง เริ่มคลัสเตอร์ก่อนที่จะเรียกใช้ Pig ในโหมด MapReduce เนื่องจาก Pig จะล้มเหลวทันทีหาก NameNode และ ResourceManager หยุดทำงาน หากยังไม่ได้ติดตั้ง Hadoop ให้ทำตามขั้นตอนต่อไปนี้ วิธีการติดตั้ง Hadoop ก่อน
วิธีดาวน์โหลดและติดตั้ง Pig
ในบทช่วยสอน Apache Pig นี้ เราจะได้เรียนรู้วิธีดาวน์โหลดและติดตั้ง Pig:
ก่อนที่เราจะเริ่มกระบวนการจริง โปรดตรวจสอบให้แน่ใจว่าคุณได้ติดตั้ง Hadoop แล้ว เปลี่ยนชื่อผู้ใช้เป็น 'hduser' (รหัสผู้ใช้ที่ใช้ในการกำหนดค่า Hadoop คุณสามารถเปลี่ยนไปใช้รหัสผู้ใช้ที่คุณใช้ในการกำหนดค่า Hadoop ของคุณเองได้)

ขั้นตอน 1) ดาวน์โหลด Pig Hadoop เวอร์ชันล่าสุดที่เสถียรได้จากเว็บไซต์สำรองใดก็ได้ที่มีให้เลือก
https://pig.apache.org/releases.html
เลือกไฟล์ tar.gz (ไม่ใช่ src.tar.gz) เพื่อดาวน์โหลด ตามที่แสดงด้านล่าง

ขั้นตอน 2) เมื่อดาวน์โหลดเสร็จแล้ว ให้เข้าไปยังไดเร็กทอรีที่มีไฟล์ tar ที่ดาวน์โหลดมา และย้ายไฟล์ tar ไปยังตำแหน่งที่คุณต้องการติดตั้ง Pig Hadoop ในกรณีนี้ เราจะย้ายไปที่ /usr/local

ย้ายไปยังไดเร็กทอรีที่จะเก็บไฟล์ Pig Hadoop
cd /usr/local
Extracเนื้อหาของไฟล์ tar มีดังต่อไปนี้
sudo tar -xvf pig-0.12.1.tar.gz

ขั้นตอน 3) แก้ไขไฟล์ ~/.bashrc เพื่อเพิ่มตัวแปรสภาพแวดล้อมที่เกี่ยวข้องกับ Pig
เปิดไฟล์ ~/.bashrc ด้วยโปรแกรมแก้ไขข้อความใดก็ได้ที่คุณเลือก และทำการแก้ไขตามด้านล่างนี้
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

ขั้นตอน 4) ตอนนี้ ให้เรียกใช้การกำหนดค่าสภาพแวดล้อมนี้โดยใช้คำสั่งด้านล่าง
. ~/.bashrc

ขั้นตอน 5) เราจำเป็นต้องคอมไพล์ Pig ใหม่เพื่อให้รองรับ Hadoop เวอร์ชัน 2.2.0
ต่อไปนี้คือขั้นตอนในการดำเนินการดังกล่าว
ไปที่หน้าหลักของ Pig
cd $PIG_HOME
ติดตั้ง Ant.
sudo apt-get install ant

หมายเหตุ: การดาวน์โหลดจะเริ่มต้นและจะใช้เวลาตามความเร็วอินเทอร์เน็ตของคุณ
คอมไพล์ Pig ใหม่
sudo ant clean jar-all -Dhadoopversion=23

โปรดทราบว่าในขั้นตอนการคอมไพล์ใหม่นี้ จะมีการดาวน์โหลดส่วนประกอบหลายอย่าง ดังนั้นระบบควรเชื่อมต่อกับอินเทอร์เน็ต
นอกจากนี้ หากกระบวนการนี้ติดขัดตรงไหน และคุณไม่เห็นความเคลื่อนไหวใดๆ บนหน้าต่างคำสั่งนานกว่า 20 นาที ให้กด Ctrl + c แล้วเรียกใช้คำสั่งเดิมอีกครั้ง
ในกรณีของเรา ใช้เวลา 20 นาที

ขั้นตอนการคอมไพล์ใหม่นี้เป็นส่วนหนึ่งของยุค 0.12.1 ซึ่งไฟล์ jar ที่จัดส่งนั้นสร้างขึ้นโดยใช้ Hadoop 1 และ -Dhadoopversion=23 แฟล็กดังกล่าวเปลี่ยนการสร้าง Ant ไปใช้ Hadoop เวอร์ชัน 0.23 และ 2.x Apache Pig เวอร์ชัน 0.18.0 มาพร้อมกับไบนารีที่สามารถทำงานได้บน Hadoop 2.7 ขึ้นไป รวมถึง Hadoop 3 ด้วย ดังนั้นในเวอร์ชันปัจจุบัน คุณสามารถแตกไฟล์ tarball และข้ามไปทำการทดสอบด้านล่างได้เลย
ขั้นตอน 6) ทดสอบการติดตั้ง Pig โดยใช้คำสั่ง
pig -help

ตัวอย่างสคริปต์หมู
เมื่อติดตั้ง Pig เสร็จแล้ว ส่วนที่เหลือของบทช่วยสอน Apache Pig นี้จะรันสคริปต์ทั้งหมด เราจะใช้สคริปต์ Pig เพื่อค้นหาจำนวนสินค้าที่ขายได้ในแต่ละประเทศ
ข้อมูลนำเข้า: ชุดข้อมูลนำเข้าของเราเป็นไฟล์ CSV ยอดขายมกราคม 2009.csv.
ขั้นตอน 1) เริ่มต้นใช้งาน Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
ขั้นตอน 2) Pig ใน Big Data ดึงไฟล์จาก HDFS ในโหมด MapReduce และจัดเก็บผลลัพธ์กลับไปยัง HDFS
คัดลอกไฟล์ SalesJan2009.csv (ซึ่งจัดเก็บไว้ในระบบไฟล์ภายในเครื่องที่ ~/input/SalesJan2009.csv) ไปยังไดเร็กทอรีหลักของ HDFS (Hadoop Distributed File System)
ในตัวอย่างของ Apache Pig นี้ ไฟล์อยู่ในโฟลเดอร์ input หากไฟล์ถูกเก็บไว้ในตำแหน่งอื่น ให้ระบุชื่อตำแหน่งนั้นแทน
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

ตรวจสอบว่าไฟล์ถูกคัดลอกสำเร็จหรือไม่
$HADOOP_HOME/bin/hdfs dfs -ls /

ขั้นตอน 3) การกำหนดค่าหมู
ขั้นแรก ให้เข้าไปที่ $PIG_HOME/conf และคัดลอกไฟล์คุณสมบัติเดิมเก็บไว้
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

เปิดไฟล์ pig.properties โดยใช้โปรแกรมแก้ไขข้อความที่คุณเลือก และระบุเส้นทางของไฟล์บันทึกโดยใช้ pig.logfile
sudo gedit pig.properties

โปรแกรมบันทึกข้อมูลจะใช้ไฟล์นี้ในการบันทึกข้อผิดพลาด
ขั้นตอน 4) เรียกใช้คำสั่ง 'pig' ซึ่งจะเปิดพรอมต์คำสั่ง Pig ซึ่งเป็นเชลล์แบบโต้ตอบสำหรับการสอบถามข้อมูลด้วย Pig
pig

ขั้นตอน 5) ในหน้าต่าง Command Prompt ของ Grunt สำหรับ Pig ให้รันคำสั่ง Pig ด้านล่างตามลำดับ
— A. โหลดไฟล์ที่มีข้อมูล
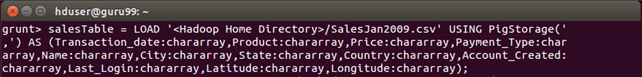
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
กด Enter หลังจากคำสั่งนี้
— ข. จัดกลุ่มข้อมูลตามฟิลด์ ประเทศ
GroupByCountry = GROUP salesTable BY Country;

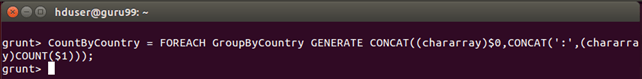
— C. สำหรับแต่ละทูเปิลใน 'GroupByCountry' ให้สร้างสตริงผลลัพธ์ในรูปแบบ ชื่อประเทศ: จำนวนสินค้าที่ขายได้
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
กด Enter หลังจากคำสั่งนี้
— D. บันทึกผลลัพธ์ของการไหลเวียนของข้อมูลลงในไดเร็กทอรี 'pig_output_sales' บน HDFS
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

คำสั่งนี้จะใช้เวลาสักครู่ในการประมวลผล เมื่อเสร็จสิ้นแล้ว คุณจะเห็นหน้าจอดังต่อไปนี้

ขั้นตอน 6) สามารถดูผลลัพธ์ได้ผ่านทางอินเทอร์เฟซคำสั่งดังนี้
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

สามารถดูผลลัพธ์ผ่านทางเว็บอินเตอร์เฟสได้เช่นกัน
เปิด http://localhost:50070/ ในเว็บเบราว์เซอร์
พอร์ต 50070 คือเว็บ UI ของ NameNode บน Hadoop 2 Hadoop 3 ได้ย้ายหน้าเว็บเดียวกันนี้ไปที่พอร์ต 9870 ดังนั้นหากคลัสเตอร์ของคุณใช้ Hadoop 3 ให้ใช้ที่อยู่ดังกล่าวแทน

จากนั้นเลือก 'เรียกดูระบบไฟล์' และไปยังไดเร็กทอรี /user/hduser/pig_output_sales

เปิดไฟล์ part-r-00000 เพื่ออ่านข้อมูลคู่ประเทศและจำนวนสินค้าที่สคริปต์สร้างขึ้น

Apache Pig เทียบกับ Hive เทียบกับ MapReduce
โดยปกติแล้ว การประเมินผลงานโดยใช้เกณฑ์ Pig เพียงอย่างเดียวมักไม่ค่อยเกิดขึ้น คำถามที่ถามกันทั่วไปคือ งานนั้นควรอยู่ในเกณฑ์ Pig หรือไม่ รัง หรือเขียนโปรแกรม MapReduce ด้วยมือก็ได้ เพราะสุดท้ายแล้วทั้งสามแบบก็จะเป็นงานบนคลัสเตอร์เดียวกัน
| แง่มุม | แมปรีดิวซ์ (Java) | อาปาเช่หมู | อาปาเช่ไฮฟ์ |
|---|---|---|---|
| อินเตอร์เฟซ | Java API | Pig Latin ภาษาเขียนสคริปต์การไหลของข้อมูล | ไฮฟ์คิวแอลภาษาถิ่นของ SQL |
| ระดับของ abstracการ | ต่ำ | กลาง | จุดสูง |
| ผู้ใช้ทั่วไป | Java ผู้พัฒนา | วิศวกรข้อมูลหรือนักวิจัย | นักวิเคราะห์ที่เชี่ยวชาญด้าน SQL |
| ข้อมูลที่เหมาะสม | ทุกสิ่งทุกอย่างที่จัดการด้วยมือ | มีทั้งแบบมีโครงสร้างและกึ่งมีโครงสร้าง โดยสามารถเลือกใช้โครงสร้างข้อมูลได้ในขณะโหลดข้อมูล | ตารางที่มีโครงสร้างซึ่งลงทะเบียนไว้ในเมตาสโตร์ |
| Code ปริมาณ | เส้นส่วนใหญ่ | จำนวนแถวน้อยลง | จำนวนบรรทัดน้อยที่สุดสำหรับคำสั่งค้นหา |
| ดำเนินการเป็น | งาน MapReduce | คอมไพล์เป็น MapReduce, Tez หรือ Spark ตำแหน่งงาน | คอมไพล์เป็น MapReduce, Tez หรือ Spark ตำแหน่งงาน |
| ดีที่สุดที่ | ควบคุมได้อย่างเต็มที่และกำหนดตรรกะได้เอง | ไปป์ไลน์ ETL หลายขั้นตอน | การสอบถามและการรายงานแบบเฉพาะกิจ |
ในทางปฏิบัติ การแบ่งประเภทนั้นตรงไปตรงมา เลือกใช้ Hive เมื่อข้อมูลมีลักษณะเป็นตารางอยู่แล้วและคำถามมีลักษณะเป็น SQL เลือกใช้ Pig เมื่อข้อมูลนำเข้าไม่เป็นระเบียบ เมื่อไปป์ไลน์เป็นห่วงโซ่ของการแปลงข้อมูลแทนที่จะเป็นคำสั่ง SQL เดียว หรือเมื่อสคริปต์เดียวกันต้องแยกและรวมใหม่ เลือกใช้ MapReduce เฉพาะเมื่อทั้งสองอย่างไม่เหมาะสมtraction สามารถแสดงตรรกะได้ เนื่องจากจำนวนบรรทัดเพิ่มขึ้นอย่างรวดเร็ว
หมูสามารถอยู่ร่วมกับสิ่งมีชีวิตอื่นๆ ในระบบนิเวศได้อย่างกลมกลืน สควูปและฟลูม จัดเก็บข้อมูลดิบ ใช้ Pig หรือ Hive ในการปรับแต่งรูปร่าง และใช้ตัวจัดตารางเวลา เช่น อะปาเช่ อูซี่ เชื่อมโยงขั้นตอนต่างๆ เข้าด้วยกันเป็นกระบวนการทำงานที่ทำซ้ำได้ สำหรับภาพรวมที่กว้างขึ้นว่าเครื่องมือเหล่านี้เหมาะสมกับการใช้งานในด้านใดบ้าง โปรดดูคู่มือ ข้อมูลขนาดใหญ่ และการสรุปโดยรวมของ เครื่องมือข้อมูลขนาดใหญ่สำหรับทางเลือก ETL เชิงพาณิชย์แทนการเขียนสคริปต์ด้วยมือ โปรดดูที่ Talend.
