
วิธีการติดตั้ง Hadoop บน Ubuntu: ขั้นตอนการดาวน์โหลดและการติดตั้ง
 ปราฟูลลา รานาไดฟ์
⚡ สรุปอย่างชาญฉลาด
การติดตั้ง Apache Hadoop บน Ubuntu กระบวนการนี้ต้องผ่านสองขั้นตอน: แตกไฟล์ที่ดาวน์โหลดมาโดยใช้บัญชีระบบเฉพาะที่มี SSH แบบไม่ต้องใช้รหัสผ่าน จากนั้นแก้ไขไฟล์ XML สี่ไฟล์ก่อนที่จะฟอร์แมต HDFS และเริ่มต้นคลัสเตอร์แบบโหนดเดียว
ในบทช่วยสอนนี้ เราจะพาคุณไปทีละขั้นตอนในการติดตั้ง Apache Hadoop บนระบบ Linux (Ubuntuกระบวนการนี้ประกอบด้วยสองส่วน: ขั้นแรกคือดาวน์โหลดและติดตั้งเวอร์ชันใหม่ จากนั้นจึงทำการกำหนดค่า
มีข้อกำหนดเบื้องต้นสองประการ:
- คุณต้องมี Ubuntu การติดตั้ง และการวิ่ง
- คุณต้องมี Java การติดตั้ง.
หมายเหตุสำหรับ Hadoop เวอร์ชัน 3.x ในการตั้งค่านี้
ภาพหน้าจอในคำแนะนำนี้ถ่ายจาก Hadoop เวอร์ชัน 2.2.0 ลำดับขั้นตอนยังคงเหมือนเดิมในเวอร์ชันปัจจุบัน แต่ชื่อและค่าเริ่มต้นบางส่วนมีการเปลี่ยนแปลง โปรดตรวจสอบตารางด้านล่างก่อนคัดลอกคำสั่งใดๆ โดยตรง
| การตั้งค่าหรือขั้นตอน | ในบทช่วยสอนนี้ (Hadoop 2.x) | Hadoop 3.x เวอร์ชันปัจจุบัน |
|---|---|---|
| คลังเก็บข้อมูลการเผยแพร่ | hadoop-2.2.0.tar.gz |
hadoop-3.5.0.tar.gzเวอร์ชัน 3.5 ที่เสถียรตัวแรก เผยแพร่เมื่อวันที่ 2 เมษายน 2026 |
| คุณสมบัติระบบไฟล์เริ่มต้น | fs.default.name ในงานเขียนร้อยแก้ว fs.defaultFS ใน XML |
fs.defaultFS เท่านั้น fs.default.name เลิกใช้แล้ว |
| คุณสมบัติ MapReduce | mapreduce.jobtracker.address |
mapreduce.framework.name ตั้งค่าให้ yarnงานTracker จะไม่มีอยู่อีกต่อไปเมื่อ YARN กำหนดตารางงานแล้ว |
| mapred-site.xml | คัดลอกมาจาก mapred-site.xml.template |
เรือใน etc/hadoop มีอยู่แล้ว ดังนั้นขั้นตอนการคัดลอกจึงไม่จำเป็น |
| การพอร์ตเว็บ UI ของ NameNode | 50070 | 9870 |
| Java | Java 6 หรือ Java 7 | Java 8 หรือ Java 11 |
ส่วนอื่นๆ ในคู่มือนี้ทำงานในลักษณะเดียวกันบน Hadoop 3 ได้แก่ บัญชีเฉพาะ, คีย์ SSH, ไฟล์การกำหนดค่าทั้งสี่ไฟล์ และสคริปต์เริ่มต้นและหยุดการทำงาน
ส่วนที่ 1) ดาวน์โหลดและติดตั้ง Hadoop
ขั้นตอนที่ 1) เพิ่มผู้ใช้ระบบ Hadoop
เพิ่มผู้ใช้ระบบ Hadoop โดยใช้คำสั่งด้านล่าง
sudo addgroup hadoop_

sudo adduser --ingroup hadoop_ hduser_
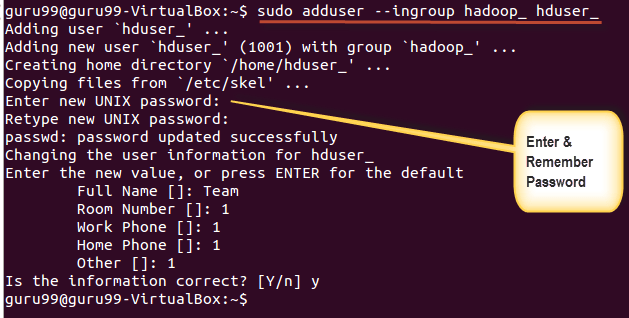
กรอกรหัสผ่าน ชื่อ และรายละเอียดอื่นๆ ของคุณ
หมายเหตุ: มีความเป็นไปได้ที่จะเกิดข้อผิดพลาดดังต่อไปนี้ในขั้นตอนการตั้งค่าและการติดตั้งนี้
“hduser ไม่ได้อยู่ในไฟล์ sudoers เหตุการณ์นี้จะถูกรายงาน”

สามารถแก้ไขข้อผิดพลาดนี้ได้โดยการเข้าสู่ระบบในฐานะผู้ใช้ root
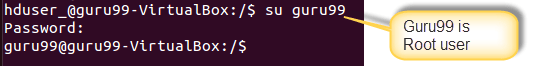
ดำเนินการคำสั่ง
sudo adduser hduser_ sudo

Re-login as hduser_

ขั้นตอนที่ 2) กำหนดค่า SSH
ในการจัดการโหนดในคลัสเตอร์ Hadoop จำเป็นต้องมีการเข้าถึงผ่าน SSH
ขั้นแรกให้สลับผู้ใช้โดยป้อนคำสั่งดังต่อไปนี้
su - hduser_

คำสั่งนี้จะสร้างคีย์ใหม่
ssh-keygen -t rsa -P ""

เปิดใช้งานการเข้าถึง SSH ไปยังเครื่องโลคัลโดยใช้คีย์นี้
cat $HOME/.ssh/id_rsa.pub >> $HOME/.ssh/authorized_keys

ตอนนี้ทดสอบการตั้งค่า SSH โดยเชื่อมต่อกับ localhost ในฐานะผู้ใช้ 'hduser_'
ssh localhost

หมายเหตุ หากคุณพบข้อผิดพลาดด้านล่างเมื่อพิมพ์ 'ssh localhost' แสดงว่าอาจเป็นไปไม่ได้ที่ SSH จะใช้งานได้ในระบบนี้

เพื่อแก้ไขปัญหานี้ –
ล้าง SSH โดยใช้
sudo apt-get purge openssh-server
ควรทำการล้างข้อมูลทั้งหมดก่อนเริ่มการติดตั้ง

ติดตั้ง SSH โดยใช้คำสั่ง-
sudo apt-get install openssh-server

ขั้นตอนที่ 3) ดาวน์โหลด Hadoop
ขั้นตอนต่อไปคือการดาวน์โหลด Hadoop จาก หน้าประกาศจำหน่าย Apache Hadoop.

เลือกเสถียร

เลือกไฟล์ tar.gz (ไม่ใช่ไฟล์ที่ลงท้ายด้วย src)

เมื่อดาวน์โหลดเสร็จแล้ว ให้เข้าไปในโฟลเดอร์ที่มีไฟล์ tar อยู่

ป้อน
sudo tar xzf hadoop-2.2.0.tar.gz

ตอนนี้ ให้เปลี่ยนชื่อ hadoop-2.2.0 เป็น hadoop
sudo mv hadoop-2.2.0 hadoop

สุดท้าย ส่งแฟ้มเอกสารให้กับบัญชีใหม่
sudo chown -R hduser_:hadoop_ hadoop

แทนที่เวอร์ชันที่คุณดาวน์โหลดจริงด้วยเวอร์ชันใหม่ hadoop-2.2.0 ในคำสั่งทั้งสามข้างต้น
ส่วนที่ 2) กำหนดค่า Hadoop
ขั้นตอนที่ 1) แก้ไขไฟล์ ~/.bashrc
เพิ่มบรรทัดต่อไปนี้ลงในท้ายไฟล์ ~/.bashrc
#Set HADOOP_HOME
export HADOOP_HOME=<Installation Directory of Hadoop>
#Set JAVA_HOME
export JAVA_HOME=<Installation Directory of Java>
# Add bin/ directory of Hadoop to PATH
export PATH=$PATH:$HADOOP_HOME/bin
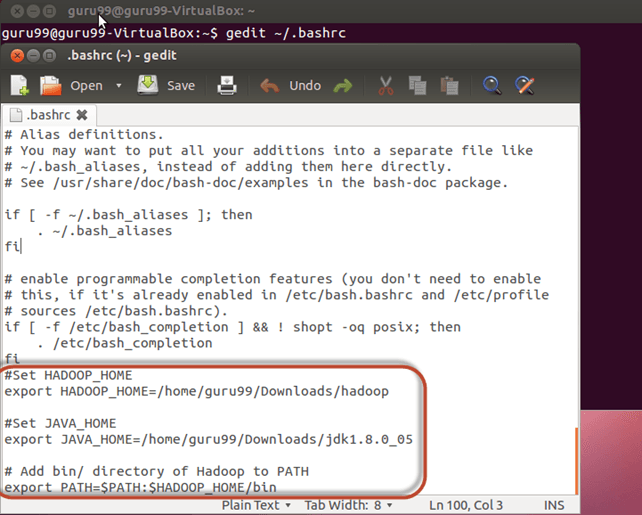
ตอนนี้ ให้เรียกใช้การกำหนดค่าสภาพแวดล้อมนี้โดยใช้คำสั่งด้านล่าง
. ~/.bashrc

ขั้นตอนที่ 2) การกำหนดค่าที่เกี่ยวข้องกับ HDFS
ตั้งค่า JAVA_HOME ภายในไฟล์ $HADOOP_HOME/etc/hadoop/hadoop-env.sh ดังที่แสดงด้านล่าง


ด้วยระบบเส้นทาง

มีพารามิเตอร์สองตัวในไฟล์ $HADOOP_HOME/etc/hadoop/core-site.xml ที่ต้องตั้งค่า
1. 'hadoop.tmp.dir' – ใช้สำหรับระบุไดเร็กทอรีที่ Hadoop จะใช้จัดเก็บไฟล์ข้อมูล
2. 'fs.defaultFS' – คุณสมบัตินี้ระบุระบบไฟล์เริ่มต้น ชื่อเดิมของคุณสมบัติเดียวกันนี้คือ 'fs.default.name' ซึ่งเลิกใช้แล้ว
หากต้องการตั้งค่าพารามิเตอร์เหล่านี้ ให้เปิด core-site.xml
sudo gedit $HADOOP_HOME/etc/hadoop/core-site.xml

คัดลอกบรรทัดด้านล่างลงในช่องว่างระหว่าง แท็ก
<property>
<name>hadoop.tmp.dir</name>
<value>/app/hadoop/tmp</value>
<description>Parent directory for other temporary directories.</description>
</property>
<property>
<name>fs.defaultFS </name>
<value>hdfs://localhost:54310</value>
<description>The name of the default file system. </description>
</property>

ไปที่ไดเร็กทอรี $HADOOP_HOME/etc/hadoop

ต่อไป ให้สร้างไดเร็กทอรีตามที่ระบุไว้ในไฟล์ core-site.xml
sudo mkdir -p <Path of Directory used in above setting>

ให้สิทธิ์การเข้าถึงไดเร็กทอรี
sudo chown -R hduser_:Hadoop_ <Path of Directory created in above step>

sudo chmod 750 <Path of Directory created in above step>

ขั้นตอนที่ 3) การกำหนดค่า MapReduce
ก่อนที่จะเริ่มการตั้งค่าเหล่านี้ เรามาตั้งค่าพาธ HADOOP_HOME กันก่อน
sudo gedit /etc/profile.d/hadoop.sh
และเข้า
export HADOOP_HOME=/home/guru99/Downloads/Hadoop

ป้อนถัดไป
sudo chmod +x /etc/profile.d/hadoop.sh

ปิดเทอร์มินัลแล้วเริ่มใหม่อีกครั้ง
พิมพ์ echo $HADOOP_HOME เพื่อตรวจสอบเส้นทาง

ตอนนี้คัดลอกไฟล์
sudo cp $HADOOP_HOME/etc/hadoop/mapred-site.xml.template $HADOOP_HOME/etc/hadoop/mapred-site.xml

เปิดไฟล์ mapred-site.xml
sudo gedit $HADOOP_HOME/etc/hadoop/mapred-site.xml

เพิ่มการตั้งค่าด้านล่างระหว่าง และ แท็ก
<property>
<name>mapreduce.jobtracker.address</name>
<value>localhost:54311</value>
<description>MapReduce job tracker runs at this host and port.
</description>
</property>

เปิดไฟล์ $HADOOP_HOME/etc/hadoop/hdfs-site.xml ตามตัวอย่างด้านล่าง
sudo gedit $HADOOP_HOME/etc/hadoop/hdfs-site.xml

เพิ่มการตั้งค่าด้านล่างระหว่าง และ แท็ก
<property>
<name>dfs.replication</name>
<value>1</value>
<description>Default block replication.</description>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/home/hduser_/hdfs</value>
</property>

สร้างไดเร็กทอรีตามที่ระบุไว้ในการตั้งค่าด้านบน
sudo mkdir -p <Path of Directory used in above setting>
sudo mkdir -p /home/hduser_/hdfs

จากนั้นให้สิทธิ์การเป็นเจ้าของและสิทธิ์การเข้าถึงแก่ไฟล์นั้น
sudo chown -R hduser_:hadoop_ <Path of Directory created in above step>
sudo chown -R hduser_:hadoop_ /home/hduser_/hdfs

sudo chmod 750 <Path of Directory created in above step>
sudo chmod 750 /home/hduser_/hdfs

ขั้นตอนที่ 4) ฟอร์แมต HDFS
ก่อนที่เราจะเริ่มต้นใช้งาน Hadoop เป็นครั้งแรก ให้ทำการฟอร์แมต HDFS โดยใช้คำสั่งด้านล่างนี้
$HADOOP_HOME/bin/hdfs namenode -format

ขั้นตอนที่ 5) เริ่มคลัสเตอร์ Hadoop แบบโหนดเดียว
เริ่มต้นคลัสเตอร์ Hadoop แบบโหนดเดียวโดยใช้คำสั่งด้านล่าง
$HADOOP_HOME/sbin/start-dfs.sh
ผลลัพธ์ของคำสั่งข้างต้นแสดงอยู่ด้านล่าง

จากนั้นเริ่มใช้งาน YARN daemons
$HADOOP_HOME/sbin/start-yarn.sh

ใช้เครื่องมือ 'jps' เพื่อตรวจสอบว่ากระบวนการที่เกี่ยวข้องกับ Hadoop ทั้งหมดทำงานอยู่หรือไม่
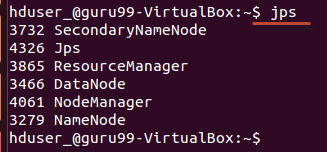
หาก Hadoop เริ่มทำงานสำเร็จ ผลลัพธ์จากคำสั่ง jps ควรแสดงรายการ NameNode, NodeManager, ResourceManager, SecondaryNameNode และ DataNode
ขั้นตอนที่ 6) หยุดping Hadoop
ปิดระบบคลัสเตอร์ตามลำดับย้อนกลับ
$HADOOP_HOME/sbin/stop-dfs.sh

$HADOOP_HOME/sbin/stop-yarn.sh

วิธีตรวจสอบว่า Hadoop ทำงานอยู่หรือไม่ และแก้ไขข้อผิดพลาดทั่วไป
คำสั่ง jps ยืนยันว่ากระบวนการต่างๆ เริ่มทำงานแล้ว แต่ไม่ได้ยืนยันว่าคลัสเตอร์สามารถใช้งานได้ ต้องมีการตรวจสอบเพิ่มเติมอีกสี่อย่างจึงจะยืนยันข้อสงสัยนั้นได้
- เปิดใช้งานเว็บอินเทอร์เฟซของ NameNode ที่
http://localhost:9870(พอร์ต 50070 บน Hadoop 2.x) และยืนยันรายงานสรุปว่ามีโหนดทำงานอยู่หนึ่งโหนด - เปิดอินเทอร์เฟซ ResourceManager ที่
http://localhost:8088เพื่อยืนยันว่า YARN ยอมรับ NodeManager แล้ว - วิ่ง
hdfs dfsadmin -reportสำหรับความจุ โหนดข้อมูลที่ใช้งานจริง และบล็อกที่มีการจำลองไม่ครบถ้วน - เขียนอะไรสักอย่าง:
hdfs dfs -mkdir /testตามมาด้วยhdfs dfs -ls /พิสูจน์ว่าเนมสเปซยอมรับการเปลี่ยนแปลงได้
ความล้มเหลวครั้งแรกส่วนใหญ่มักอยู่ใน 5 ประเภทหลักๆ ดังนี้
| อาการ | ก่อให้เกิด | แก้ไขปัญหา |
|---|---|---|
| JAVA_HOME ไม่ได้ถูกตั้งค่าและไม่สามารถค้นหาได้ | ตัวแปรนี้ถูกส่งออกในไฟล์ .bashrc แต่ไม่ได้ส่งออกในไฟล์ hadoop-env.sh | ตั้งค่าพาธแบบเต็มของ JDK ภายในไฟล์ hadoop-env.sh ด้วยเช่นกัน |
| การเข้าถึงถูกปฏิเสธ (publickey,password) บน ssh localhost | authorized_keys หายไปหรืออนุญาตมากเกินไป | เพิ่มไฟล์ id_rsa.pub กลับเข้าไปใหม่ จากนั้นรันคำสั่ง chmod 600 บน ~/.ssh/authorized_keys |
| การเชื่อมต่อถูกปฏิเสธบนพอร์ต 22 | openssh-server ไม่ได้ติดตั้งหรือไม่ได้ทำงานอยู่ | ติดตั้ง openssh-server และเริ่มต้นบริการ ssh |
| DataNode หายไปจากไฟล์ jps หลังจากทำการฟอร์แมตใหม่ | Cluster รหัสไม่ตรงกันระหว่าง NameNode ที่จัดรูปแบบแล้วกับไดเร็กทอรี DataNode เดิม | ล้างโฟลเดอร์ dfs.datanode.data.dir ให้หมด แล้วทำการฟอร์แมตอีกครั้ง |
| start-dfs.sh: ไม่พบคำสั่ง | HADOOP_HOME และ PATH ไม่เคยถูกเรียกใช้ในเชลล์ปัจจุบัน | เรียกใช้คำสั่ง . ~/.bashrc หรือเปิดเทอร์มินัลใหม่ |
