
บทช่วยสอนเกี่ยวกับโครงข่ายประสาทเทียม (ANN) ด้วย TensorFlow
 ทีมบรรณาธิการ
⚡ สรุปอย่างชาญฉลาด
โครงข่ายประสาทเทียมเรียนรู้โดยการป้อนข้อมูลเข้าผ่านชั้นที่เชื่อมต่อกัน ประเมินผลลัพธ์ด้วยฟังก์ชันความสูญเสีย และแก้ไขน้ำหนักด้วยตัวปรับแต่ง บทความนี้จะสร้างโครงข่ายประสาทเทียมใน TensorFlow และจำแนกตัวเลข MNIST
โครงข่ายประสาทเทียมคืออะไร?
An โครงข่ายประสาทเทียม (ANN) โครงข่ายประสาทเทียม (Artificial Neural Network หรือ NNNN) คือระบบคอมพิวเตอร์ที่ได้รับแรงบันดาลใจจากโครงข่ายประสาททางชีววิทยา เพื่อสร้างสมองเทียมโดยอาศัยกลุ่มของหน่วยที่เชื่อมต่อกันเรียกว่าเซลล์ประสาทเทียม มันถูกออกแบบมาเพื่อวิเคราะห์และประมวลผลข้อมูลในลักษณะเดียวกับที่มนุษย์ทำ โครงข่ายประสาทเทียมมีความสามารถในการเรียนรู้ด้วยตนเองเพื่อให้ได้ผลลัพธ์ที่ดีขึ้นเมื่อมีข้อมูลมากขึ้น
แผนภาพด้านล่าง tracคือการประมวลผลครบวงจรหนึ่งรอบผ่านเครือข่ายดังกล่าว ตั้งแต่ข้อมูลดิบที่ป้อนเข้าไป ไปจนถึงตัวปรับค่าที่แก้ไขน้ำหนัก

โครงข่ายประสาทเทียม (ANN) ประกอบด้วยวัตถุหลักสี่ประการ:
- เลเยอร์: การเรียนรู้ทั้งหมดเกิดขึ้นในแต่ละชั้น โดยมีทั้งหมด 3 ชั้น ได้แก่ 1) ชั้นอินพุต 2) ชั้นซ่อนเร้น และ 3) ชั้นเอาต์พุต
- คุณลักษณะและป้ายกำกับ: ข้อมูลป้อนเข้าสู่เครือข่าย (คุณลักษณะ) และข้อมูลส่งออกจากเครือข่าย (ป้ายกำกับ)
- ฟังก์ชั่นการสูญเสีย: ตัวชี้วัดที่ใช้ในการประเมินประสิทธิภาพของขั้นตอนการเรียนรู้
- เครื่องมือเพิ่มประสิทธิภาพ: พัฒนาการเรียนรู้โดยการอัปเดตความรู้ในเครือข่าย
โครงข่ายประสาทเทียมรับข้อมูลป้อนเข้าและส่งผ่านไปยังกลุ่มของชั้นต่างๆ จากนั้นโครงข่ายจะประเมินประสิทธิภาพของตนเองด้วยฟังก์ชันความสูญเสีย ฟังก์ชันความสูญเสียจะช่วยให้โครงข่ายทราบเส้นทางที่ต้องเดินก่อนที่จะเชี่ยวชาญความรู้ โครงข่ายจะพัฒนาความรู้นั้นด้วยความช่วยเหลือของตัวเพิ่มประสิทธิภาพ
หากดูภาพด้านบนก็จะเข้าใจกลไกที่ซ่อนอยู่
โปรแกรมจะรับค่าอินพุตบางค่าและส่งค่าเหล่านั้นไปยังเลเยอร์ที่เชื่อมต่อกันอย่างสมบูรณ์สองชั้น ลองนึกภาพว่าคุณมีโจทย์คณิตศาสตร์ สิ่งแรกที่คุณทำคืออ่านบทที่เกี่ยวข้องเพื่อแก้ปัญหา จากนั้นคุณนำความรู้ใหม่ของคุณไปใช้กับโจทย์นั้น มีโอกาสสูงที่คุณจะทำคะแนนได้ไม่ดีนัก เช่นเดียวกับเครือข่ายประสาทเทียม ครั้งแรกที่มันเห็นข้อมูลและทำการทำนาย ผลลัพธ์จะไม่ตรงกับข้อมูลจริงอย่างสมบูรณ์แบบ
เพื่อพัฒนาความรู้ของตนเอง เครือข่ายจึงใช้ตัวปรับแต่ง (optimizer) ในการเปรียบเทียบนี้ ตัวปรับแต่งเปรียบเสมือนการอ่านบทเดิมซ้ำ คุณจะได้รับความเข้าใจใหม่ๆ จากการอ่านอีกครั้ง ในทำนองเดียวกัน เครือข่ายใช้ตัวปรับแต่ง ปรับปรุงความรู้ และทดสอบความรู้ใหม่นั้นเพื่อตรวจสอบว่ายังต้องเรียนรู้เพิ่มเติมอีกมากน้อยเพียงใด โปรแกรมจะทำซ้ำขั้นตอนนี้จนกว่าจะเกิดข้อผิดพลาดน้อยที่สุด
ในแง่ของตัวอย่างโจทย์คณิตศาสตร์ หมายความว่าคุณอ่านบทเรียนในตำราเรียนซ้ำแล้วซ้ำเล่าจนกว่าจะเข้าใจเนื้อหาอย่างถ่องแท้ แม้จะอ่านหลายครั้งแล้ว หากคุณยังคงทำผิดพลาด นั่นหมายความว่าคุณได้ถึงขีดจำกัดความรู้ของเนื้อหาปัจจุบันแล้ว คุณต้องใช้ตำราเรียนเล่มอื่นหรือลองใช้วิธีการอื่นเพื่อปรับปรุงคะแนนของคุณ สำหรับโครงข่ายประสาทเทียมก็เช่นเดียวกัน หากอัตราความผิดพลาดหยุดลดลงและกราฟความสูญเสียราบเรียบลง แสดงว่าโครงสร้างปัจจุบันไม่สามารถเรียนรู้สิ่งใดได้อีกต่อไป โครงข่ายต้องได้รับการปรับปรุงให้ดีขึ้นเพื่อเพิ่มพูนความรู้
วัตถุทั้งสี่ชิ้นนั้นตรงกับส่วนประกอบที่คุณกำหนดค่าเมื่อออกแบบเครือข่าย
โครงข่ายประสาทเทียม Archiเทคเจอร์
โครงสร้างของโครงข่ายประสาทเทียมประกอบด้วยส่วนประกอบดังต่อไปนี้:
- เลเยอร์
- ฟังก์ชั่นการเปิดใช้งาน
- ฟังก์ชั่นการสูญเสีย
- เพิ่มประสิทธิภาพ
เลเยอร์
ชั้น (Layer) คือบริเวณที่เกิดการเรียนรู้ทั้งหมด ภายในชั้นจะมีเซลล์ประสาทจำนวนหนึ่ง ซึ่งแต่ละเซลล์ประสาทจะมีน้ำหนักของตัวเอง เครือข่ายประสาทเทียมทั่วไปมักประมวลผลด้วยชั้นที่เชื่อมต่อกันอย่างหนาแน่น (หรือเรียกว่าชั้นที่เชื่อมต่ออย่างสมบูรณ์) ซึ่งหมายความว่าอินพุตทั้งหมดเชื่อมต่อกับเอาต์พุต
โครงข่ายประสาทเทียมทั่วไปจะรับเวกเตอร์ของข้อมูลนำเข้าและค่าสเกลาร์ที่ประกอบด้วยป้ายกำกับ การตั้งค่าที่ง่ายที่สุดคือการจำแนกแบบไบนารีที่มีเพียงสองคลาส ได้แก่ 0 และ 1
วงจรนี้รับอินพุต ส่งไปยังโหนดที่เชื่อมต่อทั้งหมด และคำนวณสัญญาณด้วยฟังก์ชันการกระตุ้น แผนภาพที่มีหมายเลขด้านล่างแสดงการขยายโหนดเดียวเพื่อให้คุณเห็นผลรวมถ่วงน้ำหนักและขั้นตอนการกระตุ้นแยกกัน

ภาพด้านบนแสดงแนวคิดนี้ ชั้นแรกเก็บค่าอินพุต ชั้นที่สองเรียกว่าชั้นซ่อน จะรับค่าอินพุตที่มีน้ำหนักจากชั้นก่อนหน้า
- โหนดแรกคือค่าอินพุต
- เซลล์ประสาทถูกแบ่งออกเป็นส่วนรับข้อมูลเข้าและส่วนฟังก์ชันกระตุ้น ส่วนซ้ายรับข้อมูลเข้าทั้งหมดจากชั้นก่อนหน้า ส่วนขวาคือผลรวมของข้อมูลเข้าที่ส่งผ่านไปยังฟังก์ชันกระตุ้น
- ค่าเอาต์พุตที่คำนวณจากเลเยอร์ที่ซ่อนอยู่จะถูกนำมาใช้ในการทำนาย สำหรับการจำแนกประเภท ค่าเอาต์พุตจะเท่ากับจำนวนคลาส สำหรับการถดถอย จะทำนายเพียงค่าเดียวเท่านั้น
ฟังก์ชั่นการเปิดใช้งาน
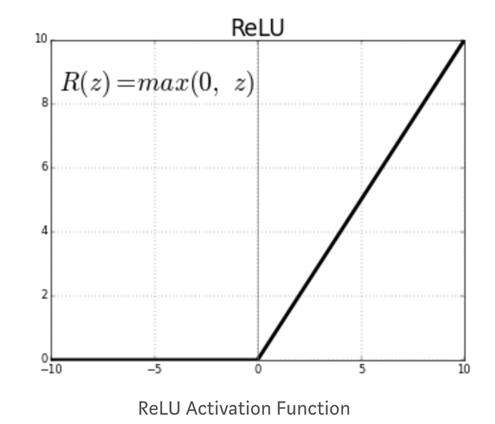
ฟังก์ชันการกระตุ้นของโหนดจะกำหนดเอาต์พุตเมื่อได้รับชุดอินพุต คุณต้องมีฟังก์ชันการกระตุ้นเพื่อให้เครือข่ายสามารถเรียนรู้รูปแบบที่ไม่เป็นเชิงเส้นได้ ฟังก์ชันการกระตุ้นที่นิยมใช้กันคือ ReLU หรือ Rectified Linear Unit ฟังก์ชันนี้จะให้ค่าเป็นศูนย์สำหรับค่าลบทั้งหมด
ฟังก์ชั่นการเปิดใช้งานอื่นๆ ได้แก่:
- เชิงเส้นแบบเป็นชิ้นๆ
- sigmoid
- ตันหยู
- ReLU รั่ว
กราฟด้านล่างแสดงให้เห็นว่าเหตุใดฟังก์ชัน ReLU จึงถูกอธิบายในลักษณะนั้น: เส้นโค้งจะแบนราบที่ศูนย์สำหรับค่าอินพุตติดลบทุกค่า และจะเพิ่มขึ้นเป็นเส้นตรงหลังจากนั้น
การตัดสินใจที่สำคัญในการสร้างโครงข่ายประสาทเทียมคือ:
- โครงข่ายประสาทเทียมมีกี่ชั้น
- แต่ละชั้นมีหน่วยที่ซ่อนอยู่กี่หน่วย
โครงข่ายประสาทเทียมที่มีหลายชั้นและหน่วยซ่อนเร้นสามารถเรียนรู้การแสดงข้อมูลที่ซับซ้อนได้ แต่ก็ทำให้การคำนวณของโครงข่ายมีค่าใช้จ่ายสูงมาก
ฟังก์ชั่นการสูญเสีย
หลังจากที่คุณกำหนดเลเยอร์ที่ซ่อนอยู่และฟังก์ชันการเปิดใช้งานแล้ว คุณจะต้องระบุฟังก์ชันการสูญเสียและเครื่องมือเพิ่มประสิทธิภาพ
สำหรับการจำแนกแบบไบนารี นิยมใช้ฟังก์ชันการสูญเสียแบบไบนารีครอสเอนโทรปี การถดถอยเชิงเส้นคุณใช้ค่าความคลาดเคลื่อนกำลังสองเฉลี่ย
ฟังก์ชันการสูญเสียเป็นตัวชี้วัดที่สำคัญในการประมาณประสิทธิภาพของเครื่องมือเพิ่มประสิทธิภาพ ในระหว่างการฝึกอบรม ตัวชี้วัดนี้จะถูกย่อให้เล็กสุด คุณต้องเลือกปริมาณนี้อย่างระมัดระวัง ขึ้นอยู่กับประเภทของปัญหาที่คุณกำลังเผชิญอยู่
เพิ่มประสิทธิภาพ
ฟังก์ชันความสูญเสีย (Loss function) คือตัววัดประสิทธิภาพของโมเดล ตัวปรับแต่ง (Optimizer) จะช่วยปรับปรุงน้ำหนักของเครือข่ายเพื่อลดความสูญเสีย มีตัวปรับแต่งหลายแบบให้เลือกใช้ แต่ที่พบได้บ่อยที่สุดคือ การไล่ระดับแบบสุ่ม (Stochastic Gradient Descent)
เครื่องมือเพิ่มประสิทธิภาพทั่วไปคือ:
- Momentum การเพิ่มประสิทธิภาพ
- การไล่ระดับความเร่งของ Nesterov
- อดากราด
- การเพิ่มประสิทธิภาพของอดัม
Archiโครงสร้างเพียงอย่างเดียวไม่ได้รับประกันว่าจะเป็นแบบจำลองที่ใช้งานได้
ข้อจำกัดของโครงข่ายประสาทเทียม
ต่อไปนี้คือข้อจำกัดของโครงข่ายประสาทเทียม:
ฟิตติ้งมากเกินไป
ปัญหาทั่วไปของโครงข่ายประสาทเทียมที่ซับซ้อนคือความยากลำบากในการสรุปผลไปยังข้อมูลที่ไม่เคยเห็นมาก่อน โครงข่ายประสาทเทียมที่มีน้ำหนักจำนวนมากสามารถระบุรายละเอียดเฉพาะในชุดข้อมูลฝึกฝนได้เป็นอย่างดี แต่สิ่งนั้นมักนำไปสู่การโอเวอร์ฟิตติ้ง หากข้อมูลไม่สมดุลภายในกลุ่ม (กล่าวคือ มีข้อมูลไม่เพียงพอในบางกลุ่ม) โครงข่ายจะเรียนรู้ได้ดีมากในระหว่างการฝึกฝน แต่จะไม่มีความสามารถในการสรุปผลรูปแบบดังกล่าวไปยังข้อมูลที่ไม่เคยเห็นมาก่อน
มีข้อแลกเปลี่ยนอยู่ เรียนรู้เครื่อง ระหว่างการปรับให้เหมาะสมและการสรุปผลทั่วไป
- การปรับปรุงโมเดลให้เหมาะสมที่สุดนั้น จำเป็นต้องค้นหาพารามิเตอร์ที่ดีที่สุดที่จะช่วยลดความคลาดเคลื่อนของชุดข้อมูลฝึกฝนให้เหลือน้อยที่สุด
- อย่างไรก็ตาม ลักษณะทั่วไปจะบอกว่าโมเดลมีพฤติกรรมอย่างไรกับข้อมูลที่มองไม่เห็น
เพื่อป้องกันไม่ให้โมเดลจับรายละเอียดเฉพาะหรือรูปแบบที่ไม่ต้องการจากข้อมูลการฝึกฝน คุณสามารถใช้เทคนิคต่างๆ ได้ วิธีที่ดีที่สุดคือการมีชุดข้อมูลที่สมดุลและมีปริมาณข้อมูลเพียงพอ ศิลปะในการลดการเกิดโอเวอร์ฟิตติ้งเรียกว่า การทำให้เป็นระเบียบ (Regularization) เทคนิคทั้งสามด้านล่างนี้เป็นจุดเริ่มต้นแบบดั้งเดิม
| เทคนิค | สิ่งที่มันจำกัด | การตั้งค่าทั่วไปในบทช่วยสอนนี้ |
|---|---|---|
| ขนาดเครือข่าย | จำนวนชั้นและหน่วยที่ซ่อนอยู่ | สองชั้นที่ซ่อนอยู่ คือ 300 และ 100 หน่วย |
| การปรับน้ำหนัก L1 / L2 | ขนาดของสัมประสิทธิ์น้ำหนัก | ค่า l1_regularization_strength และ l2_regularization_strength เท่ากับ 0.01 |
| การออกกลางคัน | สัดส่วนของหน่วยที่ถูกปิดใช้งานต่อขั้นตอนการฝึกอบรม | อัตราการหลุดออก 0.3 |
ขนาดเครือข่าย
โครงข่ายประสาทเทียมที่มีจำนวนชั้นและหน่วยซ่อนมากเกินไปนั้นถือว่าซับซ้อนมาก วิธีที่ตรงไปตรงมาในการลดความซับซ้อนของแบบจำลองคือการลดขนาดของมัน ไม่มีแนวทางปฏิบัติที่ดีที่สุดเพียงอย่างเดียวสำหรับการกำหนดจำนวนชั้น คุณต้องเริ่มต้นด้วยจำนวนชั้นน้อยๆ และค่อยๆ เพิ่มขนาดจนกว่าคุณจะพบว่าแบบจำลองเกิดการโอเวอร์ฟิต
การปรับน้ำหนักให้สม่ำเสมอ
เทคนิคมาตรฐานในการป้องกันการเกิดโอเวอร์ฟิตติ้งคือการเพิ่มข้อจำกัดให้กับน้ำหนักของเครือข่าย ข้อจำกัดนี้จะบังคับให้น้ำหนักของเครือข่ายมีค่าเพียงเล็กน้อยเท่านั้น โดยจะเพิ่มข้อจำกัดนี้เข้าไปในฟังก์ชันความสูญเสียของข้อผิดพลาด การควบคุมแบบรีกูเลชันมีสองประเภท:
- L1 (บ่วงบาศ): ต้นทุนจะแปรผันตรงกับค่าสัมบูรณ์ของสัมประสิทธิ์น้ำหนัก
- L2 (สันเขา): ต้นทุนจะแปรผันตรงกับกำลังสองของค่าสัมประสิทธิ์น้ำหนัก
การออกกลางคัน
Dropout เป็นเทคนิคที่แปลกแต่มีประโยชน์ เครือข่ายประสาทเทียมที่มี dropout หมายความว่าหน่วยบางส่วนจะถูกปิดใช้งานแบบสุ่มในระหว่างขั้นตอนการฝึกฝน ดังนั้นสัญญาณขาออกของหน่วยเหล่านั้นจึงกลายเป็นศูนย์ ลองนึกภาพว่าคุณมีอาร์เรย์ของน้ำหนัก [0.1, 1.7, 0.7, -0.9] หากเครือข่ายประสาทเทียมมี dropout มันจะกลายเป็น [0.1, 0, 0, -0.9] โดยมีค่า 0 กระจายอยู่แบบสุ่ม พารามิเตอร์ที่ควบคุม dropout คืออัตรา dropout อัตรานี้กำหนดจำนวนหน่วยที่จะถูกปิดใช้งาน โดยทั่วไปแล้วอัตราจะอยู่ระหว่าง 0.2 ถึง 0.5
ตัวอย่างแบบโต้ตอบขนาดเล็กทำให้เข้าใจกระบวนการฝึกอบรมได้ง่ายขึ้น
ตัวอย่างโครงข่ายประสาทเทียมใน TensorFlow
ต่อไปนี้เป็นตัวอย่างโครงข่ายประสาทเทียมที่แสดงให้เห็นการทำงานของโครงข่ายประสาทเทียมในปัญหาการจำแนกประเภททั่วไป โดยมีอินพุตสองตัวคือ x1 และ x2 ซึ่งแต่ละตัวมีค่าสุ่ม เอาต์พุตเป็นคลาสไบนารี เป้าหมายคือการจำแนกป้ายกำกับตามคุณลักษณะทั้งสอง เพื่อให้บรรลุเป้าหมายนี้ สถาปัตยกรรมของโครงข่ายประสาทเทียมจึงถูกกำหนดดังนี้:
- สองชั้นที่ซ่อนอยู่
- ชั้นแรกมีเซลล์ประสาทสี่เซลล์ที่เชื่อมต่อกันอย่างสมบูรณ์
- ชั้นที่สองมีเซลล์ประสาทสองอันที่เชื่อมต่อกันอย่างสมบูรณ์
- ฟังก์ชันการกระตุ้นคือ ReLU
- เพิ่มการทำให้เป็นมาตรฐาน L2 ด้วยอัตราการเรียนรู้ 0.003
เครือข่ายจะปรับค่าถ่วงน้ำหนักให้เหมาะสมที่สุดในช่วง 180 รอบการฝึก (epochs) โดยมีขนาดชุดข้อมูล (batch size) เท่ากับ 10 ในภาพเคลื่อนไหวตัวอย่าง ANN ด้านล่าง คุณจะเห็นว่าค่าถ่วงน้ำหนักเปลี่ยนแปลงไปอย่างไรเมื่อเวลาผ่านไป และเครือข่ายปรับปรุงแผนที่การจำแนกประเภทได้อย่างไรping.

ประการแรก เครือข่ายจะกำหนดค่าสุ่มให้กับน้ำหนักทั้งหมด
- เมื่อใช้ค่าน้ำหนักแบบสุ่ม กล่าวคือ โดยไม่มีการปรับแต่งใดๆ ค่าความสูญเสียของเอาต์พุตคือ 0.453 ภาพด้านล่างแสดงเครือข่ายด้วยสีต่างๆ
- โดยทั่วไป สีส้มแสดงถึงค่าลบ ในขณะที่สีฟ้าแสดงค่าบวก
- จุดข้อมูลมีรูปแบบการแสดงผลเหมือนกัน คือ จุดสีน้ำเงินแสดงถึงค่าบวก และจุดสีส้มแสดงถึงค่าลบ

ภายในชั้นซ่อนเร้นชั้นที่สอง เส้นต่างๆ จะมีสีตามเครื่องหมายของค่าน้ำหนัก เส้นสีส้มมีค่าน้ำหนักติดลบ และเส้นสีฟ้ามีค่าน้ำหนักเป็นบวก
ดังที่คุณเห็นในแผนที่ผลลัพธ์pingเครือข่ายกำลังทำผิดพลาดค่อนข้างมาก ลองดูว่าเครือข่ายทำงานอย่างไรหลังจากได้รับการปรับปรุงประสิทธิภาพแล้ว
ภาพตัวอย่างโครงข่ายประสาทเทียม (ANN) ด้านล่างแสดงผลลัพธ์ของโครงข่ายที่ได้รับการปรับให้เหมาะสมแล้ว สิ่งแรกที่สังเกตได้คือ โครงข่ายสามารถเรียนรู้การจำแนกข้อมูลได้อย่างถูกต้อง เมื่อเปรียบเทียบกับภาพก่อนหน้า น้ำหนักเริ่มต้นคือ -0.43 ในขณะที่หลังจากปรับให้เหมาะสมแล้ว น้ำหนักจะลดลงเหลือ -0.95

แนวคิดนี้สามารถนำไปประยุกต์ใช้กับเครือข่ายที่มีเลเยอร์ซ่อนและเซลล์ประสาทมากขึ้นได้ คุณสามารถทดลองปรับการตั้งค่าด้วยตนเองได้ใน สนามเด็กเล่น TensorFlow.
ตัวอย่างด้านล่างนี้แสดงวิธีเขียนโค้ดเพื่อสร้างแนวคิดเดียวกันโดยใช้ชุดข้อมูลจริง
วิธีฝึกโครงข่ายประสาทเทียมด้วย TensorFlow
นี่คือขั้นตอนการฝึกฝนโครงข่ายประสาทเทียมทีละขั้นตอน TensorFlow ANN ที่ใช้ตัวประมาณค่า DNNClassifier ของ API
เราจะใช้ชุดข้อมูล MNIST เพื่อฝึกโครงข่ายประสาทเทียมแรกของคุณ การฝึกโครงข่ายประสาทเทียมด้วย TensorFlow ไม่ซับซ้อนมากนัก ขั้นตอนการประมวลผลล่วงหน้าเหมือนกับในบทเรียนก่อนหน้านี้ทุกประการ คุณจะดำเนินการดังต่อไปนี้:
- นำเข้าข้อมูล
- แปลงข้อมูล
- สร้างเทนเซอร์
- สร้างโมเดล
- ฝึกอบรมและประเมินแบบจำลอง
- ปรับปรุงรูปแบบ
หมายเหตุเกี่ยวกับเวอร์ชัน: โค้ดในคำแนะนำนี้ใช้กับ TensorFlow 1.x Estimator API เวอร์ชันสุดท้าย แพ็กเกจ tf-estimator เวอร์ชันสุดท้ายถูกรวมอยู่ใน TensorFlow 2.15 และ tf.estimator ถูกลบออกใน TensorFlow 2.16 หากต้องการทำตามขั้นตอนเหล่านี้ในเวอร์ชันปัจจุบัน ให้เลือก TensorFlow 2.15 หรือสร้างเครือข่ายสองชั้นแบบเดียวกันใหม่โดยใช้ tf.keras.layers.Dense และ model.fit()
ขั้นตอนที่ 1) นำเข้าข้อมูล
ก่อนอื่น คุณต้องนำเข้าไลบรารีที่จำเป็น คุณสามารถนำเข้าชุดข้อมูล MNIST ได้โดยใช้คำสั่งต่อไปนี้ scikit เรียนรู้ ดังแสดงในตัวอย่างโครงข่ายประสาทเทียม TensorFlow ด้านล่าง
ชุดข้อมูล MNIST เป็นชุดข้อมูลที่ใช้กันทั่วไปในการทดสอบเทคนิคหรืออัลกอริธึมใหม่ๆ ประกอบด้วยภาพขนาด 28×28 พิกเซล แต่ละภาพแสดงตัวเลขเขียนด้วยลายมือตั้งแต่ 0 ถึง 9 คณะทำงานของเครือข่ายประสาทเทียมแบบ Convolutional ที่ได้รับการฝึกฝนด้วยการบิดเบี้ยวแบบยืดหยุ่น ช่วยลดข้อผิดพลาดในการทดสอบลงเหลือ 0.27 เปอร์เซ็นต์
import numpy as np
import tensorflow as tf
np.random.seed(1337)
คู่มือฉบับเดิมดาวน์โหลดไฟล์ MNIST ด้วยตนเองและกำหนดให้ fetch_mldata ชี้ไปยังโฟลเดอร์นั้น
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
หมายเหตุ API: เว็บไซต์ mldata.org ไม่สามารถใช้งานได้อีกต่อไปแล้ว และฟังก์ชัน fetch_mldata ก็ถูกลบออกไปใน scikit-learn เวอร์ชัน 0.22 ในการติดตั้งเวอร์ชันปัจจุบัน ให้แทนที่คำสั่งข้างต้นด้วย fetch_openml('mnist_784', version=1) ซึ่งจะดาวน์โหลดตัวเลข 70,000 หลักเดียวกัน และแสดงข้อมูลและคุณลักษณะเป้าหมายที่เหมือนกันทุกประการ
หลังจากนั้น คุณจะแบ่งข้อมูลและหาโครงสร้างของชุดข้อมูลทั้งสองชุด
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
ขั้นตอนที่ 2) แปลงข้อมูล
ในบทเรียนก่อนหน้านี้ คุณได้เรียนรู้ว่าจำเป็นต้องแปลงข้อมูลเพื่อลดผลกระทบของค่าผิดปกติ ในบทเรียนโครงข่ายประสาทเทียมนี้ คุณจะแปลงข้อมูลโดยใช้ตัวปรับขนาดแบบ min-max สูตรคือ:
(X-min_x)/(max_x - min_x)
scikit-learn มีฟังก์ชันสำหรับเรื่องนี้อยู่แล้ว คือ MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
ขั้นตอนที่ 3) สร้างเทนเซอร์
ตอนนี้คุณคุ้นเคยกับวิธีการสร้างแล้ว เทนเซอร์ ใน TensorFlow คุณสามารถแปลงชุดข้อมูลฝึกฝนให้เป็นคอลัมน์ตัวเลขได้
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
ขั้นตอนที่ 4) สร้างแบบจำลอง
โครงสร้างของโครงข่ายประสาทเทียมประกอบด้วยชั้นซ่อน 2 ชั้น โดยชั้นแรกมี 300 หน่วย และชั้นที่สองมี 100 หน่วย ค่าเหล่านี้ได้มาจากประสบการณ์ ไม่ใช่จากสูตร คุณสามารถปรับแต่งค่าเหล่านี้และดูว่าส่งผลต่อความแม่นยำของโครงข่ายอย่างไร
ในการสร้างแบบจำลอง คุณใช้ตัวประมาณค่า DNNClassifier คุณต้องตั้งค่าจำนวนคลาสเป็น 10 เนื่องจากมีสิบคลาสในชุดข้อมูลฝึกฝน คุณคุ้นเคยกับไวยากรณ์ของออบเจ็กต์ตัวประมาณค่าอยู่แล้ว อาร์กิวเมนต์ feature_columns, n_classes และ model_dir เหมือนกับในบทเรียนก่อนหน้าทุกประการ อาร์กิวเมนต์ hidden_units เป็นอาร์กิวเมนต์ใหม่: มันควบคุมทั้งจำนวนเลเยอร์และจำนวนโหนดที่แต่ละเลเยอร์เชื่อมต่อกับโครงข่ายประสาทเทียม ในโค้ดด้านล่าง มีเลเยอร์ซ่อนอยู่สองเลเยอร์ เลเยอร์แรกเชื่อมต่อ 300 โหนด และเลเยอร์ที่สองเชื่อมต่อ 100 โหนด
ในการสร้างตัวประมาณค่า ให้ใช้ tf.estimator.DNNClassifier พร้อมด้วยพารามิเตอร์ต่อไปนี้:
- คอลัมน์คุณลักษณะ: กำหนดคอลัมน์ที่จะใช้ในเครือข่าย
- หน่วยที่ซ่อนอยู่: กำหนดจำนวนเซลล์ประสาทที่ซ่อนอยู่
- n_คลาส: กำหนดจำนวนคลาสที่จะทำนาย
- ไดเร็กทอรีโมเดล: กำหนดเส้นทางของ เทนเซอร์บอร์ด
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
ขั้นตอนที่ 5) ฝึกอบรมและประเมินแบบจำลอง
คุณสามารถใช้ฟังก์ชัน input ของ NumPy เพื่อฝึกฝนโมเดลและประเมินผลได้
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Output:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
สถาปัตยกรรมปัจจุบันส่งผลให้ได้ความแม่นยำบนชุดข้อมูลประเมินประมาณ 96 เปอร์เซ็นต์
ขั้นตอนที่ 6) ปรับปรุงโมเดล
คุณสามารถลองปรับปรุงโมเดลได้โดยการเพิ่มพารามิเตอร์การทำให้เป็นมาตรฐาน
ในที่นี้ ตัวประมาณค่าใช้ตัวเพิ่มประสิทธิภาพ Proximal AdaGrad โดยมีอัตราดรอปเอาต์ 0.3 และตั้งค่าความแรงของ L1 และ L2 เป็น 0.01 ทั้งคู่ ในโครงข่ายประสาทเทียมของ TensorFlow คุณสามารถเข้าถึงตัวเพิ่มประสิทธิภาพได้ผ่านทางอ็อบเจ็กต์ train ตามด้วยชื่อของตัวเพิ่มประสิทธิภาพ TensorFlow มี API ในตัวสำหรับตัวเพิ่มประสิทธิภาพ Proximal AdaGrad
หากต้องการเพิ่มการควบคุมความแม่นยำ (regularization) ให้กับโครงข่ายประสาทเทียมเชิงลึก คุณสามารถใช้ tf.train.ProximalAdagradOptimizer โดยใช้พารามิเตอร์ต่อไปนี้:
- อัตราการเรียนรู้: อัตราการเรียนรู้
- การปรับค่า L1: ความแข็งแรงของการปรับค่า l1
- การปรับค่า L2: ความแข็งแรงของการปรับค่า l2
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Output:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
ค่าที่เลือกเพื่อลดปัญหาโอเวอร์ฟิตติ้งไม่ได้ช่วยปรับปรุงความแม่นยำของโมเดล โมเดลแรกของคุณมีความแม่นยำ 96% ในขณะที่โมเดลที่ใช้ตัวควบคุม L2 มีความแม่นยำ 95% คุณสามารถลองใช้ค่าต่างๆ และดูว่าค่าเหล่านั้นส่งผลต่อความแม่นยำอย่างไร
