
Машинное обучение с учителем: Algorithms, Типы и примеры
 Редакционная коллегия
⚡ Умное резюме
В рамках контролируемого машинного обучения алгоритм обучается на размеченных примерах, чтобы он мог прогнозировать результаты для данных, которые он никогда раньше не видел, используя регрессию для числовых целей и классификацию для категорийных целей, таких как спам или мошенничество.
Что такое контролируемое машинное обучение?
Обучение с учителем — это алгоритм, который обучается на размеченных обучающих данных, чтобы помочь вам прогнозировать результаты для непредвиденных данных. В обучении с учителем вы обучаете машину, используя данные, которые хорошо «размечены». Это означает, что некоторые данные уже помечены правильными ответами. Это можно сравнить с обучением в присутствии учителя или наставника.
Успешное создание, масштабирование и развертывание точных моделей машинного обучения с учителем требует времени и технических знаний от команды высококвалифицированных специалистов по анализу данных. Специалистам по анализу данных также необходимо периодически перестраивать модели, чтобы получаемые ими результаты оставались актуальными при изменении исходных данных.
Как работает контролируемое обучение
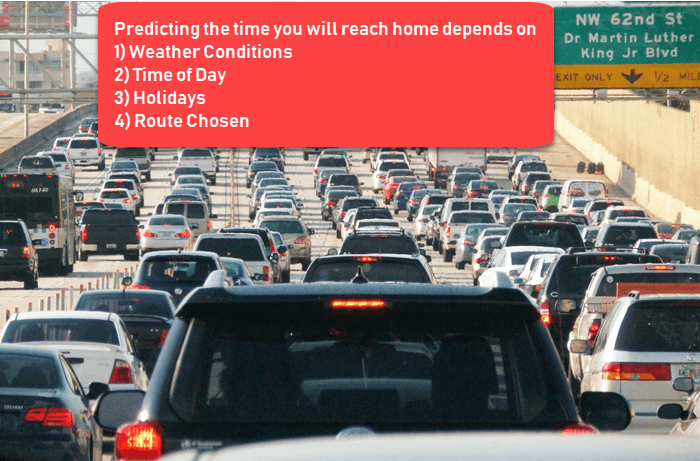
Контролируемое машинное обучение использует наборы обучающих данных для достижения желаемых результатов. Эти наборы данных содержат входные данные и правильные выходные данные, которые помогают модели быстрее обучаться. Например, вы хотите научить машину прогнозировать, сколько времени вам понадобится, чтобы доехать до дома с работы.
Здесь вы начинаете с создания набора помеченных данных. Эти данные включают в себя:
- Погодные условия
- Время суток
- Праздники
- Маршрут выбран
Все эти данные являются вашими входными параметрами в этом примере обучения с учителем. Выходными данными является время, затраченное на поездку домой в тот конкретный день, как показано на изображении ниже.
Вы инстинктивно понимаете, что если на улице дождь, то дорога домой займет больше времени. Но машине нужны данные и статистика.
Первое, что вам нужно создать, это обучающий набор данных. Он будет содержать общее время в пути и соответствующие факторы, такие как погода, время и т. д. На основе этого обучающего набора данных ваша машина может увидеть прямую зависимость между количеством осадков и временем, которое вам потребуется, чтобы добраться домой.
Таким образом, система определяет, что чем больше дождь, тем дольше вам придётся ехать домой. Она также может выявить связь между временем окончания рабочего дня и временем, проведённым в дороге. Чем ближе к 18:00, тем дольше вам придётся ехать домой.
Ваша машина может обнаружить некоторые взаимосвязи с размеченными данными. Эта фаза обучения показана ниже.
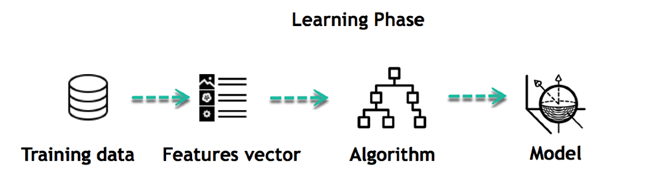
Это начало вашей модели данных. Она начинает фиксировать, как дождь влияет на поведение водителей, и что больше людей путешествуют в определенное время суток.
Типы контролируемого машинного обучения Algorithms
Ниже приведены типы алгоритмов контролируемого машинного обучения:
Регрессия
Метод регрессии позволяет прогнозировать одно непрерывное выходное значение, используя обучающие данные.
Пример. Вы можете использовать регрессию, чтобы спрогнозировать цену дома на основе обучающих данных. Входными переменными будут населенный пункт, размер дома и т. д.
Преимущества: Результаты легко интерпретируются, а алгоритм можно регуляризовать, чтобы избежать переобучения.
Недостатки: Линейная модель негибкая, поэтому она не позволяет выявлять сложные взаимосвязи без добавления дополнительных характеристик.
Вот несколько типов регрессии Algorithms:
- Линейная регрессия
- Полиномиальная регрессия
- Регрессия Риджа и Лассо
- Логистическая регрессия (для классификации)
- Регрессия на основе дерева решений и случайного леса
- Поддержка векторной регрессии
Логистическая регрессия:
Логистическая регрессия используется для оценки дискретных значений на основе заданного набора независимых переменных. Она помогает предсказать вероятность наступления события путем аппроксимации данных логит-функцией. Поэтому ее также называют логистической регрессией. Поскольку она предсказывает вероятность, ее выходное значение находится в диапазоне от 0 до 1, и она может быть неэффективной при наличии множественных или нелинейных границ принятия решений.
классификация
Классификация означает группировку выходных данных внутри класса. Если алгоритм пытается отнести входные данные к двум различным классам, это называется бинарной классификацией. Выбор между более чем двумя классами называется многоклассовой классификацией.
Пример: Определение того, станет ли кто-либо неплатежеспособным по кредиту.
Преимущества: Классификационные деревья демонстрируют очень хорошие результаты на практике.
Недостатки: При отсутствии ограничений отдельные деревья склонны к переобучению.
Вот несколько типов классификации Algorithms:
- Наивные байесовские классификаторы
- Деревья принятия решений
- Машина опорных векторов
- K-Ближайшие соседи
- Случайный лес и градиентный бустинг
Наивные байесовские классификаторы
Наивный байесовский Эта модель проста в построении и очень полезна для больших наборов данных. Она состоит из ориентированных ациклических графов с одним родителем и несколькими потомками. Предполагается независимость дочерних узлов, отделенных от своих родителей.
Деревья решений
Деревья решений классифицируют экземпляр, сортируя его на основе значения признака. В этом методе каждый узел представляет собой признак экземпляра, который должен быть классифицирован, а каждая ветвь представляет значение, которое может принимать этот узел. Это широко используемый метод классификации.
Аналогичная структура подходит и для регрессии: дерево регрессии помогает оценить реальные значения (стоимость покупки автомобиля, количество звонков, общий объем ежемесячных продаж и т. д.).
Машина опорных векторов
Метод опорных векторов (SVM) — это тип алгоритма обучения, появившийся в 1990-х годах. Этот метод основан на результатах статистической теории обучения, разработанной Владимиром Вапником и его коллегами.
Методы опорных векторов (SVM) также тесно связаны с ядерными функциями, которые являются центральной концепцией для большинства задач машинного обучения. Ядерная структура и SVM используются в самых разных областях, включая поиск мультимедийной информации, биоинформатику и распознавание образов. Каждый из вышеперечисленных методов оценки, включая параметры настройки, описан в документации. scikit учиться Справка.
Методы машинного обучения с учителем и без учителя
Разместив метод рядом неконтролируемое обучение четко обозначает свои границы.
| Основано на | Метод контролируемого машинного обучения | Техника машинного обучения без учителя |
|---|---|---|
| Входные данные | Algorithms обучаются с использованием размеченных данных. | Algorithms используются для данных, которые не помечены |
| Вычислительная сложность | Обучение под присмотром – более простой метод. | Обучение без учителя является вычислительно сложным |
| Точность подачи | Очень точный и надежный метод. | Less точный и надежный метод. |
| Типичные алгоритмы | Логистическая регрессия, деревья решений, SVM, наивный байесовский классификатор. | K-средних, иерархическая кластеризация, PCA |
| Как оцениваются результаты | Оценка производится на основе известных ответов (точность, среднеквадратичная ошибка). | Оценка проводилась на основе внутренних показателей и экспертной оценки. |
Проблемы в контролируемом машинном обучении
Вот проблемы, с которыми сталкиваются при контролируемом машинном обучении:
- Нерелевантные входные признаки в обучающих данных могут привести к неточным результатам.
- Подготовка и предварительная обработка данных всегда представляют собой сложную задачу.
- Точность снижается, когда в качестве обучающих данных введены невозможные, маловероятные и неполные значения.
- Если нужный эксперт недоступен, то другой подход — это «грубая сила». Это означает, что вам нужно угадать, на каких признаках (входных переменных) следует обучать машину, и эта догадка может оказаться неточной.
Преимущества контролируемого обучения
На фоне этих трудностей, вот преимущества контролируемого машинного обучения:
- Обучение под наблюдением в Машинное обучение позволяет собирать данные или получать результаты анализа на основе предыдущего опыта.
- Помогает оптимизировать критерии производительности, используя опыт.
- Контролируемое машинное обучение помогает решать различные типы реальных вычислительных задач.
Недостатки контролируемого обучения
Ниже перечислены недостатки контролируемого машинного обучения:
- Граница принятия решений может оказаться переобученной, если в вашем обучающем наборе отсутствуют примеры, которые вы хотите включить в класс.
- Во время обучения классификатора вам нужно выбрать множество хороших примеров из каждого класса.
- Классификация больших данных может представлять собой настоящую проблему.
- Обучение контролируемому обучению требует много вычислительного времени.
Лучшие практики контролируемого обучения
Следующая последовательность действий позволяет сохранить проект в рабочем состоянии. track:
- Прежде чем что-либо предпринимать, определите, какие данные будут использоваться в качестве обучающего набора.
- Определите структуру обучаемой функции и алгоритм обучения.
- Соберите соответствующие результаты либо от экспертов, либо на основе измерений.
- Модель будет хранить тестовый набор данных, который она никогда не увидит, и выведет результат по нему.
