
Матричная функция в R: создание, печать, добавление столбца и среза
 Эвелин Кларк
⚡ Умное резюме
Матрица в R — это двумерный массив, содержащий данные одного типа, занимающий m строк и n столбцов. Он создается с помощью функции matrix(), расширяется с помощью функций cbind() и rbind() и доступен через квадратные скобки.
Матричная функция в R
Матричная функция в R — это двумерный массив, имеющий m строк и n столбцов. Другими словами, матрица в программировании на R — это комбинация двух или более векторов с одним и тем же типом данных.
По сути, матрица — это просто вектор, несущий атрибут dim длиной два. Именно поэтому каждый элемент должен иметь один и тот же тип: как только символьное значение присоединяется к числам, вся матрица преобразуется в символьный тип. R хранит значения в одном столбцовом блоке и использует dim для определения того, где заканчивается каждая строка, поэтому выбор тип данных Применяется ко всему объекту сразу.
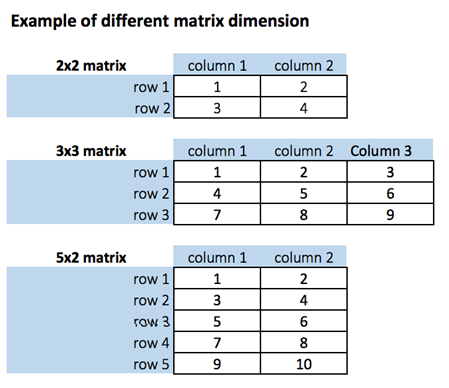
Примечание: Функция matrix() всегда возвращает ровно два измерения. Чтобы создать структуру с тремя или более измерениями в R, используйте функцию array() с вектором измерений или присвойте значение переменной dim() напрямую. На диаграмме ниже показана структура строк и столбцов, которой следует каждая матрица.
Как создать матрицу в R
Мы можем создать матрицу с помощью этой функции. матрица ()Базовая сигнатура R принимает пять аргументов, и три наиболее часто используемых показаны здесь:
matrix(data, nrow, ncol, byrow = FALSE)
Аргументы:
- данным: Набор элементов, которые R расположит в строках и столбцах матрицы.
- Nrow: Количество строк.
- нкол: Количество столбцов.
- пригород: Логический флаг. При значении по умолчанию byrow = FALSE матрица заполняется по столбцам, сверху вниз. При значении byrow = TRUE она заполняется по строкам, слева направо.
- димнеймы: Необязательный список длиной два элемента, содержащий названия строк и столбцов.
Перед первым примером стоит знать две детали из базового справочника R. Если задано только одно из значений nrow и ncol, R определяет другое на основе длины данных. И если данных слишком мало для заполнения запрошенной вами формы, значения используются повторно, а не отклоняются.
Давайте построим две матрицы 5×2 из последовательности чисел от 1 до 10, одну с byrow = TRUE, а другую с byrow = FALSE, чтобы увидеть разницу.
# Construct a matrix with 5 rows that contain the numbers 1 up to 10 and byrow =  TRUE
matrix_a <-matrix(1:10, byrow = TRUE, nrow = 5)
matrix_a
Выход:
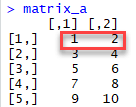
Поскольку было указано значение byrow = TRUE, консоль заполняет первую строку числами 1 и 2, вторую — 3 и 4 и так далее.
Выведите размерность матрицы matrix_a с помощью функции dim().
Теперь давайте напечатаем размерность матрицы в R с помощью dim(). Синтаксис печати матрицы в R с использованием dim():
# Print dimension of the matrix with dim()
dim(matrix_a)
Выход:
## [1] 5 2
Функция dim() сначала возвращает количество строк, а затем количество столбцов, подтверждая структуру 5×2.
Заполнить матрицу по столбцам, установив значение byrow равным FALSE.
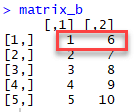
Те же десять чисел и та же строка дают другое расположение при изменении направления заполнения.ping В настройках byrow по умолчанию значения сначала располагаются в первом столбце, а затем начинаются во втором.
# Construct a matrix with 5 rows that contain the numbers 1 up to 10 and byrow =  FALSE
matrix_b <-matrix(1:10, byrow = FALSE, nrow = 5)
matrix_b
Выход:
Выведите размерность матрицы matrix_b с помощью функции dim().
Снова распечатайте размер матрицы, используя dim(). Ниже приведен синтаксис измерения матрицы печати R:
# Print dimension of the matrix with dim()
dim(matrix_b)
Выход:
## [1] 5 2
Форма остается неизменной при размере 5×2, поскольку байроул изменяет порядок заполнения, но никогда не меняет размеры.
ВниманиеИспользование команды matrix_b <-matrix(1:10, byrow = FALSE, ncol = 2) даст тот же эффект, что и выше, поскольку R определяет nrow = 5 на основе десяти предоставленных значений.
Также можно создать матрицу 4×3 с помощью функции ncol. R создаст 3 столбца и заполнит каждый столбец сверху вниз. Посмотрите пример.
matrix_c <-matrix(1:12, byrow = FALSE, ncol = 3)
matrix_c
Выход:
##       [,1] [,2] [,3]
## [1,]    1    5    9
## [2,]    2    6   10
## [3,]    3    7   11
## [4,]    4    8   12
Заголовки столбцов [,1] до [,3] и метки строк [1,] до [4,] являются стандартными заполнителями R. Они исчезают, как только указываются реальные имена измерений, как показано далее в этом руководстве.
Это критически важно для анализа и выбора наиболее эффективных ключевых слов для улучшения рейтинга вашего сайта.
dim(matrix_c)
Выход:
## [1] 4 3
Добавьте столбец в матрицу с помощью cbind()
Добавить столбец в матрицу R можно с помощью команды cbind(). cbind() означает привязку столбцов и может объединять столько матриц или столбцов, сколько указано. Например, в нашем предыдущем примере была создана матрица 5×2. Мы добавляем третий столбец и проверяем, что размерность равна 5×3.
Это критически важно для анализа и выбора наиболее эффективных ключевых слов для улучшения рейтинга вашего сайта.
# concatenate c(1:5) to the matrix_a
matrix_a1 <- cbind(matrix_a, c(1:5))
# Check the dimension
dim(matrix_a1)
Выход:
## [1] 5 3
Это критически важно для анализа и выбора наиболее эффективных ключевых слов для улучшения рейтинга вашего сайта.
matrix_a1
Результат
##       [,1] [,2] [,3]
## [1,]    1    2    1
## [2,]    3    4    2
## [3,]    5    6    3
## [4,]    7    8    4
## [5,]    9   10    5
Это критически важно для анализа и выбора наиболее эффективных ключевых слов для улучшения рейтинга вашего сайта.
Мы также можем связывать более одного столбца одновременно. Следующий блок создает матрицу matrix_a2, матрицу 4×3, содержащую числа от 13 до 24, чтобы ее можно было соединить с матрицей matrix_c 4×3 и получить результат 4×6, охватывающий числа от 1 до 24.
matrix_a2 <-matrix(13:24, byrow = FALSE, ncol = 3)
Выход:
##      [,1] [,2] [,3]
## [1,]   13   17   21
## [2,]   14   18   22
## [3,]   15   19   23
## [4,]   16   20   24
Это критически важно для анализа и выбора наиболее эффективных ключевых слов для улучшения рейтинга вашего сайта.
matrix_c <-matrix(1:12, byrow = FALSE, ncol = 3)
matrix_d <- cbind(matrix_a2, matrix_c)
dim(matrix_d)
Выход:
## [1] 4 6
ЗАМЕТКАДля корректной работы функции cbind() количество строк матриц в R должно быть одинаковым. Если они различаются, R либо повторно использует более короткий входной массив, либо выдает ошибку, поэтому более безопасным вариантом является предварительная проверка размера (dim()) обоих объектов.
В то время как cbind() объединяет столбцы, rbind() добавляет строки. Давайте добавим одну строку к нашей матрице matrix_c и убедимся, что ее размерность составляет 5×3.
matrix_c <-matrix(1:12, byrow = FALSE, ncol = 3)
# Create a vector of 3 columns
add_row <- c(1:3)
# Append to the matrix
matrix_c <- rbind(matrix_c, add_row)
# Check the dimension
dim(matrix_c)
Выход:
## [1] 5 3
Обратите внимание, что привязка именованного вектора, например add_row, также присваивает новой строке это имя, что является первым шагом к созданию маркированных матриц, которые будут рассмотрены далее.
Разрезать матрицу
Мы можем выбрать один или несколько элементов из матрицы в R программирование с помощью квадратных скобок [ ]. Внутри скобок сначала указывается селектор строки, а затем селектор столбца, разделяемые запятой. Именно здесь вступает в игру срез.
Например:
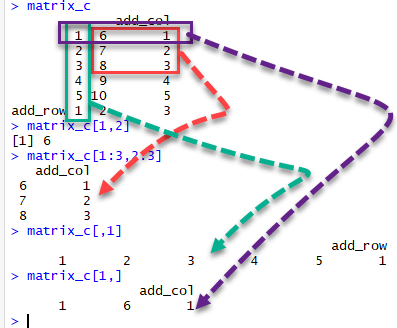
- матрица_c[1,2] выбирает элемент в первой строке и втором столбце.
- Функция matrix_c[1:3,2:3] создает матрицу-срез R, в которой данные находятся в строках 1, 2, 3 и столбцах 2 и 3.
- матрица_c[,1] выбирает все элементы первого столбца.
- матрица_c[1,] выбирает все элементы первой строки.
Оставляя пустую сторону запятой, вы получаете все значения с этой стороны. Одно из последствий, которое может сбить с толку новичков: при выборе одной строки или столбца R удаляет пустое измерение и возвращает обычный вектор. Добавление drop = FALSE, как в matrix_c[1, , drop = FALSE], сохраняет результат в виде матрицы.
Вот результат, который вы получаете для приведенных выше кодов
Назовите строки и столбцы матрицы в R.
Метки по умолчанию, такие как [,1] и [3,], затрудняют чтение выходных данных, как только матрица приобретает реальный смысл. Аргумент dimnames, а также функции замены rownames() и colnames() добавляют текстовые метки, которые затем перемещаются вместе с матрицей через функции cbind(), t() и каждую операцию нарезки.
# Name the rows and columns while the matrix is built
sales <- matrix(1:6, nrow = 2, ncol = 3,
                dimnames = list(c('north', 'south'), c('q1', 'q2', 'q3')))

# Or attach the names afterwards
rownames(sales) <- c('north', 'south')
colnames(sales) <- c('q1', 'q2', 'q3')

# Read the names back as a list of two character vectors
dimnames(sales)

# Names make label based slicing possible
sales['north', 'q2']
| Функция | Читает | Наборы |
|---|---|---|
| dimnames(m) | Оба измерения представлены в виде списка из двух векторов. | dimnames(m) <- list(rows, cols) |
| названия строк (m) | Метки строк | rownames(m) <- rows |
| colnames(m) | Заголовки столбцов | colnames(m) <- cols |
| dim(m) | Строки и столбцы представлены двумя целыми числами. | dim(m) <- c(nrow, ncol) |
После того, как метки появились, sales['north', 'q2'] становится гораздо понятнее, чем sales[1, 2], и сохраняется при изменении порядка строк. Установка компонента dimnames в NULL снова удаляет этот набор меток, и матрица, преобразованная с помощью as.data.frame(), переносит имена строк и столбцов непосредственно в матрицу. фрейм данных.
матрица OperaФункции в R: арифметика, транспонирование и умножение.
Арифметические операции над матрицами — вот где правило единого типа действительно работает. Базовый R обрабатывает весь набор без дополнительного пакета, но два оператора легко спутать: * умножает элемент за элементом, в то время как %*% выполняет настоящее матричное умножение и требует, чтобы столбцы левого операнда совпадали со строками правого.
m1 <- matrix(1:4, nrow = 2)
m2 <- matrix(5:8, nrow = 2)

m1 + m2          # element by element addition
m1 * m2          # element by element product, NOT matrix multiplication
m1 %*% m2        # true matrix multiplication
t(m1)            # transpose: rows become columns
solve(m1)        # inverse, for a square matrix that is not singular

rowSums(m1)      # one total per row
colMeans(m1)     # one mean per column
apply(m1, 1, max)   # any function, applied row by row
- т(м): Транспонирует матрицу, так что элемент [i, j] становится [j, i]. Имена размерностей переносятся.
- решить(m)Функция возвращает обратную матрицу для квадратной невырожденной матрицы, а solve(a, b) решает систему линейных уравнений.
- rowSums / colSums / rowMeans / colMeansВ документации указано, что этот метод эквивалентен методу apply() с использованием сумм или среднего значения, но работает значительно быстрее.
- apply(m, MARGIN, FUN): MARGIN = 1 обрабатывает строки, а MARGIN = 2 — столбцы, для любой заданной вами функции.
- диаг, дет, кросспрод: Диагональ, определитель и более быстрая форма t(x) %*% y.
Поскольку эти операции векторизованы, они заменяют циклы, а не находятся внутри них. Сводка, которая в противном случае потребовала бы вложенного цикла for для обработки тысяч ячеек, превращается в один вызов функции colMeans(), что имеет значение по мере роста объема данных.
Матрица, фрейм данных и массив в R
Матрицы, фреймы данных и массивы в консоли выглядят как прямоугольные объекты, но отвечают на разные вопросы. В таблице они расположены рядом.
| Свойства | матрица | Фрейм данных | массив |
|---|---|---|---|
| Габаритные размеры: | Ровно 2 | Ровно 2 | Любой номер |
| Типы столбцов | Один тип для всего объекта | Разный тип для каждого столбца | Один тип для всего объекта |
| Построен с | матрица () | data.frame() | Массив () |
| Типичное использование | Численные вычисления и линейная алгебра | Смешанные данные наблюдений | Таблицы с накоплением, например, с подсчетом по годам. |
| Метки строк | Дополнительные имена измерений | Названия строк всегда присутствуют. | Дополнительные имена измерений |
# A matrix holds one type only, so mixing coerces everything to character
mixed <- matrix(c(1, 2, 'a', 'b'), nrow = 2)
class(mixed[1, 1])

# Convert between the structures
as.data.frame(matrix_c)
as.matrix(mtcars)

# A matrix is the two dimensional case of an array
is.matrix(matrix_c)
inherits(matrix_c, 'array')
Обращайтесь к матрице, когда каждая ячейка содержит одно и то же число, и работа сводится к арифметическим операциям. Обращайтесь к фрейм данных когда столбцы содержат разные типы данных, например, символьное имя рядом с числовой ценой и факторПотянитесь за список Когда части имеют разную длину, и для массива, когда действительно существует третий индекс, например, время или регион. Преобразование в любом направлении выполняется недорого с помощью as.matrix() и as.data.frame(), поэтому структура может следовать за задачей, а не наоборот.
