
Как заменить пропущенные значения (NA) в R: na.omit и na.rm
 Эвелин Кларк
⚡ Умное резюме
В разделе «Замена пропущенных значений в R» рассматриваются обнаружение значений NA, удаление неполных строк с помощью функции na.omit() и заполнение их средним или медианой с помощью функции mutate(). В этом пошаговом руководстве используется набор данных о «Титанике», где и возраст, и стоимость проезда содержат пропущенные значения.
Что такое пропущенные значения в R?
Пропущенные значения появляются, когда в столбце наблюдения отсутствует записанное значение или когда нечисловой заполнитель находится там, где должно быть число. Их необходимо удалить или заменить перед любыми вычислениями, поскольку большинство функций R возвращают NA, как только оно появляется.
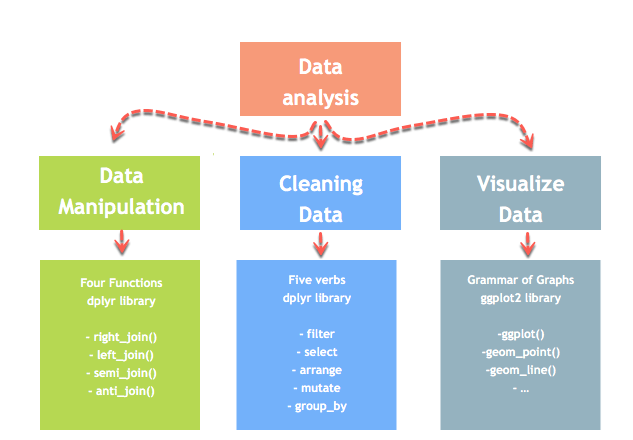
В этом руководстве показано, как обрабатывать пропущенные значения с помощью библиотеки dplyr, входящей в экосистему tidyverse для анализа данных.
Первым шагом всегда является выяснение того, сколько значений отсутствует и где именно.
Как обнаружить и подсчитать пропущенные значения в R
Прежде чем решать, что делать с пропущенными значениями, необходимо знать, сколько их и где они находятся. R предлагает четыре способа проверки: от одного ответа «да» или «нет» до полного подсчета по каждому столбцу.
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
На практике лучше всего использовать функцию colSums(). Она возвращает именованный вектор с одним значением в каждом столбце, что сразу показывает, отсутствуют ли в переменной несколько значений или она в основном пуста.
Подсчет целых строк. Метод complete.cases() возвращает TRUE для строк, в которых нигде нет пропущенных значений, что заранее указывает, сколько данных будет отброшено методом na.omit():
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
Предупреждение о наличии заполнителей. R распознает только NA. В наборах данных пропущенные значения часто кодируются как пустая строка, пробел, «N/A», «-» или контрольный номер, например, -99 или 999. Они проходят все вышеперечисленные проверки незаметно. Преобразуйте их при импорте, чтобы остальная часть рабочего процесса работала корректно:
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
После импорта всегда проверяйте диапазон каждого числового столбца. Возраст -99 или стоимость проезда 9999 гораздо опаснее, чем честное значение NA, потому что ни одна функция не предупредит вас об этом.
Типы пропущенных данных: MCAR, MAR и MNAR
Причина отсутствия значения определяет, безопасно ли его восполнять. Статистики выделяют три механизма.
- MCAR, пропал совершенно случайным образом. Вероятность пропажи не зависит ни от чего, наблюдаемого или нет, например, от датчика, который выходит из строя в случайные моменты. Падениеping Использование этих строк для заполнения пропущенных значений не вносит никакой погрешности, а лишь приводит к потере точности.
- MAR, отсутствует случайным образом. Вероятность зависит от других наблюдаемых переменных, но не от самого пропущенного значения. Если у пожилых пассажиров вероятность указания возраста ниже, то возраст будет MAR (Master of Record — не указан) с учетом других столбцов. Метод импутации, использующий эти столбцы, хорошо справляется с этой задачей.
- MNAR, пропажа произошла не случайно. Вероятность зависит от самого ненаблюдаемого значения, например, от того, что высокооплачиваемые работники отказываются указывать свой доход. Ни один метод восполнения не может исправить это, опираясь только на данные, а само отсутствие данных содержит информацию, которую стоит зафиксировать в столбце-флаге.
Метод замещения средним значением, используемый в этом руководстве, оправдан только при условии MCAR и простого MAR. Даже в этом случае у него есть известная цена: заполнение каждого пробела одним и тем же числом уменьшает дисперсию столбца и ослабляет его корреляцию со всеми остальными. Для серьезной работы используйте метод, основанный на моделях, например, пакет mice, и всегда ведите столбец-флаг, указывающий, какие значения были замещены.
мутировать ()
Функция mutate() — это дплир Глагол, который создает новую переменную или перезаписывает существующую, что делает его естественным инструментом для создания очищенной копии столбца.
Мы продолжим работу в двух частях. Мы научимся:
- исключить пропущенные значения из фрейма данных
- вменить пропущенные значения с помощью среднего и медианы
Глагол mutate() очень прост в использовании. Мы можем создать новую переменную, следуя этому синтаксису:
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
Исключить пропущенные значения (NA)
Функция na.omit() — это базовая функция R, а не команда dplyr, но она всё равно корректно обрабатывает данные через конвейер. Она удаляет все строки, содержащие хотя бы одно значение NA. Это самый быстрый вариант, но редко лучший, поскольку одно пропущенное значение отбрасывает всё наблюдение.
Чтобы решить проблему отсутствия наблюдений, мы будем использовать набор данных Titanic. В этом наборе данных у нас есть доступ к информации о пассажирах, находившихся на борту во время трагедии. В этом наборе данных много NA, о которых необходимо позаботиться.
Загрузите CSV-файл из интернета, затем выведите список столбцов, содержащих значения NA:
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
Выход:
## [1] "age" "fare"
Здесь,
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
Возвращает названия столбцов, содержащих хотя бы одно пропущенное значение.
В столбцах «возраст» и «тариф» отсутствуют значения.
Мы можем удалить их с помощью na.omit().
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
Выход:
## [1] 1045 13
Новый набор данных содержит 1045 строк по сравнению с 1309 строками в исходном наборе данных.
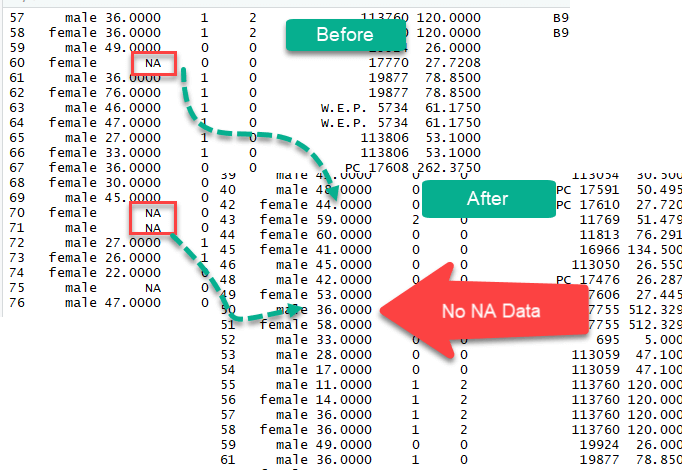
Заполните недостающие данные средним значением и медианой.
Также можно заполнить пропущенные значения средним или медианой. Рекомендуется создать две отдельные переменные для среднего значения и медианы. После создания этих переменных можно заменить пропущенные значения.
Мы будем использовать метод apply для вычисления среднего значения столбца с NA. Давайте посмотрим пример
Шаг 1) Ранее в этом руководстве мы сохранили имена столбцов с отсутствующими значениями в списке list_na. Мы будем использовать этот список
Шаг 2) Вычислите среднее значение с аргументом na.rm = TRUE. Этот аргумент является обязательным, поскольку в столбцах содержатся пропущенные данные, и он указывает R игнорировать их.
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code Объяснение:
Мы передаем 4 аргумента в метод apply.
- df: df_titanic[,colnames(df_titanic) %in% list_na]. Этот код вернет имена столбцов из объекта list_na (т. е. «возраст» и «тариф»).
- 2: Вычислить функцию по столбцам
- среднее: вычислить среднее значение
- na.rm = TRUE: игнорировать пропущенные значения.
Выход:
##      age     fare
## 29.88113 33.29548
Мы успешно создали среднее значение столбцов, содержащих отсутствующие наблюдения. Эти два значения будут использоваться для замены отсутствующих наблюдений.
Шаг 3) Замените значения NA
Глагол mutate из библиотеки dplyr полезен при создании новой переменной. Нам не обязательно менять исходный столбец, поэтому мы можем создать новую переменную без NA. mutate прост в использовании, мы просто выбираем имя переменной и определяем, как создать эту переменную. Вот полный код
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code Объяснение:
Мы создаем две переменные replace_mean_age и replace_mean_fare следующим образом:
- replace_mean_age = ifelse(is.na(возраст), среднее_отсутствие[1], возраст)
- replace_mean_fare = ifelse(is.na(fare), Average_missing[2],fare)
Если в столбце «Возраст» отсутствуют значения, замените их первым элементом Average_missing (средний возраст), иначе сохраните исходные значения. Та же логика для тарифа
sum(is.na(df_titanic_replace$age))
Выход:
## [1] 263
После замены в новом столбце полностью отсутствуют пропущенные значения:
sum(is.na(df_titanic_replace$replace_mean_age))
Выход:
## [1] 0
В исходном столбце age содержалось 263 пропущенных значения, тогда как в новом столбце replace_mean_age каждое из них заполнено средним возрастом.
Шаг 4) Мы также можем заменить недостающие наблюдения медианой.
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
Выход:

Шаг 5) При работе с большим набором данных пошаговый метод становится утомительным. Функция sapply() сводит всю процедуру к одному оператору, но при этом никогда не отображает вмененные значения.
sapply не создает фрейм данных, поэтому мы можем обернуть функцию sapply() внутри data.frame() для создания объекта фрейма данных.
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
Современная импутация с использованием функций replace_na() и across()
Приведенные выше подходы с использованием apply() и sapply() по-прежнему работают, но библиотеки tidyr и dplyr теперь выражают те же операции более безопасно и читаемо.
Функция replace_na() заменяет фиксированные значения. Функция tidyr::replace_na() принимает именованный список столбцов и список заменяемых столбцов:
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
Функция across() применяется к каждому числовому столбцу. Это прямая, типобезопасная замена однострочному вызову функции sapply(), и в отличие от sapply() она никогда не затрагивает символьные или факторные столбцы:
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ Почему использование сокращения sapply() рискованно: Пример использования функции sapply() в одной строке занимает слишком много времени. каждую столбец, включая символьные и факторные. Вызов функции mean() для них возвращает NA с предупреждением, а затем sapply() преобразует весь результат в символьный формат. Приведенная выше версия across(where(is.numeric), …) полностью избегает этой проблемы.
Функция coalesce() используется для резервных столбцов. Если недостающее значение может быть получено из второго столбца, функция coalesce() возвращает первую содержащуюся в столбце запись среди всех своих аргументов:
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
Записывайте все внесенные изменения. Перед заполнением пропущенных данных добавьте флаг, чтобы любая последующая модель могла извлечь урок из того факта, что значение отсутствовало:
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
Обработка пропущенных значений в R: Справочник по методам
В этом руководстве рассматриваются три подхода:
- Исключить все недостающие наблюдения
- Вменить среднее значение
- Вменить с медианой
В таблице ниже приведена сводная информация об обнаружении и удалении:
| Библиотека | Цель | Code |
|---|---|---|
| Использование темпера с изогнутым основанием | Перечислите недостающие наблюдения |
colnames(df)[apply(df, 2, anyNA)] |
| Использование темпера с изогнутым основанием | Удалите все строки, содержащие NA. |
na.omit(df) |
Вменение среднего значения или медианы может быть выполнено двумя способами.
- Использование приложения
- Использование саппли
| Способ доставки | Описание | Преимущества | Недостатки |
|---|---|---|---|
| Шаг за шагом с применением | Проверьте столбцы с отсутствующими значениями, вычислите среднее/медиану, сохраните значение, замените с помощью mutate() | Вы можете увидеть вмененное среднее или медиану. | Больше времени выполнения. Может быть медленным с большим набором данных |
| Быстрый способ с sapply | Используйте sapply() и data.frame() для автоматического поиска и замены пропущенных значений средним/медианным значением. | Короткий код и быстро | Вмененные значения никогда не отображаются. |
