
10 najlepszych darmowych narzędzi do web scrapinguping Narzędzia (2026)
 Zespół redakcyjny
Ujawnienie: Guru99 jest wspierane przez czytelników. Możemy otrzymać prowizję, gdy dokonasz zakupu za pośrednictwem linków na tej stronie. Zobacz więcej
Scratch sieciowyping Narzędzia mogą zaoszczędzić godziny, jednak błędny wybór często zwraca niekompletne rekordy, uruchamia blokady IP, marnuje kredyty, ukrywa ważne limity i pozostawia początkujących w niezrozumiałych panelach. Niestabilne selektory lub niespójne renderowanie mogą również powodować błędy w raportach bez ostrzeżenia. Czytelnicy często porównują limity nagłówków, pomijając koszty żądań. JavaObsługa skryptów, przechowywanie danych i kontrola zgodności. Bardziej przejrzysty przegląd uwidacznia te kompromisy, pomaga dopasować każdy przepływ pracy do odpowiedniej usługi i przekształca niepewną listę zadań w łatwy do opanowania kolejny krok.
Poświęciłem ponad 55 godzin na badanie ponad 18 narzędzi, sprawdzając oficjalne strony produktów, limity dostępu, przepływy pracy i powtarzające się wzorce recenzji. Moje dogłębne badania wyłoniły 10 najlepszych darmowych narzędzi do web scrackowania.ping Opcje narzędzi z funkcjami, zaletami i wadami, poparte aktualnymi szczegółami planu. Przewodnik oddziela stałe, bezpłatne plany od kredytów próbnych i płatnych testów, dzięki czemu możesz kontynuować z jasno sprecyzowanymi oczekiwaniami. Czytaj więcej ...
Oxylabs jest wiodącą na rynku platformą gromadzenia informacji o sieci. Działa zgodnie z najwyższymi standardami biznesowymi, etycznymi i zgodności, umożliwiając firmom na całym świecie odblokowywanie spostrzeżeń opartych na danych. Oferuje mechanizm automatycznego ponawiania prób, który pomaga obsługiwać i obchodzić blokady IP.
Najlepszy darmowy Web Scratchping Oprogramowanie i narzędzia
| Imię i nazwisko | Najlepsze dla: | Kluczowe funkcje | Łatwość użycia | Free Trial | Połączyć |
|---|---|---|---|---|---|
>> Oxylabs |
Dane na dużą skalę, np.traccja | Wysoki wskaźnik sukcesu, Geotargetowanie, Ustrukturyzowane dane | Umiarkowany | Nielimitowane | Dowiedz się więcej |
 👍 Odkoduj |
Zaawansowane skanowanie danychping Nasze rozwiązania | Rotacja IP, Wysoki wskaźnik sukcesu, Zarządzanie proxy | Łatwo | 7-dniowy bezpłatny okres próbny | Dowiedz się więcej |
 👍 NodeMaven |
Premiumowy serwer proxy do użytku domowego i mobilnegoping | Filtr jakości IP, 7-dniowe sesje stałe, ponad 190 krajów | Łatwo | 750 MB za 3.50 dolara | Dowiedz się więcej |
 Webshare |
Przystępna cenowo sieć proxy dla Scraping | Ponad 80 mln adresów IP, geotargetowanie, rotacja adresów IP | Łatwo | 10 darmowych serwerów proxy | Dowiedz się więcej |
 Apify |
Programiści i entuzjaści automatyzacji | Zaawansowane dane extraccja, wywołania API | Umiarkowany | Dożywotni bezpłatny plan podstawowy | Dowiedz się więcej |
1) Oxylabs
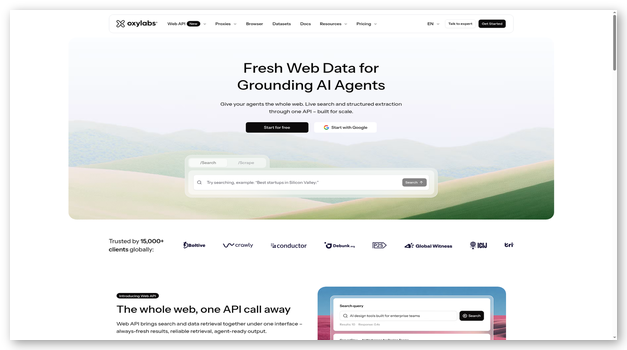
Oxylabs zapewnia zarządzaną sieć Scraper API dla zespołów zbierających dane publiczne z trudnych witryn. Obsługuje routing proxy, renderowanie w przeglądarce, ponowne próby i ustrukturyzowane dostarczanie za pośrednictwem jednego API. Zespoły monitorujące sprzedaż detaliczną mogą żądać zlokalizowanych stron produktów bez konieczności utrzymywania oddzielnych flot przeglądarek.
Panel koncentruje się na użytkowaniu, żądaniach i kontroli parsera. Zapytania wsadowe i harmonogramowanie obsługują zadania cykliczne, a OxyCopilot pomaga generować żądania. Usługa lepiej pasuje do obciążeń produkcyjnych niż do okazjonalnych projektów jednorazowych, zwłaszcza gdy przewidywalność dostaw jest ważniejsza niż posiadanie własnego repozytorium.ping infrastruktura na dużą skalę.
Cechy:
- Zarządzane żądania: Interfejs API kieruje żądania przez odpowiednią infrastrukturę i ponawia zablokowane próby. Zespoły otrzymują użyteczne odpowiedzi bez konieczności utrzymywania dużych list serwerów proxy lub procesów roboczych przeglądarki.
- Przeglądarka bez interfejsu użytkownika: Przeglądarka ładuje renderowanie JavaStrony z dużą ilością skryptów przedtraccja. Obsługuje dynamiczne listy produktów, interaktywne strony podróży i inne treści, których brakuje w surowym formacie HTML.
- Niestandardowy parser: Niestandardowe reguły analizy składniowej konwertują obsługiwane strony na pola strukturalne. Analitycy poświęcają mniej czasu na czyszczenie znaczników przed załadowaniem wyników do baz danych lub raportów.
- Zapytania zbiorcze: Grupy przesyłania wsadowego obejmują wiele celów URLw jeden przepływ pracy. Zmniejsza to nakład pracy związany z organizacją, gdy zespoły monitorują ceny, stany magazynowe, wyniki wyszukiwania lub oferty.
- Harmonogram: Zaplanowane zadania uruchamiają cykliczne kolekcje w określonych odstępach czasu. Dzięki temu zespoły mogą odświeżać zestawy danych bez konieczności korzystania z oddzielnej usługi cron dla każdego projektu.
- Geotargetowanie: Parametry lokalizacji żądają stron z wybranych rynków. Badacze mogą porównywać regionalne ceny, dostępność lub wyniki wyszukiwania za pośrednictwem tej samej integracji API.
- Kontrola użytkowania: Panel pokazuje zużycie wyników i aktywność żądań. Zespoły mogą tracobjętość k przed osiągnięciem limitów staje się niespodzianką podczas cyklu produkcyjnego.
ZALETY
Wady
???? Jak zdobyć Oxylabs za darmo?
- Otwórz Oxylabs Sieć Scraper Strona z cennikiem API.
- Załóż konto i wybierz bezpłatny okres próbny bez dodawania karty.
- Wersja próbna obejmuje do 2,000 wyników dla obsługiwanego scraping przepływy pracy.
Bezpłatny okres próbny z maksymalnie 2,000 wyników
2) Dekodować
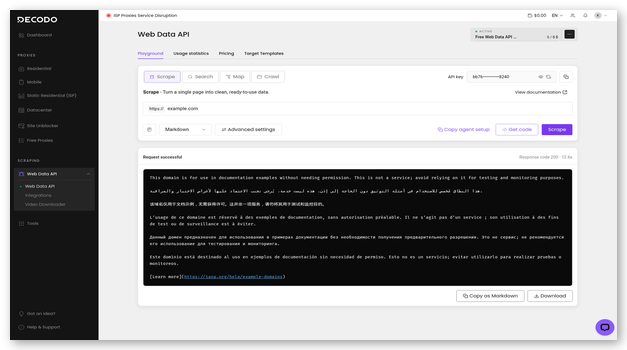
Dekodować łączy infrastrukturę proxy z Web Scratchping API stworzone dla programistów, analityków i przepływów pracy AI. Jego punkty końcowe scrapowania, wyszukiwania, mapowania i indeksowania obejmują zarówno pojedyncze strony, jak i wielostronicowe wyszukiwanie. Przygotowane szablony zwracają ustrukturyzowane dane dla typowych celów bez konieczności stosowania niestandardowego parsera.
Panel udostępnia klucze API, ustawienia żądań, sposób użycia i opcje wyjściowe. JavaRenderowanie skryptów i zarządzany wybór proxy obsługują trudniejsze strony, a dane wyjściowe Markdown obsługują potoki językowo-modelowe. Stały, darmowy plan sprawia, że Decodo jest praktycznym rozwiązaniem dla prototypów, zanim zespoły będą mogły niezawodnie obsługiwać większą liczbę żądań.
Cechy:
- Cztery punkty końcowe: Punkty końcowe do zbierania, wyszukiwania, mapowania i indeksowania obejmują skoncentrowane np.traci wyszukiwanie witryn. Deweloperzy mogą obsługiwać wiele zadań związanych z danymi za pomocą jednego klucza API.
- Przygotowane szablony: Ponad 100 utrzymywanych szablonów jest dostosowanych do popularnych witryn i typów danych. Zmniejszają one ilość pracy z selektorami i przyspieszają wczesne projekty proof-of-concept.
- JavaRenderowanie skryptu: Opcjonalne renderowanie ładuje dynamiczną zawartość przed jej dostarczeniem. Zespoły mogą zbierać dane ze stron renderowanych przez klienta bez konieczności uruchamiania własnego klastra przeglądarek bez interfejsu graficznego.
- Elastyczne wyjście: Odpowiedzi mogą zawierać dane HTML, Markdown, JSON, CSV, PNG lub XHR, jeśli są obsługiwane. Każdy przepływ pracy może wybrać format gotowy do analizy.
- Obsługa proxy: Wbudowany wybór serwera proxy i kontrola anty-botów redukują konieczność ręcznego obracania. Żądania mogą docierać do stron geo-wrażliwych, podczas gdy API zarządza decyzjami dotyczącymi infrastruktury.
- Połączenia AI: MCP i inne ścieżki integracji umożliwiają dostęp do aktualnych danych internetowych za pośrednictwem obsługiwanych narzędzi AI. Jest to rozwiązanie odpowiednie dla agentów badawczych i procesów wyszukiwania wymagających dostępu do źródeł na żywo.
- Kontrola żądań: Limity przepustowości i łączne zużycie są wyświetlane przy każdym planie. Zespoły mogą określać rozmiar projektu na podstawie wolumenu indeksowania, zamiast opierać się wyłącznie na przepustowości.
ZALETY
Wady
???? Jak zdobyć Decodo za darmo?
- Odwiedź witrynę internetową Decodo Scraping Strona z cennikiem API.
- Załóż bezpłatne konto i skopiuj wygenerowane dane uwierzytelniające API.
- Bezpłatny plan obejmuje 5,000 indeksowań lub 10 000 ściągniętych stron miesięcznie.
Bezpłatny plan z maksymalnie 10 000 stronami
3) NodeMaven
NodeMaven jest platformą proxy dla Scraping zespoły, które już posiadają byłetracKod encji lub automatyzacja przeglądarki. Opcje domowe, mobilne i dostawcy usług internetowych obsługują połączenia HTTP i SOCKS5 w szerokim zakresie geograficznym. Filtr jakości IP sprawdza adresy przed przypisaniem, aby ograniczyć liczbę możliwych do uniknięcia awarii.
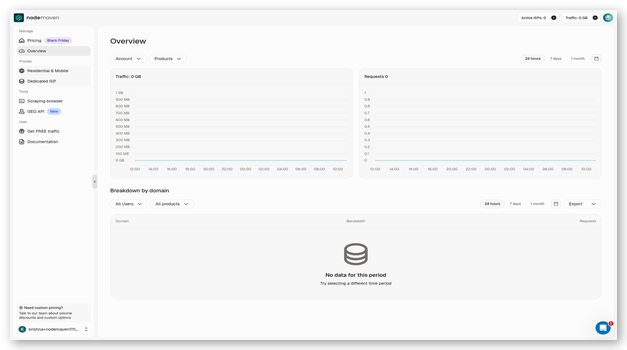
Panel koncentruje się na ruchu, poświadczeniach, targetowaniu i ustawieniach rotacji, a nie na analizowanych zestawach danych. Stałe sesje zapewniają ciągłość konta lub lokalizacji, natomiast rotacja na żądanie sprawdza się w przypadku szerokiego indeksowania. NodeMaven działa najlepiej, gdy jakość proxy i kontrola sesji są ważniejsze niż gotowy skan.ping API.
Cechy:
- Filtr jakości: Filtr jakości IP sprawdza dostępne adresy przed przypisaniem. Czystsze pule mogą zmniejszyć liczbę zmarnowanych ponownych prób i urzędów certyfikacji.PTCPrzerwy w sieci HA podczas długich cykli zbierania danych.
- Typy serwerów proxy: Proxy domowe, mobilne i dostawcy usług internetowych znajdują się na jednym koncie. Zespoły mogą dopasować reputację, stabilność i koszt do każdego serwera proxy.ping target.
- Sterowanie obrotem: Połączenia mogą zmieniać się między żądaniami lub pozostawać stałe przez dłuższe sesje. Obsługuje to zarówno duże przeszukiwania, jak i przepływy pracy wymagające spójnej tożsamości.
- Geotargetowanie: Kontrola kraju, miasta i dostawcy usług internetowych zawęża lokalizację wyjścia. Badacze mogą zbierać dane o lokalnych cenach, reklamach, wynikach wyszukiwania lub dostępności.
- Obsługa protokołów: Obsługa HTTP i SOCKS5 działa ze standardowymi skryptami i narzędziami automatyzacji. Istniejące roboty indeksujące mogą się łączyć bez konieczności zmiany swojego adresu.traclogika cji.
- Przeniesienie ruchu: Niewykorzystany ruch może zostać przeniesiony na kolejny okres rozliczeniowy w ramach obecnych planów. Pomaga to projektom z nierównomiernymi miesięcznymi harmonogramami odbioru zachować zakupioną przepustowość.
- Panel użytkowania: Szczegóły dotyczące ruchu i połączenia są widoczne w panelu konta. Zespoły mogą monitorować zużycie danych i dostosowywać rotację, zanim indeksowanie wyczerpie limit.
ZALETY
Wady
???? Jak zdobyć NodeMaven za darmo?
- Otwórz stronę z cennikiem NodeMaven i utwórz konto.
- Wybierz wersję próbną, aby uzyskać dostęp do serwera proxy dla urządzeń stacjonarnych i urządzeń mobilnych.
- Płatna wersja próbna kosztuje 3.50 USD i obejmuje 750 MB transferu danych.
Wersja próbna 750 MB za 3.50 USD
4) Webshare
Webshare Zapewnia połączenia proxy dla centrów danych, domów i dostawców usług internetowych (ISP) dla skryptów, robotów indeksujących i automatyzacji przeglądarek. Stały, darmowy plan zapewnia małym projektom dziesięć serwerów proxy dla centrów danych i miesięczny limit przepustowości. Użytkownicy mogą uwierzytelniać się za pomocą danych uwierzytelniających lub zatwierdzonych adresów IP.
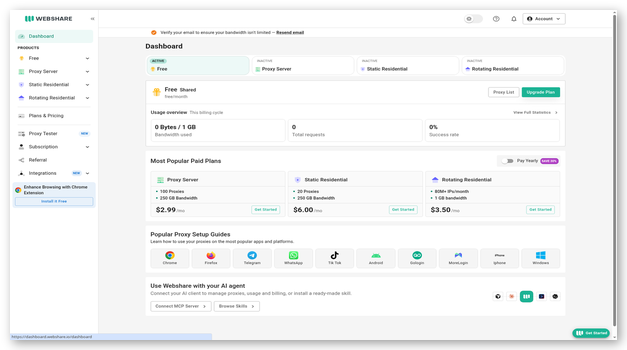
Panel prezentuje w jednym miejscu listy serwerów proxy, szczegóły połączeń, wykorzystanie i dostęp do API. Kontrola rotacji ułatwia dystrybucję żądań, a filtry lokalizacji obsługują zbieranie danych regionalnych. Webshare nadaje się do nauki i lekkich zadań wymagających niezawodnego dostępu przez serwer proxy, choć nie zastępuje parsera ani kompletnego scraping workflow.
Cechy:
- Bezpłatne serwery proxy: Stały, darmowy plan obejmuje dziesięć serwerów proxy w centrach danych i 1 GB miesięcznego transferu danych. Małe eksperymenty można kontynuować bez wygasającego okresu próbnego.
- Wybór serwera proxy: Płatne opcje obejmują połączenia do centrów danych, sieci domowych i dostawców usług internetowych. Zespoły mogą wybrać pulę na podstawie poziomu trudności, stabilności i budżetu docelowego.
- Obrót: Rotacja punktów końcowych automatycznie zmienia adresy dla obsługiwanych planów. Zmniejsza to konieczność ręcznej obsługi listy proxy w przypadku większych lub często powtarzanych zestawów żądań.
- Kontrola geograficzna: Filtry lokalizacji pomagają kierować zapytania przez odpowiednie kraje lub regiony. Badacze rynku mogą porównywać zlokalizowane treści, korzystając z tego samego procesu łączenia.
- Dostęp do API: Interfejs API udostępnia dane dotyczące serwerów proxy i operacji na kontach, umożliwiając automatyzację. Deweloperzy mogą konfigurować i pobierać połączenia bez kopiowania list z pulpitu nawigacyjnego.
- Poświadczenie: Poświadczenia nazwy użytkownika i autoryzacja IP obsługują różne wzorce wdrażania. Zespoły mogą zabezpieczyć dostęp do serwerów, laptopów lub rozproszonego systemu Scratch.ping pracowników.
- Stosowanie trackról: Metryki na pulpicie pokazują przepustowość i aktywność serwera proxy. Użytkownicy mogą zauważyć zbliżające się limity, zanim robot indeksujący zatrzyma się podczas ważnego procesu zbierania danych.
ZALETY
Wady
???? Jak zdobyć Webshare za darmo?
- Otwarte Webshare i załóż bezpłatne konto bez karty.
- Przejdź do listy serwerów proxy, aby pobrać szczegóły przypisanego połączenia.
- Bezpłatny plan obejmuje dziesięć serwerów proxy centrów danych i 1 GB transferu miesięcznie.
10 darmowych serwerów proxy i 1 GB miesięcznie
5) Apify
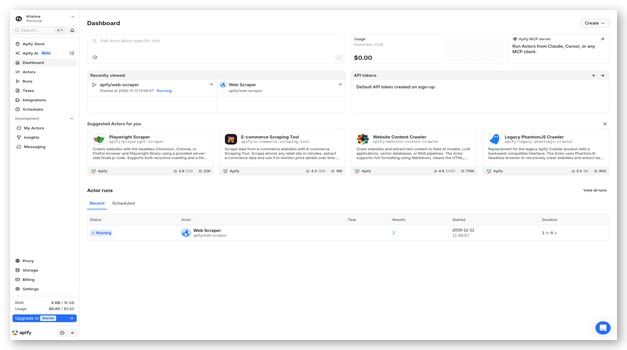
Apify to platforma chmurowa do uruchamiania wielokrotnego użytku scraperów zwanych Actors. Jej publiczny sklep obejmuje popularne witryny, a programiści mogą tworzyć własne Actors za pomocą Crawlee lub innych obsługiwanych narzędzi. Harmonogramy, zestawy danych, kolejki i webhooki przekształcają pojedyncze przebiegi w powtarzalne przepływy pracy z danymi.
Konsola wyświetla dane wejściowe, dzienniki uruchomień, zasoby pamięci masowej, koszty i dane wyjściowe dla każdego aktora. Zespoły mogą eksportować rekordy lub łączyć je za pośrednictwem interfejsu API. Apify Oferuje szeroką elastyczność, choć jakość rynkowa i koszty użytkowania są zróżnicowane. Jest to rozwiązanie odpowiednie dla użytkowników, którzy potrzebują zarówno gotowych scraperów, jak i programowalnej platformy automatyzacji.
Cechy:
- Sklep aktorski: Sklep oferuje gotowe scrapery do wielu popularnych stron internetowych i zadań. Użytkownicy mogą zacząć od istniejącego Aktora, zamiast kodować każdy kolektor.
- Aktorzy niestandardowi: Programiści mogą pakować własne pliki Scraping Logika jako aktorów wielokrotnego użytku. Wersjonowane dane wejściowe i kompilacje ułatwiają wielokrotne uruchamianie tego samego przepływu pracy.
- Harmonogram: Wbudowane harmonogramy uruchamiają aktorów w wybranych momentach lub odstępach czasu. Cykliczne monitorowanie cen, ofert lub treści może odbywać się bez zewnętrznego harmonogramu.
- Przechowywanie danych: Zestawy danych, magazyny klucz-wartość i kolejki żądań porządkują dane wyjściowe i stan indeksowania. Każdy przebieg przechowuje swoje rekordy dostępne do eksportu lub dalszego przetwarzania.
- Integracja: Interfejsy API, webhooki i łączniki przesyłają wyniki do innych systemów. Zespoły mogą uruchamiać zadania kontrolne po pomyślnym lub niepowodzeniu wykonania.
- Opcje proxy: Platforma oferuje usługi proxy dla centrów danych i serwerów rezydencjalnych. Użytkownicy mogą rotować połączeniami bez konieczności korzystania z oddzielnie zarządzanego dostawcy proxy.
- Uruchom monitorowanie: Dla każdego uruchomienia wyświetlane są logi, status, wykorzystanie zasobów obliczeniowych i koszty. Programiści mogą diagnozować awarie i szacować zużycie zasobów przez powtarzające się zadanie.
ZALETY
Wady
???? Jak zdobyć Apify za darmo?
- Odwiedź ApifyWejdź na stronę z cennikiem i wybierz plan Bezpłatny.
- Załóż konto nie podając danych karty płatniczej.
- Plan odnawia się z miesięcznym limitem środków w wysokości 5 USD i pięcioma równoległymi biegami.
5 USD darmowego kredytu miesięcznie
6) Novada
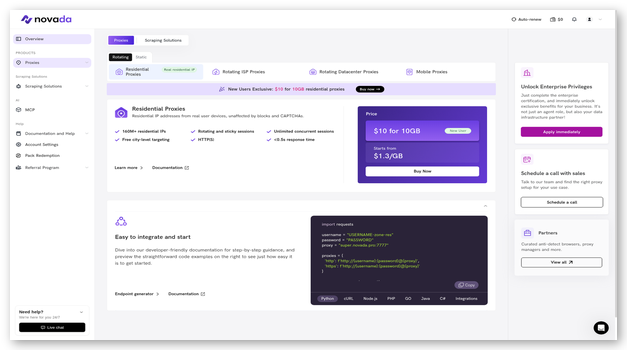
Novada grupy a Scraper API, Web Unblocker i Browser API w ramach jednego salda kredytowego. Scraper Interfejs API zwraca ustrukturyzowane rekordy dla obsługiwanych celów, podczas gdy interfejs API przeglądarki obsługuje interaktywność JavaSkryptuj strony za pomocą znanych protokołów automatyzacji. Zarządzane mechanizmy anty-botowe redukują nakłady na infrastrukturę.
Jego deska rozdzielcza traczużycie produktów ks, domeny, kredyty i równoczesne żądania. Ujednolicone rozliczenia umożliwiają zespołom przełączanie się między metodami bez konieczności posiadania oddzielnych subskrypcji. Novada jest przydatny do mieszanych extracPotrzeby te są spełnione, ale dostęp próbny wymaga udostępnienia kampanii i zatwierdzenia wsparcia. Zakupione kredyty również wygasają po upływie określonego okresu ważności.
Cechy:
- Scraper OGIEŃ: Scraper API zwraca oczyszczone dane dla obsługiwanych celów wyszukiwania, handlu i mediów społecznościowych. Zespoły mogą pominąć znaczną część etapu analizy kodu HTML.
- Odblokowywanie sieci: Web Unblocker zwraca nieprzetworzone strony, jednocześnie radząc sobie z typowymi barierami dostępu. Jest odpowiedni dla zespołów, które chcą zachować własną logikę analizy składniowej.
- API przeglądarki: Przeglądarki w chmurze obsługują połączenia w stylu Puppeteer i Playwright. Programiści mogą renderować strony, klikać elementy, przewijać i przechwytywać złożone interaktywne treści.
- Połączone punkty: Jedno saldo pokrywa scraping, odblokowywanie i produkty przeglądarkowe. Zespoły mogą zmieniać metody bez konieczności kupowania osobnego abonamentu na każdą usługę.
- Pomyślne rozliczenie: Novada nalicza opłaty za żądania, gdy żądania zwracają dane zgodnie z opublikowanymi zasadami. Nieudane żądania platformy nie zużywają tego samego salda.
- Ustrukturyzowany wynik: Obsługiwane szablony zawierają rekordy JSON lub CSV zamiast surowych znaczników. Analitycy mogą ładować wyniki do raportów, oszczędzając czas.
- Kontrola współbieżności: Poziomy planów definiują przepustowość dla żądań równoległych dla każdego produktu. Zespoły mogą wybrać limit, który odpowiada liczbie żądań robota indeksującego i oczekiwanym czasom odpowiedzi.
ZALETY
Wady
???? Jak zdobyć Novada za darmo?
- Stwórz Novakonto i otwórz stronę kampanii z bezpłatnym okresem próbnym.
- Podziel się kampanią z trzema grupami, a następnie wyślij zrzuty ekranu do działu wsparcia.
- Po zatwierdzeniu, Novada dodaje 15 dolarów kredytu na proxy i scraping narzędzia.
15 dolarów kredytu próbnego
7) Bright Data
Bright Data oferuje predefiniowane strony internetowe Scraper API, Scraping Przeglądarka, Scraper Studio, serwery proxy i zestawy danych. Zespoły mogą wybierać ustrukturyzowane rekordy lub sterować zdalną przeglądarką za pomocą Playwrighta i Puppeteera. Wbudowana obsługa dostępu zarządza rotacją, odciskami palców przeglądarki i wyzwaniami dostępu.
Panel sterowania oddziela produkty, dane uwierzytelniające, użytkowanie, kolektory i ustawienia dostawy. Wbudowane interfejsy API redukują konieczność konserwacji obsługiwanych celów, a dostęp przez przeglądarkę obsługuje niestandardowe interakcje. Bright Data Pasuje do wymagających projektów o szerokim zakresie zastosowań i potrzebach wsparcia. Bogaty katalog produktów i opcje korporacyjne mogą wydawać się zbyt rozbudowane w przypadku prostych, osobistych projektów.ping.
Cechy:
- Scraper Pszczoła: Gotowe interfejsy API zwracają ustrukturyzowane rekordy dla obsługiwanych witryn i kategorii. Zespoły unikają konieczności utrzymywania selektorów i logiki przeglądarki dla każdej zmiany celu.
- Bliznaping Przeglądarka: Przeglądarka hostowana łączy się przez Playwright lub Puppeteer. Deweloperzy mogą wykonywać JavaSkryptuj i automatyzuj interakcje podczas Bright Data zarządza infrastrukturą dostępową.
- Scraper Studio: Narzędzia Studio pomagają tworzyć i wdrażać niestandardowe kolektory. Opcje wizualne i wspomagane sztuczną inteligencją skracają czas konfiguracji obiektów docelowych bez przygotowanego interfejsu API.
- Sieć proxy: Zintegrowane usługi proxy obejmują wiele typów połączeń i lokalizacji. Przepływy pracy mogą kierować ruchem bez konieczności przenoszenia danych uwierzytelniających między różnymi dostawcami.
- Opcje dostawy: Zebrane dane mogą być przesyłane przez interfejsy API, webhooki lub obsługiwane lokalizacje w chmurze. Zespoły mogą przesyłać dane do istniejących magazynów i procesów analitycznych po każdym uruchomieniu.
- Kontrola wydatków: Opcje płatności według zużycia i miesięczne limity pomagają zarządzać zużyciem. Widoki wykorzystania na pulpicie pokazują, jak kolektor wpływa na budżet projektu.
- Bezpłatne płyty: Web Scraper Bezpłatny poziom API obejmuje 5,000 rekordów miesięcznie. Do rozpoczęcia tego opublikowanego poziomu nie jest wymagana karta płatnicza.
ZALETY
Wady
???? Jak zdobyć Bright Data za darmo?
- Otwarte Bright DataSieć 's Scraper Strona z cennikiem API.
- Wybierz opcję Rozpocznij za darmo i zarejestruj się bez podawania numeru karty płatniczej.
- Bezpłatny poziom obejmuje 5,000 witryn internetowych Scraper Rekordy API co miesiąc.
5,000 darmowych rekordów miesięcznie
8) PrivateProxy
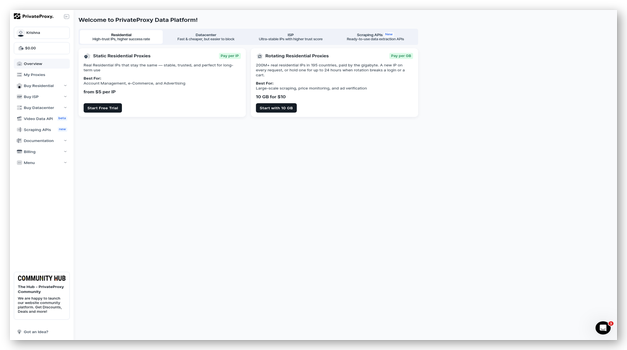
PrivateProxy Oferuje statyczne i rotacyjne pakiety proxy do skryptów i automatyzacji przeglądarek. Statyczne wersje próbne dla użytkowników indywidualnych i centrów danych pozwalają użytkownikom przetestować jeden adres przed podjęciem decyzji, natomiast płatne plany rotacyjne obejmują ruch oparty na żądaniach lub przepustowości. Połączenia obsługują typowe wzorce uwierzytelniania.
Obszar konta koncentruje się na pakietach, lokalizacjach, danych uwierzytelniających, użytkowaniu i statusie subskrypcji. Dedykowane opcje statyczne są odpowiednie dla zadań wymagających spójnego adresu, a usługi rotacyjne sprawdzają się w szerszym zakresie. PrivateProxy jest elementem infrastruktury, a nie kompletnym narzędziem do zbierania danych, dlatego zespoły muszą dostarczać np.traclogika operacji, ponowne próby, przechowywanie i walidacja danych.
Cechy:
- Serwery proxy statyczne: Opcje statycznego centrum danych i dostawcy usług internetowych zachowują jeden adres przez okres subskrypcji. Są one odpowiednie dla sesji wymagających ciągłości lub dostępu z listy dozwolonych.
- Dostęp rotacyjny: Rotacja pakietów zmienia adresy między żądaniami lub sesjami. Pozwala to na rozłożenie ruchu robota indeksującego bez konieczności utrzymywania oddzielnej lokalnej listy serwerów proxy.
- Opcje próbne: Wybrane pakiety statyczne obejmują dwudniowy bezpłatny okres próbny z weryfikacją karty. W przypadku pakietów z rotacją prób obowiązuje cena wprowadzająca w pierwszym cyklu.
- Poświadczenie: Poświadczenia nazwy użytkownika i autoryzacja oparta na adresie IP obsługują typowe wdrożenia serwerowe. Zespoły mogą wybrać metodę najlepiej dopasowaną do ich środowiska indeksującego.
- Wybór lokalizacji: Dostępne pakiety umożliwiają wybór regionu podczas składania zamówienia. Użytkownicy mogą dopasować lokalizację proxy do badanego rynku lub strony internetowej.
- Kontrola subskrypcji: Na pulpicie nawigacyjnym wyświetlane są aktywne pakiety i status odnowienia. Użytkownicy wersji próbnej mogą anulować pakiet przed odnowieniem, aby uniknąć miesięcznej opłaty.
- Obsługa protokołów: Połączenia HTTP, HTTPS i SOCKS obejmują wiele protokołów Scratchping biblioteki i przeglądarki. Istniejące narzędzia mogą łączyć się bez konieczności instalowania oprogramowania specyficznego dla dostawcy.tracPakiet SDK cji.
ZALETY
Wady
???? Jak zdobyć PrivateProxy za darmo?
- Otwarte PrivateProxystronę pomocy i wybierz odpowiednią wersję próbną.
- Wybierz szczegóły lokalizacji i dodaj kartę w celu weryfikacji.
- Bezpłatny okres próbny trwa dwa dni i odnawia się, jeśli nie zostanie niezwłocznie anulowany.
2-dniowy bezpłatny okres próbny
9) ScraperAPI
ScraperAPI Zapewnia programistom jeden punkt końcowy do pobierania stron przez zarządzane pule proxy. Obsługuje rotację adresów, automatyczne ponawianie prób i certyfikację.PTCHA, geotargetowanie i opcjonalne JavaRenderowanie skryptów. Ustrukturyzowane punkty końcowe obejmują wybrane cele handlowe i wyszukiwania, a asynchroniczne API obsługuje większe partie żądań.
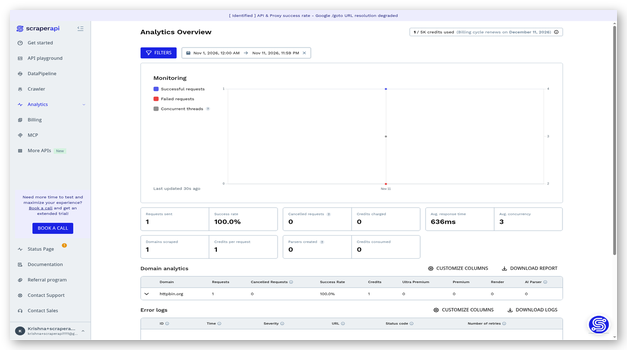
Panel wyświetla dane uwierzytelniające API, wykorzystanie kredytu, współbieżność i analizę żądań. DataPipeline umożliwia planowanie i dostarczanie bez oddzielnej usługi crawlującej. ScraperAPI Rozwiązanie odpowiednie dla zespołów, które już wiedzą, o jakie strony prosić, ale chcą uniknąć operacji proxy. Koszty kredytów różnią się w zależności od celu i włączonych funkcji.
Cechy:
- Pojedynczy punkt końcowy: Standardowe żądanie API wysyła cel URL i klucz uwierzytelniający. ScraperAPI zarządza wyborem serwera proxy i zwraca wynikową odpowiedź strony.
- Automatyczne ponowne próby: Nieudane lub zablokowane próby można ponawiać za pośrednictwem różnych połączeń. Zmniejsza to niestandardową logikę ponawiania w skrypcie wywołującego.ping aplikacji.
- JavaRenderowanie skryptu: Opcjonalne renderowanie wczytuje zawartość po stronie klienta przed zwróceniem odpowiedzi. Dynamiczne strony produktów i interfejsy aplikacji stają się dostępne za pośrednictwem tego samego interfejsu API.
- Dane strukturalne: Dedykowane punkty końcowe zwracają przeanalizowane rekordy dla obsługiwanych celów. Zespoły mogą uniknąć konieczności utrzymywania selektorów dla wspólnych stron produktów, wyszukiwania i ofert.
- Rurociąg danych: DataPipeline planuje kolekcje i dostarcza ukończone pliki do obsługiwanych miejsc docelowych. Analitycy mogą obsługiwać powtarzające się zadania bez konieczności budowania pełnej warstwy orkiestracji.
- Kosztorysant: Narzędzia pulpitu nawigacyjnego szacują zużycie kredytu na URL i zestaw parametrów. Pomaga to zespołom porównywać koszty renderowania, proxy premium i obejścia.
- Bezpłatny dodatek: Opublikowany darmowy plan obejmuje 1,000 kredytów API i pięć jednoczesnych połączeń. Użytkownicy mogą testować standardowe żądania przed wyborem planu płatnego.
ZALETY
Wady
???? Jak zdobyć ScraperAPI za darmo?
- Odwiedź ScraperAPIstronę z cennikiem i załóż bezpłatne konto.
- Skopiuj klucz API i przetestuj standardowe żądanie.
- Bezpłatny plan obejmuje 1,000 kredytów i pięć jednoczesnych połączeń miesięcznie.
1,000 darmowych kredytów miesięcznie
10) ScrapingBee
ScrapingBee jest interfejsem API służącym do zbierania stron wymagających przeglądarek, serwerów proxy lub kontroli lokalizacji. JavaRenderowanie skryptowe ładuje interaktywną zawartość, a połączenia klasyczne, premium i ukryte obsługują różne poziomy trudności. Interfejsy API zrzutów ekranu i wyszukiwania rozszerzają to samo konto poza pobieranie kodu HTML.
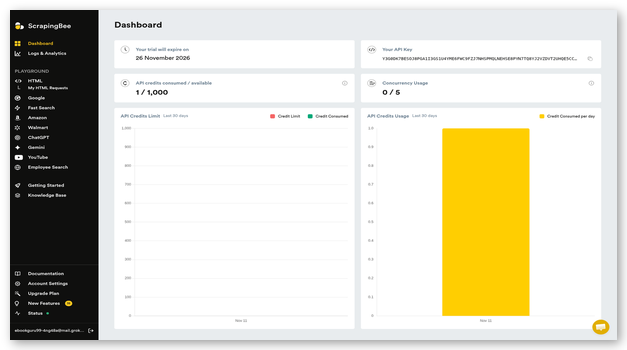
Panel udostępnia klucz API, kreator żądań, szacunkową wartość kredytową i historię użytkowania. Deweloperzy mogą dodawać własne nagłówki lub JavaScenariusze skryptowe dla kliknięć i przewijania. Wyj. AItraccja akceptuje instrukcje polowe w języku potocznym. ScrapingBee jest dostępny dla użytkowników API, chociaż włączenie opcji może znacznie zmienić koszt kredytu.
Cechy:
- API HTML: Interfejs API HTML zwraca wyrenderowaną lub niewyrenderowaną zawartość strony przez jeden punkt końcowy. Programiści kontrolują poziom proxy, lokalizację, nagłówki i zachowanie przeglądarki.
- Scenariusze JS: warunki indywidualne JavaScenariusze skryptowe mogą klikać, przewijać, czekać lub wchodzić w interakcję przed przechwyceniem. Obsługuje to strony, na których treść pojawia się dopiero po wykonaniu czynności przez użytkownika.
- Poziomy proxy: Trasy klasyczne, premium i ukryte pozwalają na różne poziomy blokowania. Zespoły mogą zacząć od tańszego dostępu i zwiększać go tylko w razie potrzeby.
- były AItraccja: Zapytania w języku potocznym itracReguły identyfikują żądane pola. Zmniejsza to nakład pracy selektora, gdy zespoły potrzebują szybkiego, ustrukturyzowanego wyniku zmiany stron.
- API zrzutów ekranu: Prośby o zrzut ekranu obejmują całe strony lub wybrane elementy. Zespoły monitorujące mogą przechowywać dowody wizualne obok np.tracwartości i rekordy zmian.
- Konstruktor żądań: Kreator pulpitu generuje kod i wyświetla szacowany koszt kredytu. Programiści mogą zweryfikować parametry przed dodaniem ich do aplikacji.
- Darmowe kredyty: Każde nowe konto otrzymuje 1,000 punktów API bez konieczności podawania karty płatniczej. Punkty te wspierają okres próbny, ale nie odnawiają się w ramach ograniczonego czasowo okresu próbnego.
ZALETY
Wady
???? Jak zdobyć ScrapingBee za darmo?
- Otwarte ScrapingBee i zarejestruj nowe konto bez karty.
- Użyj kreatora żądań pulpitu nawigacyjnego, aby wygenerować połączenie testowe.
- Każde nowe konto otrzymuje 1,000 darmowych kredytów API na potrzeby ewaluacji.
1,000 darmowych kredytów rejestracyjnych
Tabela porównawcza funkcji najlepszych narzędzi do scrapingu internetowegoping Narzędzia
Jak wybraliśmy najlepsze darmowe narzędzie do scrapingu stron internetowych?ping Przybory?

At Guru99, zobowiązujemy się do dostarczania dokładnych, istotnych i obiektywnych informacji, aby pomóc użytkownikom podejmować świadome decyzje. Nasz proces redakcyjny koncentruje się na dostarczaniu informacyjnych i wiarygodnych zasobów, zapewniając, że treść jest zarówno wiarygodna, jak i godna zaufania. Po przegląd ponad 18 najlepszych programów do tworzenia stron internetowychping narzędzia, w tym bezpłatne i płatne opcje, skompilowaliśmy kompleksowy wybór na podstawie ich funkcji, zalet, wad i cen. Ten przewodnik zapewnia szczegółowe zrozumienie każdego narzędzia, pomagając Ci wybrać najlepsze dla Twoich potrzeb. Skupiamy się na następujących czynnikach podczas recenzowania narzędzia na podstawie funkcjonalności, łatwości użytkowania i wszechstronności.
- Łatwa obsługa: Wybraliśmy narzędzia ze względu na ich przyjazny interfejs użytkownika, umożliwiający zarówno początkującym, jak i ekspertom płynne zbieranie danych.
- Wydajność: Eksperci w naszym zespole priorytetowo potraktowali narzędzia zoptymalizowane pod kątem wydajności, zapewniające szybkie i dokładne pozyskiwanie danych, np.tracbez kompromisów.
- Bezpieczeństwo: Wybraliśmy narzędzia wyposażone w skuteczne funkcje bezpieczeństwa, chroniące poufne dane i zapewniające prywatność.
- Zdolność adaptacji: Wybraliśmy narzędzia na podstawie ich zdolności do obsługi różnych witryn internetowych itracŁatwe przesyłanie danych w różnych formatach.
- Społeczność: Nasz zespół wziął pod uwagę narzędzia z aktywnymi społecznościami i niezawodną obsługą klienta, aby skutecznie rozwiązywać problemy.
- Elastyczność: Wybraliśmy narzędzia umożliwiające personalizację, dzięki czemu mamy pewność, że spełniają one specyficzne potrzeby różnych użytkowników i projektów.
Czym jest web scratch?ping narzędzie i jak ono działa?
Scratch sieciowyping narzędzie żąda strony internetowej, odczytuje jej zawartość itracKonwertuje wybrane pola do formatu strukturalnego. Niektóre narzędzia analizują kod HTML bezpośrednio. Inne uruchamiają przeglądarkę, więc JavaSkrypt może zostać załadowany jako pierwszy. Zarządzane interfejsy API umożliwiają również rotację serwerów proxy, ponawianie zablokowanych żądań i zwracanie wyników przez jeden punkt końcowy. Przepływ pracy zazwyczaj rozpoczyna się od URL i extracReguła ta kończy się rekordami w formacie JSON, CSV lub bazie danych. Początkujący powinni najpierw zdecydować, czy potrzebują stron, pól strukturalnych, zrzutów ekranu, czy też wielokrotnego monitorowania. Ten wybór determinuje właściwy typ narzędzia.
Który model bezpłatnego dostępu jest odpowiedni dla Twojego web scracka?ping projekt?
Bezpłatny dostęp może oznaczać stały miesięczny limit, jednorazowe kredyty rejestracyjne, okres próbny lub płatną wersję ewaluacyjną. Modele te nie są zamienne. Plan odnawialny jest odpowiedni dla małych, powtarzających się zadań. Jednorazowe kredyty lepiej sprawdzają się przy testowaniu integracji. Okresowe wersje próbne pomagają szybko ocenić wsparcie i trudne cele. Płatne wersje próbne często zapewniają ruch proxy o wyższej jakości niż wersja bezpłatna. Sprawdź, czy wymagana jest karta, co zużywa kredyty i czy niewykorzystana pojemność wygasa. Najlepsza opcja jest dopasowana do częstotliwości żądań, docelowego poziomu trudności i tolerancji na późniejszą odbudowę.
Jakich funkcji należy szukać w web scracie?ping przybory?
Przydatne funkcje zależą od zadania, dlatego zacznij od celu i wymaganego wyniku. Te kontrole obejmują główne decyzje zakupowe:
- Rendering: JavaObsługa skryptów ma znaczenie, gdy wymagane dane pojawiają się po początkowej odpowiedzi HTML.
- Kontrola dostępu: Rotacja serwerów proxy, sesje i określanie lokalizacji decydują o tym, czy żądania dotrą do stron regionalnych czy chronionych.
- Wyjście: Formaty JSON, CSV, Markdown, zrzuty ekranu i surowy kod HTML zaspokajają różne potrzeby w zakresie analiz i dowodów.
- Operacje: Harmonogramowanie, ponowne próby, rejestry, alerty i limity wydatków umożliwiają obserwację i kontrolę powtarzających się zadań.
- Wsparcie: Przejrzysta dokumentacja i szybka reakcja pozwalają ograniczyć przestoje w przypadku zmiany celów lub reguł żądań.
Jak zrobić scraping Czym interfejsy API różnią się od serwerów proxy i narzędzi przeglądarkowych?
Bliznaping Interfejsy API zarządzają żądaniami, ponownymi próbami i często renderowaniem za jednym punktem końcowym. Są one odpowiednie dla zespołów, które chcą osiągać rezultaty bez konieczności obsługi infrastruktury sieciowej. Usługi proxy jedynie kierują ruchem, więc użytkownicy nadal potrzebują robotów indeksujących, parserów, pamięci masowej i obsługi błędów. Narzędzia przeglądarki działają. JavaSkryptuj i symuluj działania, takie jak klikanie czy przewijanie. Obsługują one strony interaktywne, ale zużywają więcej zasobów obliczeniowych. Wiele systemów produkcyjnych łączy te podejścia. Serwer proxy może obsługiwać niestandardowy robot indeksujący, podczas gdy zarządzana przeglądarka obsługuje trudne strony. Wybierz najmniej złożoną metodę, która niezawodnie zwróci wymagane dane.
W jaki sposób AI może ulepszyć scratchowanie stron internetowych?ping przepływy pracy?
Sztuczna inteligencja może tłumaczyć zapytania terenowe w języku potocznym na np.tracReguły encji, normalizacja nieuporządkowanych wartości i generowanie czystszego JSON lub Markdown. Może również pomóc w naprawie selektorów w przypadku zmiany układu strony. Te możliwości skracają czas konfiguracji, szczególnie w przypadku prototypów i badań. Nie eliminują jednak konieczności walidacji. Modele mogą błędnie oznaczać pola, pomijać ukrytą paginację lub scalać niepowiązane wartości. Zespoły powinny porównywać próbki ze stroną źródłową i monitorować zmiany w czasie. Sztuczna inteligencja najlepiej sprawdza się jako asystent w przypadku kontrolowanych żądań, przejrzystych schematów i powtarzalnych kontroli jakości.
Jak scratować sieć?ping narzędzia łączą się z przepływami danych?
Scratch sieciowyping Narzędzia zazwyczaj łączą się za pośrednictwem interfejsów API REST, zestawów SDK, webhooków, pamięci masowej w chmurze lub platform automatyzacji. Zaplanowane zadanie może zbierać strony, zapisywać rekordy w zestawie danych i wysyłać webhook potwierdzający ukończenie. Inna usługa może następnie walidować, transformować lub ładować dane do magazynu. Przepływy pracy AI coraz częściej wykorzystują dane wyjściowe MCP lub Markdown do dostarczania bieżących stron agentom badawczym. Integracja powinna również zawierać informacje o stanie wykonania, znacznikach czasu i błędach. Bez tego kontekstu systemy niższego szczebla nie są w stanie odróżnić nowych rekordów od niekompletnych lub nieudanych kolekcji.
Czy web scraping legalne i bezpieczne?
Scratch sieciowyping mogą być zgodne z prawem, ale legalność zależy od danych, metody dostępu, jurysdykcji i przeznaczenia. Odpowiedzialny projekt powinien dokumentować te kontrole:
- Dostęp publiczny: Gromadź wyłącznie te informacje, do których masz dostęp zgodnie z prawem i które są istotne dla określonego celu biznesowego lub badawczego.
- Zasady witryny: Revzobacz warunki korzystania z usługi, wskazówki dotyczące robotów,tracograniczenia formalne i obowiązujące przepisy lokalne przed rozpoczęciem zbierania danych.
- Dane osobiste: Ogranicz gromadzenie danych, zabezpiecz przechowywane dane i przestrzegaj zasad ochrony prywatności w odniesieniu do informacji identyfikujących.
- Żądanie obciążenia: Użyj rozsądnych stawek i buforowania, aby zautomatyzowany ruch nie zakłócał działania witryny docelowej.
- Recenzja prawna: Jeśli projekt obejmuje poufne dane, konta, uwierzytelnianie lub niejasne ograniczenia, zasięgnij porady fachowca.
Jak chronić sieć przed scratchem?ping jakość danych?
Jakość danych zaczyna się od przejrzystego schematu i reprezentatywnych stron testowych. Przed skalowaniem sprawdź poprawność typów pól, wymaganych wartości, paginacji, duplikatów i znaczników czasu. Zapisz małą próbkę surowych odpowiedzi obok przeanalizowanych rekordów, aby uniknąć błędów. tracMożliwe. Monitoruj liczbę rekordów i wskaźniki brakujących pól w różnych przebiegach. Zmiany układu często generują wiarygodne, ale nieprawidłowe wyniki, które trudniej wykryć niż nieudane żądanie. Wersja extracReguły nt. encji i porównuj próbki po każdej zmianie. W przypadku ważnych zestawów danych, przed opublikowaniem wniosków dodaj niezależne kontrole do zaufanych stron źródłowych.
Jak scratować sieć?ping koszty zmieniają się w miarę skalowania projektów?
Koszty rosną ze względu na liczbę żądań, renderowane strony, serwery proxy premium, współbieżność, pamięć masową i wsparcie. Jeden URL może zużyć kilka kredytów, gdy JavaWłączono skrypt, targetowanie lokalizacji lub zaawansowane pomijanie. Nieudane próby mogą być bezpłatne w przypadku niektórych interfejsów API, ale rozliczane w przypadku innych. Oblicz koszt na podstawie reprezentatywnej próby, a nie prostej liczby żądań. Uwzględnij czas pracy inżynierów na konserwację i monitorowanie parsera. Zarządzany interfejs API może kosztować więcej w przeliczeniu na wynik, a jednocześnie zmniejszyć nakład pracy operacyjnej. Ustaw limity wydatków, przejrzyj wykorzystanie według celu i oddziel eksperymenty od danych uwierzytelniających produkcję.
Jakie problemy powodują sieć ScraperJak sobie radzić z problemami i jak sobie z nimi radzić?
Scraperzwykle zawodzą z powodu zachowania strony, reguł dostępu lub np.tracZałożenia dotyczące cji uległy zmianie. Każda poprawka powinna odnosić się do zaobserwowanej przyczyny, a nie być powtarzana bezmyślnie.
- Kwestia: Strona zwraca pusty kod HTML, ponieważ treść ładuje się przez JavaSkrypt po pierwszej odpowiedzi.
Rozwiązanie: Operator powinien włączyć renderowanie w przeglądarce i poczekać na stabilny selektor przed wykonaniem operacji.tracwypełniając wymagane pola. - Kwestia: Powtarzające się żądania wyzwalają CAPTCHA, limity szybkości lub tymczasowe blokady podczas większych cykli pobierania opłat.
Rozwiązanie: Zespół powinien obniżyć prędkość żądań, stosować rotację odpowiednich serwerów proxy, ostrożnie wykorzystywać sesje ponownie i przestrzegać zasad dostępu witryny. - Kwestia: Przeprojektowana strona przenosi pola i po cichu wyświetla puste lub niezgodne wartości.
Rozwiązanie: Osoba utrzymująca powinna tworzyć wersje selektorów, przechowywać surowe próbki i wysyłać powiadomienia, gdy ilość uzupełnień w polach wymaganych spadnie poniżej uzgodnionego progu. - Kwestia: Paginacja zostaje zatrzymana przedwcześnie, przez co późniejsze produkty, komentarze lub oferty pozostają poza ostatecznym zestawem danych.
Rozwiązanie: Programista powinien przetestować logikę następnej strony, zapisać liczbę stron i porównać zebrane dane z widocznymi wskaźnikami źródłowymi. - Kwestia: Zużycie kredytów nieoczekiwanie wzrasta podczas renderowania, tras premium lub trudnych celów.
Rozwiązanie: Właściciel powinien najpierw oszacować liczbę reprezentatywnych żądań, ustalić limity wydatków i przydzielić kosztowne cele do monitorowanych przepływów pracy. - Kwestia: Duplikat URLPowtarzanie lub ponowne próby powodują powstawanie powtarzających się rekordów, które zniekształcają zliczenia i dalszą analizę.
Rozwiązanie: Potok powinien przypisywać stabilne klucze rekordów, normalizować URLi usuń duplikaty przed umieszczeniem rekordów w raportach lub pamięci masowej.
Jakie trendy będą kształtować web scratch?ping narzędzia dalej?
Scratch sieciowyping platformy przechodzą w kierunku rozwiązań sterowanych przez sztuczną inteligencjętraccja, połączenia agentów i bardziej elastyczna infrastruktura przeglądarki. Schematy języka prostego mogą skrócić konfigurację, a integracje MCP pozwalają agentom badawczym żądać bieżących stron za pomocą kontrolowanych narzędzi. Dostawcy łączą równieżping, wyszukiwanie, indeksowanie i działania przeglądarki za kontami współdzielonymi. Zgodność i pochodzenie danych będą zyskiwać na znaczeniu, ponieważ automatyczne gromadzenie danych wpływa na decyzje biznesowe. Pożytecznym trendem jest większa obserwowalność: zespoły potrzebują jasnych kosztów żądań, znaczników czasu źródłowych, np.tracwersje i przyczyny awarii. Lepsza automatyzacja powinna ułatwiać te kontrole, a nie je ukrywać.
Werdykt
Przejrzałem krótką listę pod kątem ograniczeń dostępu, głębokości przepływu pracy i wymagań skalowalności. Trzy opcje najlepiej pasowały do różnych zadań.ping wymagania.
- Oxylabs: Spodobała mi się jego zarządzana sieć Scraper API dla trudnych celów, ustrukturyzowanej dostawy i kontroli produkcji bez konieczności utrzymywania oddzielnej infrastruktury przeglądarki i serwera proxy.
- Dekodować: W mojej recenzji umieściłem go na pierwszym miejscu ze względu na łatwy dostęp do bezpłatnego API, przygotowane szablony, JavaRenderowanie skryptów i wyniki dostosowane do przepływów pracy związanych z danymi lub sztuczną inteligencją.
- NodeMaven: Wybrałem go dla zespołów, które już posiadają Scraping kodu i potrzebują szczegółowego określenia lokalizacji, kontroli rotacji i przeszukanych adresów proxy.
