
SAP DS (usługi danych) w HANA
 Masona Garcii
⚡ Inteligentne podsumowanie
SAP Data Services to platforma ETL dla przedsiębiorstw, która przenosi i oczyszcza dane z heterogenicznych źródeł do SAP HANA. Projektant, serwer zadań, silnik, repozytorium i serwer dostępu współpracują ze sobą, aby tworzyć, planować i uruchamiać przepływy danych.
Czym jest SAP Usługi danych?
SAP Data Services to narzędzie ETL zapewniające pojedyncze rozwiązanie na poziomie przedsiębiorstwa do integracji, transformacji, zapewniania jakości i profilowania danych oraz przetwarzania danych tekstowych z heterogenicznego źródła do docelowej bazy danych lub magazynu danych.
Aplikacje, nazywane zadaniami, są tworzone w Projektancie, gdzie mapowane są daneping i transformacja są zdefiniowane. Produkt jest również nazywany SAP Usługi danych BusinessObjects, w skrócie SAP BODS, przy czym obie nazwy opisują to samo narzędzie. SAP Aktualną wersją jest Data Services 4.3; zakończenie głównego wsparcia technicznego wersji 4.2 nastąpiło 31 maja 2023 r., więc nowe implementacje powinny rozpocząć się od wersji 4.3.
W ciągu SAP Krajobraz HANA, SAP Usługi danych to opcja wybierana, gdy dane muszą zostać przekształcone w trakcie przesyłania, a nie skopiowane w obecnej formie. Poniższe sekcje opisują, co oferuje narzędzie, jak jego części się ze sobą łączą oraz całkowite obciążenie robocze z SAP Tabela ECC do SAP HANA.
Cechy SAP Usługi danych
Poniższe możliwości wyjaśniają dlaczego SAP Usługa Data Services jest pozycjonowana jako platforma klasy korporacyjnej, a nie jako proste narzędzie do kopiowania.
- Zapewnia wysoką wydajność transformacji równoległych.
- Posiada kompleksowe narzędzia administracyjne i narzędzie do raportowania.
- Obsługuje wielu użytkowników.
- SAP BOD jest bardzo elastyczny w przypadku aplikacji bazujących na usługach sieciowych.
- Umożliwia użycie języka skryptowego z bogatym zestawem funkcji.
- SAP Usługi danych można zintegrować z SAP Serwer replikacji LT (SLT) wykorzystując technologię opartą na wyzwalaczach. SLT dodaje możliwości delty do każdego SAP lub nieSAP tabela źródłowa, która umożliwia przechwytywanie danych zmian i przesyłanie danych różnicowych z tabeli źródłowej.
- Walidacja danych za pomocą dashboardów i audyt procesów.
- Narzędzie administracyjne z możliwością planowania i panelami monitorującymi.
- Debugowanie, wbudowane profilowanie i przeglądanie danych.
- SAP Usługi danych obsługują szeroką gamę źródeł i celów:
- Dowolna aplikacja, na przykład SAP.
- Dowolna baza danych z możliwością masowego ładowania i przechwytywania zmian danych.
- Pliki: o stałej szerokości, rozdzielone przecinkami, COBOL, XML i przewyższać.
Funkcje te są realizowane za pośrednictwem niewielkiego zestawu instalowalnych komponentów, z których każdy pełni określoną rolę.
Części SAP Usługi danych
SAP Usługi danych zawierają poniższe komponenty.
- projektant – To narzędzie programistyczne, za pomocą którego możemy tworzyć, testować i wykonywać zadania wypełniające magazyn danych. Umożliwia ono programistom tworzenie obiektów i konfigurowanie ich poprzez wybranie ikony na diagramie przepływu od źródła do celu. Można go użyć do tworzenia aplikacji poprzez określenie przepływów pracy i danych. Aby otworzyć Projektanta usług danych, przejdź do Menu Start -> Wszystkie programy -> SAP Usługi danych -> Projektant usług danych.

- Serwer zadań – Jest to aplikacja uruchamiająca silnik przetwarzania usług danych i pełniąca funkcję interfejsu pomiędzy silnikiem a pakietem usług danych.
- silnik – Silnik usług danych wykonuje poszczególne zadania zdefiniowane w aplikacji.
- Magazyn – Repozytorium to baza danych, w której przechowywane są obiekty predefiniowane przez Projektanta oraz obiekty zdefiniowane przez użytkownika (metadane źródłowe i docelowe, reguły transformacji). Repozytoria dzielą się na dwa typy:
- Repozytorium lokalne (używane przez projektanta i serwer zadań).
- Centralne repozytorium (służy do współdzielenia obiektów i kontroli wersji).
- Dostęp do serwera – Serwer dostępu przesyła wiadomości pomiędzy aplikacjami internetowymi, serwerem zadań usług danych i silnikami.
- Administrator – Administrator witryny zapewnia administrację zasobami usług danych za pośrednictwem przeglądarki, szczegółowo opisaną poniżej:
- Konfigurowanie, uruchamianie i zatrzymywanieping usługi w czasie rzeczywistym.
- Planowanie, monitorowanie i wykonywanie zadań wsadowych.
- Konfigurowanie serwera zadań, serwera dostępu i korzystania z repozytorium.
- Zarządzanie użytkownikami.
- Publikowanie zadań wsadowych i usług w czasie rzeczywistym za pośrednictwem usług sieciowych.
- Konfigurowanie i zarządzanie adapterami.
Wiedza o tym, co robi każdy komponent, to tylko połowa sukcesu. Poniższa architektura pokazuje, jak komunikują się one podczas obciążenia.
SAP Usługi danych Architektura
Architektura usług danych składa się z następujących komponentów:
- Centralne repozytorium – służy do konfiguracji repozytoriów dla serwerów zadań, zarządzania bezpieczeństwem, kontroli wersji i udostępniania obiektów.
- Projektant – służy do tworzenia projektu, zadania, przepływu pracy i przepływu danych oraz do ich uruchamiania.
- Repozytorium lokalne – w tym miejscu możesz tworzyć, zmieniać i uruchamiać zadania, przepływy pracy i przepływy danych.
- Serwer i silnik zadań – zarządza zadaniami.
- Serwer dostępu – służy do wykonywania w czasie rzeczywistym zadań tworzonych przez programistów w repozytoriach.
Na poniższym obrazku przedstawiono usługi danych i relacje między ich komponentami.

SAP BOD Architektura
Szczegóły okna projektanta
Projektant to komponent, któremu programista poświęca najwięcej czasu, dlatego warto najpierw poznać jego układ. Poniżej znajduje się szczegółowy opis każdej sekcji Projektanta usług danych:
- Pasek narzędzi (używane do Otwórz, Zapisz, Wstecz, Sprawdź, Wykonaj itd.).
- Teren projektu (zawiera bieżący projekt, który obejmuje zadanie, przepływ pracy i przepływ danych. W usługach danych wszystkie jednostki są obiektami).
- Miejsce do pracy (obszar okna aplikacji, w którym definiujemy, wyświetlamy i modyfikujemy obiekty).
- Lokalna biblioteka obiektów (zawiera lokalne obiekty repozytorium, takie jak transformacje, zadania, przepływy pracy, przepływy danych itp.).
- Paleta narzędzi (przyciski na palecie narzędzi umożliwiają dodawanie nowych obiektów do obszaru roboczego).

Hierarchia obiektów
Poniższy diagram przedstawia hierarchiczne relacje pomiędzy najważniejszymi typami obiektów w ramach Usług danych.

Uwaga: Legenda poniżej identyfikuje opcjonalne elementy w hierarchii.

Przepływy pracy i warunki są opcjonalne.
Przedmioty używane w SAP Szczegóły usług danych podano poniżej.
| Obiekty | OPIS |
|---|---|
| Projekt | Projekt to obiekt najwyższego poziomu w oknie Projektanta. Projekty umożliwiają organizowanie innych obiektów tworzonych w Usługach danych. Jednocześnie otwarty jest tylko jeden projekt, gdzie „otwarty” oznacza „widoczny w obszarze projektu”. |
| Praca | „Zadanie” to najmniejsza jednostka pracy, której wykonanie można zaplanować niezależnie. |
| Skrypty | Podzbiór linii w procedurze. |
| Workflow | „Przepływ pracy” to połączenie kilku przepływów danych w spójny przepływ pracy dla całego zadania. Przepływ pracy jest opcjonalny. Przepływ pracy to procedura, która może:
|
| Przepływ danych | „Przepływ danych” to proces, w którym dane źródłowe są przekształcane w dane docelowe. Przepływ danych to obiekt wielokrotnego użytku. Jest zawsze wywoływany z przepływu pracy lub zadania. Służy do:
|
| Magazyn danych | Logiczny kanał łączący usługi danych z bazami danych źródłowymi i docelowymi. Magazyny danych:
|
| Target | Tabela lub plik, do którego Usługi danych ładują dane ze źródła. |
SAP Usługi danych kontra SLT kontra DXC
SAP Usługi danych to jedna z kilku dostarczanie danych opcje dla SAP HANA, a wybór niewłaściwej metody generuje dodatkowe koszty, których nie da się odzyskać poprzez żadne dostrajanie. Poniższa tabela porównuje trzy metody po stronie serwera.
| kryteria | SAP Usługi danych | SLT | DXC |
|---|---|---|---|
| Utajenie | Partiami lub zaplanowane | W czasie rzeczywistym | Partia, zaplanowana przez DataSource |
| Transformacja | Pełne ETL, oczyszczanie i profilowanie | Proste reguły filtrowania i pól | Żaden poza extraclogika tor |
| Zakres źródła | SAP i nieSAP, pliki, aplikacje | SAP i nieSAP Bazy danych | SAP Tylko apartament biznesowy |
| Wymagany dodatkowy serwer | Tak, serwer zadań | Zwykle tak | Nie |
| Najlepiej nadaje się do | Jakość danych i konsolidacja wieloźródłowa | Operaraportowanie krajowe na podstawie danych na żywo | Ponowne wykorzystanie istniejącej zawartości biznesowej, np.tractorsy |
Krótko mówiąc, wybierz SAP Usługi danych, gdy dane muszą zostać oczyszczone, połączone lub ujednolicone przed ich dostarczeniem. Wybierz SLT, gdy raport musi odzwierciedlać transakcję w trakcie jej trwania. DXC gdy sprawdzony ekspert ds. treści biznesowychtracTor już generuje potrzebną semantykę. W przypadku jednorazowego zbioru danych bez harmonogramu powtarzania, przesyłanie pliku płaskiego jest szybsza niż konfigurowanie którejkolwiek z trzech metod.
Jak załadować dane z SAP Tabela źródłowa używana SAP Usługi danych
Wszystko w usługach danych jest obiektem. Dla każdej bazy danych źródłowej i docelowej potrzebny jest osobny magazyn danych.
Pełna sekwencja ładowania danych z SAP Poniżej znajduje się tabela źródłowa. Następnie szczegółowo opisano każdy krok.
- Utwórz magazyn danych pomiędzy źródłem a BODS
- Importuj metadane (struktury) do BODS
- Skonfiguruj serwer importu
- Importuj metadane do systemu HANA
- Utwórz magazyn danych pomiędzy BODS i HANA
- Utwórz projekt
- Utwórz zadanie (wsadowe lub w czasie rzeczywistym)
- Utwórz przepływ pracy
- Utwórz przepływ danych
- Dodaj obiekty do przepływu danych
- Wykonaj zadanie
- Sprawdź podgląd danych w HANA
Krok 1) Utwórz magazyn danych pomiędzy SAP źródło i BODS.
- Aby załadować dane z SAP źródło do SAP HANA przez SAP BODS, wymagany jest magazyn danych. Dlatego najpierw tworzymy magazyn danych, jak pokazano poniżej – Projekt -> Nowy -> Magazyn danych

- Pojawi się okno dialogowe „Utwórz nowy magazyn danych”. Wprowadź dane jak poniżej:
- Wprowadź nazwę magazynu danych „ds_ecc”.
- Wybierz nazwę typu magazynu danych jako „SAP Aplikacje".
- Wprowadź nazwę serwera bazy danych.
- Wprowadź nazwę użytkownika i hasło.
- Kliknij przycisk „Zastosuj”.
- Kliknij przycisk „OK”.

- Magazyn danych zostanie utworzony. Zobacz utworzony magazyn danych poniżej.
- Przejdź do biblioteki obiektów lokalnych.
- Wybierz kartę Magazyn danych.
- Wyświetlony zostanie magazyn danych „ds_ecc”.

Krok 2) Importuj metadane (strukturę) do serwera BODS.
Utworzyliśmy magazyn danych dla ECC do BODS; teraz importujemy metadane z ECC do BODS. Aby zaimportować, wykonaj poniższe kroki.
- Wybierz magazyn danych „ds_ecc” i kliknij prawym przyciskiem myszy.
- Wybierz opcję Importuj według nazwy.

Wyświetli się okno dialogowe Importuj według nazwy. Wprowadź dane jak poniżej:
- Wybierz opcję Typ jako tabela.
- Wprowadź nazwę tabeli do zaimportowania. Tutaj importujemy tabelę KNA1.
- Kliknij przycisk „Importuj”. Tabela KNA1 pojawi się pod węzłem „Tabela” źródła danych „ds_ecc”.

Metadane tabeli zostaną zaimportowane do magazynu danych ds_ecc w sposób pokazany poniżej.

Krok 3) Skonfiguruj serwer importu.
Do tej pory zaimportowaliśmy tabelę do magazynu danych „ds_ecc” utworzonego dla ECC, aby SAP Połączenie BODS. Aby zaimportować dane do SAP HANA, musimy skonfigurować serwer importu.
- Aby to zrobić, przejdź do Szybki podgląd -> Konfiguruj serwer importu jak poniżej.

- Pojawi się okno dialogowe Wybierz system. Wybierz SAP System HANA (tutaj HDB) jak poniżej.

- Kliknij przycisk „Dalej”. Pojawi się kolejne okno z danymi uwierzytelniającymi do usług danych. Wprowadź następujące dane:
- SAP Adres serwera BODS (tutaj BODS:6400).
- SAP Nazwa repozytorium BODS (nazwa repozytorium HANAUSER).
- Źródło danych ODBC (ZTDS_DS).
- Domyślny port dla SAP Serwer BODS (8080).

Kliknij przycisk „Zakończ”.
Krok 4) Zaimportuj metadane do systemu HANA.
Serwer importu jest teraz skonfigurowany, więc metadane można importować z SAP Serwer BODS.
- Kliknij opcję Importuj w Szybkim podglądzie.
- Wyświetli się okno dialogowe z opcjami importu. Wybierz opcję „Selektywny import metadanych”.

Kliknij przycisk „Dalej”.
Wyświetli się okno dialogowe „Selektywnego importu metadanych”, w którym należy wybrać system docelowy.
- Wybierz SAP System HANA (tutaj HDB).

Kliknij przycisk „Dalej”.
Krok 5) Utwórz magazyn danych pomiędzy BODS i HANA.
W systemie BODS wymagany jest oddzielny magazyn danych dla systemu źródłowego i docelowego. Magazyn źródłowy już istnieje, dlatego między systemem BODS a systemem HANA tworzony jest magazyn docelowy o nazwie „DS_BODS_HANA”.
- Przejdź do Projekt -> Nowy -> Datastore.
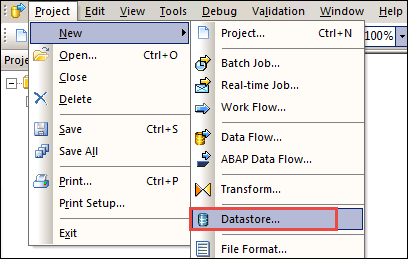
- Zostanie wyświetlony ekran umożliwiający utworzenie nowego magazynu danych, taki jak poniżej.
- Wprowadź nazwę magazynu danych (DS_BODS_HANA).
- Wprowadź typ magazynu danych jako Bazę danych.
- Wprowadź typ bazy danych jako SAP HANA.
- Wybierz wersję bazy danych.
- Wpisz SAP Nazwa serwera bazy danych HANA.
- Wprowadź nazwę portu dla SAP baza danych HANA.
- Wprowadź nazwę użytkownika i hasło.
- Zaznacz „Włącz automatyczne przesyłanie danych”.

Kliknij „Zastosuj”, a następnie przycisk „OK”.
Magazyn danych „DS_BODS_HANA” zostanie wyświetlony na karcie Magazyn danych w Bibliotece obiektów lokalnych, jak pokazano poniżej.

- Teraz importujemy tabelę do magazynu danych „DS_BODS_HANA”.
- Wybierz magazyn danych „DS_BODS_HANA” i kliknij prawym przyciskiem myszy.
- Wybierz opcję Importuj według nazwy.

- Pojawi się poniższe okno dialogowe Importuj według nazwy.
- Wybierz opcję Typ jako tabela.
- Wpisz nazwę KNA1.
- Właściciel będzie wyświetlany jako Hanauser.
- Kliknij przycisk Importuj.

Tabela zostanie zaimportowana do magazynu danych „DS_BODS_HANA”. Aby wyświetlić dane w tabeli, wykonaj poniższe kroki.
- Kliknij tabelę „KNA1” w magazynie danych „DS_BODS_HANA”.
- Dane zostaną wyświetlone w formie tabeli.

Krok 6) Zdefiniuj projekt. Projekt grupuje i organizuje powiązane obiekty. Projekt może zawierać dowolną liczbę zadań, przepływów pracy i przepływów danych.
- Przejdź do menu Projektanta.
- Wybierz opcję Nowy.
- Wybierz opcję Projekt.

Pojawi się okno dialogowe tworzenia nowego projektu, jak poniżej. Wprowadź nazwę projektu i kliknij przycisk Utwórz. Spowoduje to utworzenie folderu projektu, w naszym przypadku BODS_DHK.

Krok 7) Określ zadanie. Zadanie to obiekt wielokrotnego użytku. Zawiera przepływy pracy i przepływy danych. Zadania mogą być wykonywane ręcznie lub według harmonogramu. Aby wykonać proces BODS, należy zdefiniować zadanie.
Tworzymy zadanie o nazwie JOB_Customer.
- Wybierz projekt (BODS_DHK) utworzony w poprzednim kroku, kliknij prawym przyciskiem myszy i wybierz opcję „Nowe zadanie wsadowe”.
- Zmień jego nazwę na „JOB_Customer”.

Krok 8) Określ przepływ pracy.
- Wybierz zadanie „JOB_Customer” w obszarze projektu.
- Kliknij przycisk przepływu pracy na palecie narzędzi. Kliknij pusty obszar roboczy. W obszarze roboczym pojawi się ikona przepływu pracy.
- Zmień nazwę przepływu pracy na „WF_Customer”.

Kliknij nazwę przepływu pracy, a w obszarze roboczym pojawi się pusty widok przepływu pracy.

Krok 9) Zdefiniuj przepływ danych.
- Kliknij na przepływ pracy „WF_Customer”.
- Kliknij przycisk przepływu danych na palecie narzędzi. Kliknij pusty obszar roboczy. W obszarze roboczym pojawi się ikona przepływu danych.
- Zmień nazwę przepływu danych na „DF_Customer”.
- Przepływ danych jest widoczny również w obszarze projektu po lewej stronie, pod nazwą zadania.

Krok 10) Dodaj obiekty do przepływu danych.
Wewnątrz przepływu danych podajemy instrukcje dotyczące przekształcania danych źródłowych do pożądanej formy dla tabeli docelowej.
Używane są trzy obiekty:
- Obiekt dla źródła.
- Obiekt dla tabeli docelowej.
- Obiekt dla transformacji zapytania, który mapuje kolumny ze źródła na cel.
Kliknij przepływ danych DF_Customer. Pojawi się pusty obszar roboczy, jak poniżej.
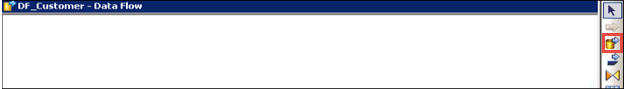
- Określ obiekt dla źródła – Przejdź do magazynu danych „ds_ecc”, wybierz tabelę KNA1 i przeciągnij ją i upuść na pusty ekran przepływu danych.
- Określ obiekt docelowy – Wybierz magazyn danych „DS_BODS_HANA” z repozytorium i wybierz tabelę KNA1.
- Przeciągnij i upuść na obszar roboczy i wybierz opcję „Utwórz” Target” opcja. Teraz będą dwie tabele: jedna źródłowa i jedna docelowa.

- Transformacja zapytania – Narzędzie służące do pobierania danych na podstawie schematu wejściowego dla konkretnego warunku użytkownika oraz do przesyłania danych ze źródła do celu.
- Wybierz ikonę Transformacja zapytania z palety narzędzi, a następnie przeciągnij ją i upuść między obiektem źródłowym i docelowym w obszarze roboczym.
- Połącz obiekt zapytania ze źródłem.
- Połącz obiekt zapytania z tabelą docelową.

Double- Kliknij ikonę zapytania, aby zamapować kolumny ze schematu wejściowego na schemat wyjściowy. Mapaping pojawia się okno, w którym wykonujemy następujące czynności:
- Wybrano tabelę źródłową KNA1.
- Zaznacz wszystkie kolumny w tabeli źródłowej, kliknij prawym przyciskiem myszy i wybierz Mapuj na dane wyjściowe.
- Jako wynik docelowy wybrano Zapytanie, a kolumny zostaną zamapowane.

Zapisz i zatwierdź projekt. Kliknij ikonę „Weryfikuj”. Pojawi się okno z potwierdzeniem pomyślnej weryfikacji.

Krok 11) Wykonaj zadanie. Aby wykonać zadanie, postępuj zgodnie ze ścieżką poniżej.
- Wybierz ikonę obszaru projektu, aby otworzyć projekt i wybierz utworzony projekt.
- Wybierz zadanie i kliknij prawym przyciskiem myszy.
- Wybierz opcję Wykonaj, aby wykonać zadanie.
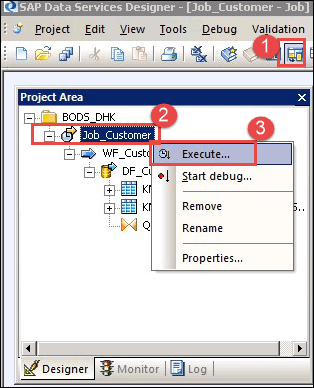
Po wykonaniu zadania wyświetlane jest okno dziennika zadań, w którym pojawiają się wszystkie komunikaty dotyczące zadania. Ostatnim komunikatem będzie „Zadanie zostało pomyślnie zakończone”.

Krok 12) Sprawdź i zweryfikuj dane w SAP baza danych HANA.
- Zaloguj się, aby SAP Baza danych HANA poprzez SAP Studio HANAi wybierz schemat HANAUSER.
- Wybierz tabelę KNA1 w węźle Tabela.
- Kliknij prawym przyciskiem myszy tabelę KNA1 i wybierz opcję Otwórz podgląd danych.
- Dane KNA1 załadowane przez proces BODS zostaną wyświetlone na ekranie podglądu danych.

Zgodna liczba wierszy w tabeli źródłowej i tym podglądzie potwierdza, że ładowanie zostało ukończone prawidłowo. Następnie Administrator może zaplanować zadanie do powtórzenia.
