
Co to jest testowanie regeneracji? z Przykładem
 Zespół redakcyjny
⚡ Inteligentne podsumowanie
Testowanie odzyskiwania danych ma na celu sprawdzenie, czy oprogramowanie może wznowić normalne działanie po awarii, zerwaniu połączenia sieciowego lub awarii sprzętu, poprzez przywrócenie systemu do znanego, prawidłowego stanu i ponowne przetworzenie transakcji do momentu awarii.
Czym jest testowanie odzyskiwania?
Testowanie odzyskiwania To technika testowania oprogramowania, która weryfikuje zdolność oprogramowania do odzyskiwania danych po awariach, takich jak awarie oprogramowania lub sprzętu oraz awarie sieci. Celem testowania odzyskiwania danych jest ustalenie, czy oprogramowanie może kontynuować działanie po awarii lub utracie integralności. Testowanie odzyskiwania danych polega na przywróceniu oprogramowania do stanu, w którym integralność była znana, oraz ponownym przetworzeniu transakcji do momentu awarii.
W inżynierii oprogramowania testowanie odzyskiwalności jest rodzajem testy niefunkcjonalne — obejmuje aspekty niezwiązane z konkretną funkcją lub działaniem użytkownika, takie jak skalowalność czy bezpieczeństwo. Jest on wykonywany przez profesjonalnych testerów, a odpowiednie dane zapasowe są wcześniej przechowywane w bezpiecznych lokalizacjach.
Przykład testowania odzyskiwania
Dwa scenariusze ilustrują tę technikę w najprostszej postaci. W każdym z nich celowo wymuszono awarię, a następnie obserwowano wznowienie działania aplikacji.
- Przerwa w sieci: Gdy aplikacja odbiera dane z sieci, odłącz kabel połączeniowy. Po pewnym czasie podłącz go ponownie i sprawdź, czy aplikacja może nadal odbierać dane od momentu zerwania połączenia.
- Przywracanie sesji: Uruchom ponownie system, gdy przeglądarka ma otwartą określoną liczbę sesji, i sprawdź, czy przeglądarka odzyska je wszystkie.
Poniższa ilustracja przedstawia tę samą ideę w formie wizualnej.
Czas potrzebny na regenerację zależy od:
- Liczba punktów ponownego uruchomienia
- Ilość danych przechowywanych przez aplikację
- Szkolenia i umiejętności osób prowadzących działania naprawcze oraz dostępne narzędzia do odzyskiwania
W przypadku wystąpienia kilku awarii testy odzyskiwania danych należy przeprowadzać w sposób ustrukturyzowany, a nie wszystkie naraz — najpierw dla jednego segmentu, a potem dla kolejnego.
Cykl życia procesu odzyskiwania
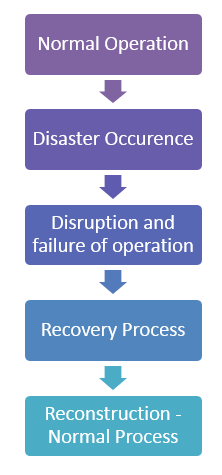
Przed zaprojektowaniem przypadków testowych warto ustalić, gdzie interweniuje test odzyskiwania. Cykl życia procesu odzyskiwania składa się z pięciu etapów:
- Normalna operacja
- Wystąpienie katastrofy
- Zakłócenie i awaria operacji
- Usuwanie awarii poprzez proces odzyskiwania
- Rekonstrukcja wszystkich procesów i informacji, przywrócenie całego systemu do normalnego działania
Poniższy schemat blokowy przedstawia kolejność tych pięciu etapów.
Omówmy szczegółowo te pięć kroków:
- Normalna praca. System składający się ze sprzętu, oprogramowania i oprogramowania sprzętowego, zintegrowany w celu osiągnięcia wspólnego celu, wykonuje zaprojektowane zadanie bez zakłóceń w ustalonym czasie.
- Wystąpienie katastrofy. Do zakłóceń może dojść z powodu nieprawidłowego działania oprogramowania, np. awarii wywołanej przez wejście danych, awarii spowodowanej awarią sprzętu lub uszkodzenia powstałego na skutek pożaru, kradzieży lub strajku.
- Zakłócenia i awarie. To najbardziej bolesna faza, prowadząca do strat biznesowych, zerwanych relacji, utraconych możliwości, straconych godzin pracy i, nieuchronnie, strat finansowych i utraty wartości firmy. Plan odzyskiwania po awarii minimalizuje ten etap.
- Usuwanie skutków katastrofy. Jeśli plan zapasowy i procesy ograniczania ryzyka są już wdrożone, odzyskiwanie danych zajmuje znacznie mniej czasu i wysiłku. Wyznaczony zespół, którego rola każdej osoby jest z góry określona, ustala zakres odpowiedzialności i zapobiega długim okresom zakłóceń.
- Rekonstrukcja. Może to wymagać wielu sesji operacji w celu odbudowania wszystkich folderów wraz z plikami konfiguracyjnymi. Do prawidłowego odzyskiwania wymagana jest odpowiednia dokumentacja i zdefiniowany proces rekonstrukcji.
Strategia renowacji
Zespół ds. odzyskiwania danych powinien mieć własną strategię odzyskiwania ważnego kodu i danych, aby przywrócić normalne funkcjonowanie. Strategia ta jest unikalna dla każdej organizacji i zależy od krytyczności obsługiwanych systemów, a w przypadku systemów krytycznych sprowadza się do zestawu wyborów:
- Pojedyncza kopia zapasowa lub więcej niż jedna
- Wiele kopii zapasowych w jednym miejscu lub w różnych miejscach
- Kopia zapasowa online lub offline
- Kopie zapasowe są tworzone automatycznie zgodnie z polityką lub uruchamiane ręcznie
- Niezależny zespół restauracyjny lub zespół programistów wykonujący pracę
Każdy wybór wiąże się z kosztami, a wiele kopii zapasowych może pochłaniać więcej zasobów fizycznych lub wymagać niezależnego zespołu. Zależność również ma znaczenie: firmy są narażone na ryzyko poprzez kod i dane przechowywane u jednego dostawcy, a także na dużą skalę. AWS Awarie wielokrotnie powodowały, że znane usługi konsumenckie były niedostępne w tym samym momencie. W takich przypadkach kluczowe jest niezależne przywracanie usług.
Jak przeprowadzić test odzyskiwania
Strategia ustalona, teraz pozostaje pytanie, jak skonfigurować sam test. Podczas przeprowadzania testów odzyskiwania należy wziąć pod uwagę następujące kwestie.
- Stwórz środowisko testowe możliwie najbardziej zbliżone do rzeczywistych warunków wdrożenia: interfejs, protokół, oprogramowanie sprzętowe, sprzęt i oprogramowanie powinny być zgodne ze środowiskiem produkcyjnym.
- Mimo że dokładne testowanie może być czasochłonne i kosztowne, nadal należy wykonać identyczną konfigurację i dokładną kontrolę.
- Jeżeli to możliwe, przetestuj na sprzęcie, na który ostatecznie zostanie przywrócona kopia zapasowa — zwłaszcza jeśli przywracasz dane na innym komputerze niż ten, na którym utworzono kopię zapasową.
- Niektóre systemy tworzenia kopii zapasowych wymagają, aby dysk twardy miał dokładnie taki sam rozmiar jak dysk, z którego została pobrana kopia zapasowa.
- Zarządzaj przestarzałością: technologia napędów rozwija się szybko, a stary dysk może nie być kompatybilny z nowym. Przywracanie do Maszyna wirtualna pomaga, ponieważ oprogramowanie do wirtualizacji może imitować istniejący sprzęt, w tym rozmiary dysków.
- Systemy tworzenia kopii zapasowych online nie są wyjątkiem od tej reguły. Większość dostawców chroni użytkowników przed problemami z nośnikami poprzez odporne na błędy systemy pamięci masowej, dzięki czemu awarie ujawniają się późno.
- Mimo że systemy tworzenia kopii zapasowych online są niezwykle niezawodne, strona przywracania danych musi zostać przetestowana, aby upewnić się, że nie występują żadne problemy z odzyskiwaniem, bezpieczeństwem lub szyfrowaniem.
Ponieważ odzyskiwanie jest ćwiczeniem kompleksowym, te przebiegi są zwykle planowane równolegle testowanie systemu a nie na poziomie jednostki.
Procedura testowania po renowacji
Przywrócenie danych to dopiero połowa sukcesu; przywrócona kopia musi zostać udowodniona jako użyteczna. Większość dużych korporacji zleca niezależnym audytorom okresowe przeprowadzanie ćwiczeń odzyskiwania danych. Kompleksowy plan odzyskiwania po awarii jest kosztowny w utrzymaniu i testowaniu, dlatego mniejsze organizacje często polegają na kopiach zapasowych i zewnętrznej pamięci masowej.
Po przywróceniu folderów i plików poniższe kontrole potwierdzą, czy zostały one prawidłowo odzyskane:
- Zmień nazwę uszkodzonego folderu dokumentu, aby nie można było pomylić z nim przywróconej kopii.
- Policz pliki w przywróconych folderach i porównaj tę liczbę z liczbą plików w oryginalnym folderze.
- Otwórz kilka plików za pomocą aplikacji, która normalnie z nich korzysta, i sprawdź, czy dane można przeglądać i aktualizować jak zwykle.
- Otwórz kilka plików różnego typu — zdjęcia, MP3i dokumenty, niektóre duże, niektóre małe.
- Użyj narzędzi do porównywania plików i katalogów, które są najczęściej używane system operacyjny zapewniać.
