
Samouczek dotyczący narzędzia Hadoop Pig: Co to jest Apache Pig? Architektura, przykład
 Prafulli Ranadive
⚡ Inteligentne podsumowanie
Apache Pig to platforma wysokiego poziomu do analizy dużych zestawów danych w systemie Hadoop, łącząca język przepływu danych Pig Latin ze środowiskiem wykonawczym, które kompiluje każdy skrypt do MapReduce, Tez lub Spark zadania automatycznie.
W tym samouczku zaczynamy od przedstawienia idei stojącej za Apache Pig, a następnie przechodzimy przez proces jego instalacji i uruchamiania kompletnego skryptu Pig Latin.
Co to jest świnia Apache?
Świnia jest na wysokim poziomie język programowania Przydatny do analizy dużych zbiorów danych. Pig był efektem prac rozwojowych w Yahoo!
W frameworku MapReduce programy muszą zostać przetłumaczone na serię etapów Map i Reduce. Nie jest to jednak model programowania, z którym analitycy danych są zaznajomieni. Aby więc wypełnić tę lukę, potrzebny jest…tracna szczycie zbudowano konstrukcję zwaną Świnką Hadoop.
Apache Pig pozwala użytkownikom skupić się bardziej na analizie dużych zbiorów danych i poświęcać mniej czasu na pisanie programów MapReduce. Podobnie jak świnie, które jedzą wszystko, język programowania Apache Pig został zaprojektowany do pracy z dowolnym rodzajem danych. Stąd nazwa – Pig! Maskotka projektu poniżej ma to samo przesłanie.

Projekt jest nadal aktywny. Apache Pig 0.18.0 została wydana 15 września 2025 r. i dodaje obsługę Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 i Python 3 r. zgodnie z Strona wydań Apache PigPoniższy opis został pierwotnie napisany dla znacznie starszej wersji 0.12.1, dlatego w kilku krokach zawarto uwagę na to, że bieżąca wersja zachowuje się inaczej.
Świnia Architektura
Architektura Pig składa się z dwóch komponentów:
- świnia łacina, który jest językiem
- Środowisko uruchomieniowe, do uruchamiania programów Pig Latin.
Program Pig Latin składa się z serii operacji lub transformacji, które są stosowane do danych wejściowych w celu wygenerowania danych wyjściowych. Operacje te opisują przepływ danych, który jest tłumaczony na reprezentację wykonywalną przez środowisko wykonawcze Hadoop Pig. Poniżej, wyniki tych transformacji to seria MapaReduce zadania, o których programista nie ma pojęcia. W pewnym sensie Pig w Hadoopie pozwala programiście skupić się na danych, a nie na naturze wykonania.
Pig Latin to stosunkowo sztywny język, który wykorzystuje znane słowa kluczowe z przetwarzania danych, np. „Dołącz”, „Grupuj” i „Filtruj”. Diagram poniżej tracto skrypt z powłoki Grunt przechodzący przez parser, optymalizator i kompilator w drodze do silnika wykonawczego.

Tryby wykonania
Pig w Hadoop ma dwa tryby wykonywania, a poniższy opis instalacji wykorzystuje oba z nich:
- Tryb lokalny: W tym trybie język Hadoop Pig działa w trybie pojedynczym FMV i korzysta z lokalnego systemu plików. Ten tryb nadaje się tylko do analizy małych zbiorów danych z użyciem Pig w Hadoop.
- Tryb MapReduce: W tym trybie zapytania napisane w Pig Latin są tłumaczone na zadania MapReduce i uruchamiane w klastrze Hadoop (klaster może być pseudorozproszony lub w pełni rozproszony). Tryb MapReduce z w pełni rozproszonym klastrem jest przydatny do uruchamiania Pig na dużych zbiorach danych.
Te dwa to klasyczna para. Obecne wersje udostępniają sześć typów wykonania, czyli typów wykonania, każdy wybierany z tą samą -x flaga, jak udokumentowano w Przewodnik wprowadzający do Pig 0.18.0.
| Typ wykonania | Command | Gdzie przebiega praca |
|---|---|---|
| Lokalny | pig -x lokalny | Pojedyncza maszyna wirtualna Java w stosunku do lokalnego systemu plików |
| Tez lokalny | świnia -x tez_local | Pojedyncza maszyna wirtualna Java (JVM) wykorzystująca środowisko wykonawcze Tez (eksperymentalne) |
| Spark miejscowy | świnia -x spark_local | Pojedyncza maszyna wirtualna Java (JVM) wykorzystująca Spark środowisko wykonawcze (eksperymentalne) |
| MapaReduce | świnia lub świnia -x mapreduce | Klaster Hadoop z HDFS; jest to ustawienie domyślne |
| Tez | świnia -x tez | Klaster Hadoop obsługujący silnik Tez |
| Spark | świnia -x iskra | A Spark, Klaster YARN lub Mesos z HDFS |
Typy danych łacińskich dla świń i Operatorsy
Przed napisaniem skryptu warto wiedzieć, co Pig może przechowywać i co może z tym zrobić. Model danych jest w pełni zagnieżdżony, co pozwala Pig odczytywać pliki dziennika i inne luźno ustrukturyzowane dane wejściowe, które tabela relacyjna odrzuciłaby.
Pig Latin oferuje dwie rodziny typów:
- Typy skalarne:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerorazbigdecimal. Przykładowy skrypt deklaruje później każdą kolumnę jakochararray. - Typy złożone: a krotka jest uporządkowanym zbiorem pól i zachowuje się jak wiersz; torba jest nieuporządkowaną kolekcją krotek i zachowuje się jak tabela; mapa jest zbiorem par klucz-wartość, których kluczem musi być
chararray.
Operatorzy zajmują się niewielką liczbą zadań, a garstka z nich zajmuje się niemal każdym rurociągiem:
| OperaTor | Co to robi |
|---|---|
| ZAŁADUJ / PRZECHOWYWAJ | Odczytaj relację z systemu plików i zapisz wynik |
| FILTER | Zachowaj tylko krotki spełniające warunek |
| FOREACH … GENERUJ | Pracuj kolumna po kolumnie, budując nowe pola |
| GRUPA / WSPÓŁGRUPA | Grupuj jedną relację lub dwie lub więcej relacji według klucza |
| DOŁĄCZ | Połącz relacje za pomocą połączenia wewnętrznego lub zewnętrznego |
| UNION / SPLIT | Połącz relacje lub podziel jedną na kilka |
| Sortuj według / Wyraźnie / Limit | Sortuj, usuwaj duplikaty i ograniczaj liczbę krotek |
| WYRZUĆ / OPISZ / WYJAŚNIJ / ZILUSTRATUJ | Przejrzyj wyniki, schematy, plany wykonania i przykładowe przebiegi |
Czterech operatorów inspekcyjnych ma również skróty Grunt, co oszczędza czasping podczas debugowania: \d do zrzutu, \de do OPISANIA, \e do WYJAŚNIENIA i \i dla ILLUSTRATE.
Wymagania wstępne
Pig to narzędzie po stronie klienta. Analizuje skrypt, planuje pracę i wysyła zadania, ale nie zapewnia własnej pamięci masowej ani klastra, dlatego najpierw musi istnieć działająca instalacja Hadoop. Lista wymagań Apache jest krótka.
| Składnik | Wymaganie | Dlaczego jest to potrzebne |
|---|---|---|
| Hadoop | Hadoop 2.x lub 3.x z wyeksportowanym HADOOP_HOME | Dostarcza HDFS i silnik wykonawczy. Bez HADOOP_HOME Pig 0.18.0 powraca do osadzonego Hadoop 2.7.3. |
| Java | Java 1.7 lub nowszy z JAVA_HOME ustawionym na katalog główny instalacji | Pig i demony Hadoop są Java programów |
| Python (opcjonalne) | Python 2.7 | Potrzebne tylko do streamingu Python funkcje zdefiniowane przez użytkownika |
| Mrówka (opcjonalnie) | Mrówka 1.8 | Potrzebne tylko podczas budowania lub rekompilowania Pig ze źródła |
Obok tej listy znajdują się dwie praktyczne wskazówki. Po pierwsze, uruchom wszystko jako użytkownik Linuksa, który ma już katalog domowy w HDFS i pozwolenie na zapisywanie do niego; ten samouczek wykorzystuje hduser, konto utworzone podczas konfiguracji Hadoop. Po drugie, uruchom klaster przed uruchomieniem Pig w trybie MapReduce, ponieważ Pig natychmiast przestanie działać, jeśli NameNode i ResourceManager są wyłączone. Jeśli Hadoop nie jest jeszcze zainstalowany, wykonaj następujące czynności. jak zainstalować Hadoop pierwszy.
Jak pobrać i zainstalować Pig
Teraz w tym samouczku Apache Pig dowiemy się, jak pobrać i zainstalować Pig:
Zanim rozpoczniemy właściwy proces, upewnij się, że masz zainstalowany Hadoop. Zmień użytkownika na „hduser” (identyfikator używany podczas konfiguracji Hadoop; możesz zmienić identyfikator użytkownika używany podczas własnej konfiguracji Hadoop).

Krok 1) Pobierz najnowszą, stabilną wersję Pig Hadoop z dowolnej witryny lustrzanej dostępnej pod adresem
https://pig.apache.org/releases.html
Wybierz plik tar.gz (a nie src.tar.gz) do pobrania, jak pokazano poniżej.

Krok 2) Po zakończeniu pobierania przejdź do katalogu zawierającego pobrany plik tar i przenieś go do lokalizacji, w której chcesz skonfigurować Pig Hadoop. W tym przypadku przeniesiemy go do /usr/local.

Przejdź do katalogu, w którym będą znajdować się pliki Pig Hadoop.
cd /usr/local
Extraczawartość pliku tar jak poniżej.
sudo tar -xvf pig-0.12.1.tar.gz

Krok 3) Zmodyfikuj ~/.bashrc, aby dodać zmienne środowiskowe związane z Pig.
Otwórz plik ~/.bashrc w dowolnym edytorze tekstu i wprowadź poniższe modyfikacje.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Krok 4) Teraz skonfiguruj środowisko za pomocą poniższego polecenia.
. ~/.bashrc

Krok 5) Musimy przekompilować Pig, aby obsługiwał Hadoop 2.2.0.
Oto jak to zrobić.
Przejdź do katalogu domowego Pig.
cd $PIG_HOME
Zainstaluj Ant.
sudo apt-get install ant

Uwaga: Rozpocznie się pobieranie, którego czas zależy od szybkości Twojego łącza internetowego.
Przekompiluj Pig.
sudo ant clean jar-all -Dhadoopversion=23

Należy pamiętać, że w procesie ponownej kompilacji pobieranych jest wiele komponentów, dlatego system powinien być połączony z internetem.
Jeśli proces utknie w jakimś miejscu i przez ponad 20 minut nie zobaczysz żadnego ruchu w wierszu poleceń, naciśnij Ctrl + c i uruchom ponownie to samo polecenie.
W naszym przypadku trwa to 20 minut.

Ten krok ponownej kompilacji należy do ery 0.12.1, kiedy dostarczane pliki jar były kompilowane w oparciu o Hadoop 1 i -Dhadoopversion=23 Flaga przełączyła kompilację Anta na linię Hadoop 0.23 i 2.x. Apache Pig 0.18.0 zawiera pliki binarne, które działają już na Hadoop 2.7 i nowszych, a także na Hadoop 3, więc w obecnej wersji zazwyczaj można rozpakować archiwum tarball i przejść bezpośrednio do testu poniżej.
Krok 6) Przetestuj instalację Pig za pomocą polecenia
pig -help

Przykładowy skrypt świni
Po zainstalowaniu Pig, reszta tego samouczka Apache Pig uruchamia kompletny skrypt. Użyjemy skryptów Pig, aby znaleźć liczbę produktów sprzedanych w każdym kraju.
Dane wejściowe: Nasz zestaw danych wejściowych to plik CSV, SprzedażJan2009.csv.
Krok 1) Uruchom Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Krok 2) Pig in Big Data pobiera plik z HDFS w trybie MapReduce i zapisuje wyniki z powrotem w HDFS.
Skopiuj plik SalesJan2009.csv (zapisany w lokalnym systemie plików w ~/input/SalesJan2009.csv) do katalogu domowego HDFS (Hadoop Distributed File System).
W tym przykładzie Apache Pig plik znajduje się w folderze input. Jeśli plik jest przechowywany w innej lokalizacji, podaj tę nazwę.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Sprawdź, czy plik został faktycznie skopiowany.
$HADOOP_HOME/bin/hdfs dfs -ls /

Krok 3) Konfiguracja świni.
Najpierw przejdź do $PIG_HOME/conf i zachowaj kopię oryginalnego pliku właściwości.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Otwórz plik pig.properties za pomocą wybranego edytora tekstu i określ ścieżkę do pliku dziennika za pomocą pig.logfile.
sudo gedit pig.properties

Rejestrator będzie korzystał z tego pliku w celu rejestrowania błędów.
Krok 4) Uruchom polecenie „pig”, które uruchomi wiersz poleceń Pig, interaktywną powłokę dla zapytań Pig.
pig

Krok 5) W wierszu poleceń Grunt dla Pig wykonaj podane poniżej polecenia Pig w podanej kolejności.
— A. Załaduj plik zawierający dane.
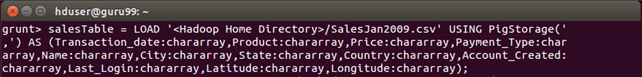
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Naciśnij Enter po tym poleceniu.
— B. Grupuj dane według pola Kraj.
GroupByCountry = GROUP salesTable BY Country;

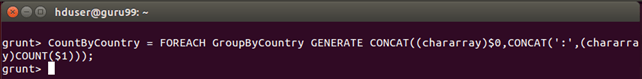
— C. Dla każdej krotki w „GroupByCountry” wygeneruj wynikowy ciąg w formacie Nazwa kraju: Liczba sprzedanych produktów.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Naciśnij Enter po tym poleceniu.
— D. Zapisz wyniki przepływu danych w katalogu „pig_output_sales” na HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Wykonanie tego polecenia zajmie trochę czasu. Po jego wykonaniu powinieneś zobaczyć poniższy ekran.

Krok 6) Wynik można zobaczyć za pomocą interfejsu poleceń jako
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Wyniki można zobaczyć również za pośrednictwem interfejsu internetowego.
Otwórz http://localhost:50070/ w przeglądarce internetowej.
Port 50070 to internetowy interfejs użytkownika NameNode w Hadoop 2. Hadoop 3 przeniósł tę samą stronę na port 9870, więc jeśli w Twoim klastrze działa Hadoop 3, użyj tego adresu.

Teraz wybierz „Przeglądaj system plików” i przejdź do /user/hduser/pig_output_sales.

Otwórz part-r-00000, aby odczytać pary kraj-liczba produktów wygenerowane przez skrypt.

Apache Pig kontra Hive kontra MapReduce
Świnia rzadko jest oceniana osobno. Zwykle zadawane pytanie brzmi, czy praca w Świni pasuje, Ul lub w ręcznie napisanym programie MapReduce, ponieważ wszystkie trzy kończą jako zadania w tym samym klastrze.
| WYGLĄD | MapReduce (Java) | Świnia Apaczów | Ula Apache |
|---|---|---|---|
| Interfejs | Java API | Pig Latin, język skryptowy przepływu danych | HiveQL, dialekt SQL |
| Poziom mięśni brzuchatraccja | Niski | Średni | Wysoki |
| Typowy użytkownik | Java wywoływacz | Inżynier danych lub badacz | Analityk znający się na SQL |
| Dane, które pasują | Wszystko obsługiwane ręcznie | Ustrukturyzowane i półustrukturyzowane; schemat jest opcjonalny w momencie ładowania | Tabele strukturalne zarejestrowane w metamagazynie |
| Code Tom | Większość linii | Mniej linii | Najmniej linii dla zapytania |
| Działa jako | Zadanie MapReduce | Kompiluje się do MapReduce, Tez lub Spark Oferty pracy | Kompiluje się do MapReduce, Tez lub Spark Oferty pracy |
| Najlepiej w | Pełna kontrola i niestandardowa logika | Wieloetapowe potoki ETL | Ad hoc zapytania i raportowanie |
W praktyce podział jest prosty. Sięgnij po Hive, gdy dane wyglądają już jak tabela, a pytanie jak SQL. Sięgnij po Pig, gdy dane wejściowe są chaotyczne, gdy potok jest łańcuchem transformacji, a nie pojedynczym zapytaniem, lub gdy ten sam skrypt musi się rozgałęziać i ponownie łączyć. Sięgnij po MapReduce tylko wtedy, gdy ani abstraccja może wyrazić logikę, ponieważ liczba wierszy rośnie szybko.
Świnia również czuje się komfortowo w otoczeniu reszty ekosystemu. Sqoop i Flume wyląduj surowe dane, ukształtuj je za pomocą Pig lub Hive i zaplanuj, np. Apache Oozie łączy kroki w powtarzalny potok. Aby uzyskać szerszy obraz tego, gdzie pasują te narzędzia, zapoznaj się z przewodnikiem big danych i podsumowanie narzędzia do dużych zbiorów danych; w celu zapoznania się z komercyjną alternatywą ETL dla skryptów pisanych ręcznie, zobacz Taland.
