
TensorFlow を使用した線形回帰チュートリアル [例]
 編集チーム
⚡ スマートサマリー
TensorFlow の線形回帰は、数値特徴量と連続的な目標値との関係をモデル化します。このチュートリアルでは、Pandas、NumPy、およびネイティブの TensorFlow 入力パイプラインと LinearRegressor 推定器を使用して、ボストンの住宅価格予測モデルを 3 つの異なる方法でトレーニングします。
線形回帰とは何ですか?
直線回帰 統計学において、2つの変数間の関係をモデル化する手法の一つです。このモデル化は、スカラー応答変数と1つ以上の説明変数との間で行われます。説明変数が1つの場合を単回帰分析、説明変数が複数ある場合を重回帰分析と呼びます。
TensorFlow は、計算を完全に制御するためのツールを提供します。 これは低レベル API を使用して行われます。 それに加えて、TensorFlow には、多くの処理を実行するための膨大な API が装備されています。 機械学習 アルゴリズム。これは高レベルのAPIであり、TensorFlowでは推定器と呼ばれています。
- 低レベル APIモデルのアーキテクチャと最適化をゼロから構築する。初心者には複雑だ。
- 高レベルの API: アルゴリズムを定義します。ユーザーフレンドリーです。TensorFlow は、 推定者 構築、トレーニング、評価、予測を行うため。
このチュートリアルでは、 推定者のみ計算が高速化され、実装も容易になります。最初のパートでは、勾配降下法オプティマイザを使用してTensorFlowで線形回帰を学習する方法を説明します。2番目のパートでは、ボストンデータセットを使用して、TensorFlow推定器で住宅価格を予測します。
線形回帰モデルをトレーニングする方法
モデルの学習を開始する前に、線形回帰とは実際にはどのようなものなのかを見ていきましょう。
xとyという2つの変数があり、xの値がわかっている場合にyの値を予測することが課題だと想像してみてください。データをグラフ化すると、下の散布図に示すように、独立変数xと従属変数yの間に正の相関関係があることがわかります。

x=1の場合、yはおよそ6に等しくなり、x=2の場合、yはおよそ8.5になることが観察できるでしょう。
これはあまり正確な方法ではなく、特に数十万点のデータを含むデータセットではエラーが発生しやすい。
線形回帰は方程式を使用して評価されます。 変数 y は、XNUMX つまたは複数の共変量によって説明されます。 あなたの例では、従属変数は XNUMX つだけです。 この方程式を書く必要がある場合、次のようになります。

を使用して:
 はバイアスです。つまり、x=0 の場合、y=
 xに関連付けられた重みは
 これは残差、つまりモデルの誤差です。これには、モデルがデータから学習できないものが含まれます。
モデルを当てはめて、次の解を見つけたと想像してください。
- = 3.8
- = 2.78
これらの数値を式に代入すると次のようになります。
y= 3.8 + 2.78x
これで、yの値を求めるためのより良い方法がわかりました。つまり、xを任意の値に置き換えることで、yを予測できます。下の図では、方程式のxをデータセット内のすべての値に置き換えて、結果をプロットしています。

赤い線は適合値、つまりxの各値に対応するyの値を表しています。yを予測するためにxの値を見る必要はありません。各xに対して、赤い線上に位置する値が存在します。また、xが2より大きい値についても予測できます。
線形回帰をより多くの共変量に拡張したい場合は、モデルに変数を追加することで可能です。従来の分析と線形回帰の違いは、線形回帰では、各変数xが独立してどのような反応を示すかを調べる点にあります。
例を見てみましょう。アイスクリーム店の売上を予測したいとします。データセットには、天気(雨、晴れ、曇り)や顧客情報(給与、性別、婚姻状況)など、さまざまな情報が含まれています。
従来の分析方法では、例えば各変数の平均値を計算し、さまざまなシナリオにおける売上を推定することで、売上を予測しようとします。しかし、この方法では予測精度が低く、分析対象が選択されたシナリオに限定されてしまいます。
線形回帰を使用する場合は、次の方程式を書くことができます。
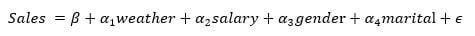
このアルゴリズムは、重みの最適な解を見つけ出します。つまり、適合線とデータ点の差であるコストを最小化しようとします。
アルゴリズムの仕組み
下の図は、アルゴリズムが繰り返すループをまとめたものです。重みを選択し、yを予測し、誤差を測定し、重みを修正します。

アルゴリズムはそれぞれの乱数を選択します。  (NAIST) と
 x の値を置き換えて、y の予測値を取得します。 データセットに 100 個の観測値がある場合、アルゴリズムは 100 個の予測値を計算します。
誤差を計算できます。  モデルの誤差とは、予測値と実測値の差のことです。正の誤差は、モデルがyの予測値を過小評価していることを意味し、負の誤差は、モデルがyの予測値を過大評価していることを意味します。

あなたの目標は、誤差の二乗を最小化することです。アルゴリズムは、誤差の二乗の平均を計算します。このステップは、誤差の最小化と呼ばれます。線形回帰の場合、これは 平均二乗誤差、MSEとも呼ばれます。 数学的には次のようになります。

どこ:
 は重みなので、
 予測値を指します
- y は実数値です
- mは観測数です
 予測値を指します
注意してください  行列の転置を使用することを意味します。 の
 平均の数学的表記です。
目標は最高のものを見つけることです  これはMSEを最小化する。
平均誤差が大きい場合は、モデルのパフォーマンスが低く、重みが適切に選択されていないことを意味します。 重みを修正するには、オプティマイザーを使用する必要があります。 従来のオプティマイザは次のように呼ばれます。 勾配降下.
勾配降下法は、導関数を用いて重みを増減させます。導関数が正の場合、重みは減少します。導関数が負の場合、重みは増加します。モデルは重みを更新し、誤差を再計算します。このプロセスは、誤差が変化しなくなるまで繰り返されます。各パスは、 繰り返しさらに、勾配には学習率(学習速度を示す指標)が乗算されます。
学習率が小さすぎると、アルゴリズムが収束するまでに非常に長い時間がかかります。これは、より多くの反復回数が必要となるためです。学習率が高すぎると、アルゴリズムが収束しない可能性があります。下の損失曲線は、このデータセットにおける誤差と反復回数の関係を示しています。

上の図からわかるように、このモデルは重みの安定した値を見つけるまでに約20回このプロセスを繰り返し、その結果、最小の誤差に達します。
誤差はゼロではなく、5付近で安定していることに注意してください。これは、モデルの典型的な誤差が5であることを意味します。誤差を減らしたい場合は、変数を増やすなどしてモデルに情報を追加するか、異なる推定方法を使用する必要があります。
最初の式を覚えていますか?

最終的な重みは3.8と2.78です。以下の動画では、勾配降下法が損失関数を最適化してこれらの重みを見つける様子をご覧いただけます。
TensorFlow を使用して線形回帰をトレーニングする方法
内部で何が起こっているかをよりよく理解できたので、TensorFlow が提供する推定 API を使用して、TensorFlow を使用して最初の線形回帰をトレーニングする準備が整いました。
バージョンノート: 以下に示す推定ワークフローは、TensorFlow 1.x および初期の 2.x リリースに対して作成されました。TensorFlow は、 tf.estimator (NAIST) と tf.feature_column API はバージョン 2.12 で完全に非推奨となり、Estimator はバージョン 2.16 で削除されました。現在のインストールでは、このコードを TensorFlow 1.15 または 2.x 内で実行してください。tf.compat.v1 環境、または Keras に移植すると、 tf.keras.layers.Dense(1) さらに、前処理レイヤーがLinearRegressorと特徴量列に置き換わります。特徴量、ラベル、バッチ、エポック、MSE、勾配降下法といった概念は変更なく引き継がれます。
以下の変数を含むボストンデータセットを使用します。
| 変数 | 詳細説明 |
| クリム | 町ごとの一人当たりの犯罪率 |
| zn | 25,000 平方フィートを超える敷地に区画された住宅地の割合 |
| インダス | 町ごとの非小売業の面積の割合。 |
| noxの | 一酸化窒素濃度 |
| rm | 住居ごとの平均部屋数 |
| 年齢 | 1940 年以前に建てられた所有者占有ユニットの割合 |
| DIS | ボストンの XNUMX つの雇用センターまでの加重距離 |
| 税金 | 10,000 ドルあたりの全額固定資産税の税率 |
| プトラティオ | 町ごとの生徒と教師の比率 |
| メドゥ | 持ち家価値の中央値(千ドル) |
XNUMX つの異なるデータセットを作成します。
| データセット | 客観 | 形状 |
| 研修 | モデルをトレーニングして重みを取得する | 400、10 |
| 評価 | 目に見えないデータに対するモデルのパフォーマンスを評価する | 100、10 |
| 予測する | モデルを使用して新しいデータに基づいて住宅価格を予測する | 6、10 |
目的は、データセットの特徴量を用いて住宅の価値を予測することである。
チュートリアルの後半では、TensorFlowを使ってデータをインポートする3つの異なる方法を学びます。
- パンダと一緒に
- 自律的AI NumPy
- TensorFlowのみ
なお、3つの選択肢はいずれも同じ結果をもたらします。
このコースでは、高レベルAPIを使用してTensorFlow線形回帰モデルを構築、トレーニング、評価する方法を学びます。低レベルAPIを使用する場合は、以下の項目を手動で定義する必要があります。
- 損失関数
- 最適化手法:勾配降下法
- 行列乗算
- グラフとテンソル
これは初心者にとっては面倒で複雑すぎる。
Pandasソリューション
モデルをトレーニングするには、必要なライブラリをインポートする必要があります。
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
ステップ1) データをインポートするには パンダ.
列名を定義してCOLUMNSに格納します。pd.read_csv()を使用してデータをインポートできます。
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
各呼び出しは、以前ダウンロードしたCSVファイルに対して行うようにしてください。
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
データの形状を印刷することができます。
print(training_set.shape, test_set.shape, prediction_set.shape)
出力
(400, 10) (100, 10) (6, 10)
ラベル(つまりy)はデータセットに含まれていることに注意してください。そのため、特徴量のみを含むリストと、ラベル名のみを含むリストの2つを定義する必要があります。これらの2つのリストによって、データセット内の特徴量と、ラベルに対応する列名が推定器に伝わります。
それは以下のコードで行われます。
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
ステップ2) データを変換する
数値変数を適切な形式に変換する必要があります。TensorFlow には、連続変数を変換するためのメソッド tf.feature_column.numeric_column() が用意されています。
前のステップでは、モデルに含める特徴量のリストを定義しました。今度は、このリストを使ってそれらを数値データに変換できます。モデルから特徴量を除外したい場合は、feature_cols を作成する前に、リスト FEATURES から 1 つ以上の変数を削除してください。
使用することに注意してください Python リストFEATURESに対してリスト内包表記を使用して、feature_colsという名前の新しいリストを作成します。これにより、tf.feature_column.numeric_column()を9回記述する必要がなくなります。リスト内包表記は、新しいリストを作成するためのより高速で簡潔な方法です。
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
ステップ3) 推定量を定義する
このステップでは、推定器を定義する必要があります。TensorFlowには、分類タスク用が3つ、TensorFlow回帰タスク用が3つ、合計6つの既製推定器が用意されています。
- リグレッサー
- DNNリグレッサー
- 線形リグレッサー
- DNN線形結合回帰器
- 分類します
- DNN分類子
- LinearClassifier
- DNN線形結合分類器
このチュートリアルでは、線形回帰分析を使用します。 この関数にアクセスするには、tf.estimator を使用する必要があります。
この関数には XNUMX つの引数が必要です。
- feature_columns: モデルに含める変数が含まれています
- model_dir: グラフを保存したり、モデルパラメータを保存したりするためのパス
TensorFlowは作業ディレクトリにtrainという名前のフォルダを自動的に作成します。このパスを使用してアクセスする必要があります。 テンソルボード以下のTensorFlow回帰の例に示すように。
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
出力
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
TensorFlowの難しい点は、モデルへのデータ入力方法です。TensorFlowは並列処理と非常に大規模なデータセットを扱うように設計されています。マシンリソースの制約上、すべてのデータを一度にモデルに入力することは不可能です。そのため、毎回バッチ単位でデータを入力する必要があります。ここで言うバッチとは、数百万件以上のレコードを含む巨大なデータセットのことです。バッチ処理を行わないと、メモリ不足エラーが発生します。
たとえば、データに 100 個の観測値が含まれており、バッチ サイズ 10 を定義した場合、モデルは反復ごとに 10 個の観測値 (10*10) を認識することになります。
モデルがすべてのデータを処理すると、1エポックが完了します。エポックとは、モデルがデータを何回処理するかを定義するものです。このステップは「なし」に設定し、モデルに一定回数の反復処理を実行させるのが良いでしょう。
もう一つ重要な点は、各反復処理の前にデータをシャッフルするかどうかです。トレーニング中は、モデルがデータセットの特定のパターンを学習しないように、データをシャッフルすることが重要です。モデルがデータの根底にあるパターンの詳細を学習してしまうと、未知のデータに対する予測を一般化することが難しくなります。これは過学習と呼ばれます。モデルはトレーニングデータではうまく機能しますが、未知のデータに対しては正しく予測できなくなります。
TensorFlowを使えば、これら2つのステップは簡単に実行できます。データがパイプラインに送られると、必要な観測値の数(バッチ)と、データのシャッフルが必要かどうかを自動的に判断します。
TensorFlowにモデルへの入力方法を指示するには、pandas_input_fnを使用できます。このオブジェクトには5つのパラメータが必要です。
- x: 特徴データ
- y: ラベルデータ
- バッチサイズ: バッチ。 デフォルトでは 128
- num_epoch: エポック数(デフォルト値は1)
- shuffle: データをシャッフルするかどうか。デフォルトはNoneです。
モデルに何度も入力する必要があるため、この処理を繰り返す関数を定義します。この関数を get_input_fn とします。
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
モデルのパフォーマンスを評価する通常の方法は次のとおりです。
- モデルを訓練する
- 別のデータセットでモデルを評価する
- 予測する
TensorFlowのエスティメータは、これら3つのステップを簡単に実行するための3つの異なる関数を提供します。
ステップ4) モデルを訓練する
モデルの適合には、推定器のtrainメソッドを使用できます。train推定器には、input_fnとステップ数が必要です。上記で作成した関数を使用してモデルにデータを入力できます。次に、モデルに1000回反復するように指示します。エポック数を指定しないことに注意してください。モデルは1000回反復します。エポック数を1に設定すると、トレーニングセットに400件のレコードがあり、バッチサイズが128であるため、モデルは4回反復します。
- 128行
- 128行
- 128行
- 16行
したがって、以下のTensorFlow分類の例に示すように、エポック数を「なし」に設定し、反復回数を定義する方が簡単です。
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
出力
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
以下のコマンドでTensorBoardを確認できます。
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
ステップ5) モデルを評価する
以下のコードを使用して、テスト セットに対するモデルの適合性を評価できます。
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
出力
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
以下のコードを使用して損失を出力できます。
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
出力
Loss: 3215.895996
このモデルの損失は3215です。要約統計情報を確認することで、誤差の大きさを把握できます。
training_set['medv'].describe()
出力
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
上記の要約統計から、住宅の平均価格は2万2千ドル、最低価格は5千ドル、最高価格は5万ドルであることがわかります。報告されている損失は平均二乗誤差であるため、元の単位での典型的な誤差はおよそ32.16の平方根であり、これは約5,700ドルに相当します。
ステップ6) 予測を立てる
最後に、TensorFlowの予測メソッドを使用して、ボストンにある6軒の住宅の価値を推定することができます。
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
推定値を出力するには、このコードを使用できます。
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
出力
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
このモデルは以下の値を予測します。
| 一戸建て | 予測 |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
これらの6軒の家の真の価値は不明であることに注意してください。ディープラーニングのチュートリアルでは、線形モデルを上回ることを目指します。
NumPyソリューション
このセクションでは、NumPy推定器を使用してデータを入力としてモデルをトレーニングする方法について説明します。方法は同じですが、numpy_input_fn推定器を使用します。
同じ 3 つの CSV ファイルを読み込みますが、.values を持つ生の NumPy 配列のみを保持します。
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
ステップ1) データをインポートする
まず、特徴変数とラベルを区別する必要があります。これは、訓練データと評価データの両方に対して行う必要があります。データを分割する関数を定義する方が速いでしょう。
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
この関数を使用すると、訓練データセットと評価データセットの特徴量からラベルを分離できます。
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
予測データセットの最後の列にはNaNしか含まれていないため、その列を除外する必要があります。
x_predict = prediction_set_n[:, :-2]
配列の形状を確認してください。ラベルには2次元目があってはならないことに注意してください。つまり、(400,)となります。
print(X_train.shape, y_train.shape, x_predict.shape)
出力
(400, 9) (400,) (6, 9)
特徴列は次のように構築できます。
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
推定器は以前と同様に定義されます。特徴量の列とグラフの保存場所を指定します。
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
出力
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
NumPyの推定器を使用してデータをモデルに入力し、モデルをトレーニングすることができます。なお、可読性を高めるため、input_fn関数を事前に定義しています。
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
出力
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
モデルを評価するには、異なる入力関数を使用して同じ手順を繰り返します。
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
出力
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
最後に、予測値を計算できます。これはPandasの結果とほぼ同じになるはずです。
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
出力
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
TensorFlowソリューション
最後のセクションは純粋な TensorFlow 解決策。この方法は、他の2つの方法よりもやや複雑です。
使用する場合は、 Jupyter ノートこのセッションを実行するには、再起動してカーネルをクリアする必要があります。
TensorFlowには、データをパイプラインに渡すための優れたツールが用意されています。このセクションでは、input_fn関数を自分で作成します。
ステップ1) データのパスと形式を定義する
まず、CSVファイルのパスを指定して2つの変数を宣言します。トレーニングセット用とテストセット用の2つのファイルがあることに注意してください。
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
次に、CSVファイルから使用したい列を定義する必要があります。ここではすべての列を使用します。その後、各変数の型を宣言する必要があります。
浮動小数点変数は[0.]で定義されます。
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
ステップ2) input_fn 関数を定義する
この機能は3つの部分に分けられます。
- データをインポートする
- イテレータを作成する
- データを消費する
以下に、関数を定義するためのコード全体を示します。コードについては後ほど説明します。
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
データをインポートする
CSVファイルの場合、データセットメソッドは一度に1行ずつ読み込みます。データセットを構築するには、オブジェクトを使用する必要があります。 TextLineデータセット。データセットにはヘッダーが含まれているため、skip(1) を使用して最初の行をスキップする必要があります。この時点では、パイプラインでデータのみを読み込み、ヘッダーは除外します。モデルにデータを入力するには、特徴量とラベルを分離する必要があります。データに変換を適用するために使用されるメソッドは map です。
このメソッドは、データの変換方法を指示するために作成する関数を呼び出します。簡単に言うと、データを渡す必要があります。 TextLineデータセットオブジェクトからヘッダーを除外し、関数によって指示された変換を適用します。
Code 説明
- tf.data.TextLineDataset(data_file): この行はCSVファイルを読み込みます
- .skip(1): ヘッダーをスキップします
- .map(parse_csv)): レコードをテンソルに解析します
マップオブジェクトに指示を与える関数を定義する必要があります。この関数をparse_csvと名付けることができます。
この関数は、tf.decode_csv メソッドを使用して CSV ファイルを解析し、特徴量とラベルを宣言します。特徴量は辞書またはタプルとして宣言できますが、ここではより便利な辞書形式を使用します。
Code 説明
- tf.decode_csv(value, Record_defaults= RECORDS_ALL): メソッド decode_csv は、 TextLineCSV ファイルを読み込むためのデータセット。record_defaults は、列の型について TensorFlow に指示します。TensorFlow 2.x では、このシンボルは tf.io.decode_csv にあります。
- dict(zip(COLUMNS, columns)): すべての列を辞書に格納します。tracこのデータ処理中にted
- features.pop('medv'): 特徴変数から目的変数を除外し、ラベル変数を作成します。
データセットには、テンソルを繰り返し供給するための要素がさらに必要です。具体的には、データセットがモデルに無限に供給され続けるように、`repeat` メソッドを追加する必要があります。このメソッドを追加しないと、モデルは一度だけ反復処理を行い、パイプラインにデータが供給されなくなるためエラーが発生します。
その後、バッチメソッドを使用してバッチサイズを制御できます。これは、各イテレーションでパイプラインに渡すデータ量をデータセットに指示することを意味します。バッチサイズを大きく設定すると、モデルの処理速度が低下します。
ステップ3) イテレータを作成する
これで、XNUMX 番目のステップの準備が整いました。データセット内の要素を返すイテレータを作成します。
演算子を作成する最も簡単な方法は、make_one_shot_iterator メソッドを使用することです。
その後、イテレータからフィーチャとラベルを作成できます。
ステップ4) データを消費する
input_fn 関数の動作を確認できます。データを処理するには、セッション内でこの関数を呼び出す必要があります。バッチサイズを 1 に設定して試してみてください。
なお、これは特徴量を辞書形式で、ラベルを配列形式で出力します。
これはCSVファイルの最初の行を表示します。異なるバッチサイズでこのコードを何度も実行してみてください。
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
出力
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
ステップ5) 特徴列を定義する
数値列は以下のように定義する必要があります。
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
すべての変数を1つのバケットにまとめる必要があることに注意してください。
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
ステップ6) モデルを構築する
推定器 LinearRegressor を使用してモデルをトレーニングできます。
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
出力
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
使用する必要があるのは ラムダ関数 関数 input_fn の引数を記述できるようにするためです。ラムダ関数を使用しない場合、モデルをトレーニングすることはできません。
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
出力
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
以下のコードを使用して、テスト セットに対するモデルの適合性を評価できます。
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
出力
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
最後のステップは、特徴行列の値に基づいてターゲットの値を予測することです。予測したい値を辞書に記述することができます。このモデルには9つの特徴量があるので、それぞれに値を指定する必要があります。モデルはそれぞれの特徴量に対して予測値を出力します。
以下のコードでは、df_predict CSVファイルに含まれる各特徴量の値を書き込みます。
データセットにラベルがないため、新しい input_fn 関数を作成する必要があります。Dataset オブジェクトの from_tensors API を使用できます。
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
最後に、予測結果を出力します。
for pred in enumerate(pred_results):
print(pred)
出力
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
3つのパイプラインはすべて同じ6つの予測結果を返すため、Pandas、NumPy、ネイティブのTensorFlowデータセットのどれを選択するかは、精度ではなく利便性の問題であることが確認された。
