
PyTorch 転移学習チュートリアル(例付き)
 エブリン・クラーク
⚡ スマートサマリー
転移学習は、既に大規模なデータセットで学習済みのネットワークを再利用することで、関連する新しいタスクを、はるかに少ないラベル付き画像と、元の学習時間のほんの一部で解決できるようにするものです。
トランスファーラーニングとは何ですか?
転移学習 訓練済みのモデルを使用して別の関連タスクを解決する手法です。 機械学習 特定の問題を解決する過程で得られた知識を蓄積し、その知識を別の異なるが関連性のある問題の解決に活用する研究手法。これにより、以前に学習したタスクから得られた情報を再利用することで効率が向上する。
ネットワークをゼロから学習させるには膨大なデータ量が必要となるため、他のネットワークモデルの重みを再利用することが一般的です。学習時間を短縮するために、既存のネットワークとその重みを取得し、最終層を修正して独自の課題を解決します。この方法の利点は、最終層を少量のデータセットで学習できることです。
Pythonを書く前にTorchコードを使用すると、問題が転移学習のどのファミリーに属するかを知るのに役立ちます。なぜなら、それによって必要なラベル付きデータの量が決まるからです。
転移学習の種類
研究文献では、この手法は3つの系統に分類されています。どの系統があなたに当てはまるかは、あなたが使用するフレームワークではなく、問題のどちらの側面にラベルが付いているかによって決まります。
| タイプ | ソースドメイン | Target ドメイン | 典型的な使用 |
|---|---|---|---|
| 帰納的 | ラベル付き | ラベルは付いているが、別のタスク | ImageNetのバックボーンを、エイリアン対プレデターの2クラス問題に再設定する |
| トランスダクティブ | ラベル付き | ラベルなし、同じタスク、異なるデータ分布 | ドメイン適応、例えばモデルをスタジオ写真からスマートフォン写真に移行させるなど |
| 監督されない | ラベルなし | ラベルなし | Clusterすべてのレコードにラベルを付けるのが難しい場合の次元削減または次元削減 |
このチュートリアルで構築する例は、帰納的転移学習です。VGG19はラベル付きImageNetの知識を携えて到着し、これまで見たことのないラベル付き2クラス分類問題に取り組みます。
機能例trac調整 vs 微調整
事前学習済みのネットワークを選択した後、それを適応させる方法は2つあります。違いは、学習を継続させるレイヤーの数だけです。
| 側面 | 機能例trac生産 | 微調整 |
|---|---|---|
| トレーニングを行うレイヤー | 置き換えられた分類器のみ | 分類器と一部またはすべての畳み込みブロック |
| backbone の requires_grad | × | 更新されるブロックについては、これは真実です。 |
| 必要なデータ | 小規模で、クラスごとに数百枚の画像が使用されることが多い。 | より大きく、通常は数千 |
| トレーニング費用 | 最低、CPUで動作 | 高くなると、GPUは持つ価値が出てくる |
| 典型的な精度 | ソース画像とターゲット画像が似ている場合に良い。 | 通常は、2つのドメインが異なる方が良い |
以下の手順では、機能を使用します。trac: すべての VGG19 パラメータが固定され、新しい最終線形層のみが学習します。ファインチューニングへの切り替えは小さな変更で、更新したいブロックで requires_grad を True に設定したままにして、学習率を下げて、借用した重みが破壊されないようにするだけです。
データセットの読み込み
Py で転移学習を始める前にTorch、使用するデータセットを理解する必要があります。この転移学習 PyTor例えば、約700枚の画像からエイリアンとプレデターを分類します。この手法では、トレーニングに大量のデータは必要ありません。データセットは以下からダウンロードできます。 Kaggle: エイリアンVSプレデター.
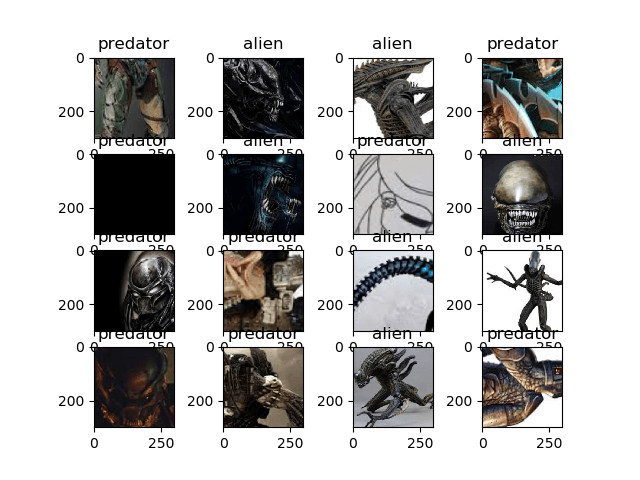
このコレクションは意図的に小規模に作られており、収録されている写真の一部を以下に示す。

出典: エイリアン対 プレデター Kaggle
次にこの Py ではTorch 転移学習チュートリアルでは、Py を使用した転移学習の適用方法を学びます。Tor段階的に。
転移学習を使用するにはどうすればよいですか?
Python を使用した深層学習のための転移学習の手順を以下に示します。TorCH:
ステップ 1) データをロードする
最初のステップは、データを読み込み、ネットワークの要件に合うように画像にいくつかの変換を適用することです。
torchvision.datasets を含むフォルダからデータをロードします。モジュールはフォルダを反復処理してデータをトレーニングセットと検証セットに分割します。ここで使用される変換パイプラインは、画像を中央から切り抜き、テンソルに変換し、正規化します。 深層学習.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
次に、データセットを可視化します。可視化ステップでは、トレーニングデータローダーから次のバッチの画像とラベルを取得し、Matplotlibを使用して表示します。
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
そのコードを実行すると、トレーニング画像が4×4のグリッド状に描画され、それぞれの画像にはローダーが返したクラス名がタイトルとして付けられます。
ステップ 2) モデルの定義
この深層学習プロセスでは、torchvisionモジュールに含まれるVGG19を使用します。
torchvision.modelsを使用して、事前学習済みの重みが有効なvgg19をロードします。その後、レイヤーをフリーズして学習できないようにします。次に、最後のレイヤーを、問題に適した線形レイヤー(ここでは2クラス)に変更します。損失関数にはCrossEntropyLossを使用し、オプティマイザは学習率0.001、モーメンタム0.9のSGDです。以下のPyコードを参照してください。Torch 転移学習の例。
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
バージョンノート: 事前学習済み=True 引数はまだ機能しますが、torchvision 0.13 以降、 重み 引数なので、新しいインストールでは torchvision.models.vgg19(weights=VGG19_Weights.DEFAULT) そうでない場合は、非推奨警告を表示します。どちらの形式も同じImageNetの重みを読み込みます。
出力モデルの構造
モデルを出力すると、完全なVGG19グラフが返されます。分類器ブロックの最後の行を読んで、スワップが正しく機能したことを確認してください。1,000個のImageNetクラスではなく、2つの出力が生成されます。
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
ステップ 3) モデルのトレーニングとテスト
この関数のいくつかを使用します PyTorchチュートリアル モデルのトレーニングと評価に役立ちます。
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
最後に、Py での転移学習ではTor例えば、トレーニングプロセスをエポック数を 25 に設定して開始し、その後ネットワークを評価します。各トレーニングステップで、モデルは入力を受け取り、出力を予測します。予測は損失を計算するための基準に渡され、バックプロパゲーションによって勾配が計算され、オプティマイザは自動勾配を使用して重みを更新します。
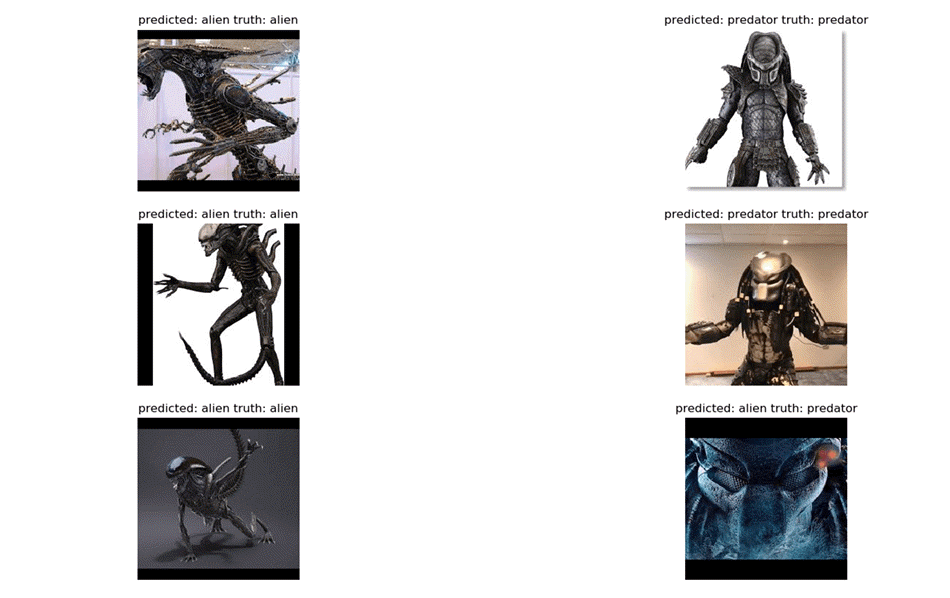
可視化機能では、学習済みのネットワークを一連の画像でテストしてラベルを予測し、その結果をMatplotlibで描画します。
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
ステップ 4) 結果
今回の実行における精度は92%です。トレーニング終了時に表示されるログには、最後の2エポックにおける実行損失と総トレーニング時間が表示されます。
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
モデルによる予測結果は、以下に示すようにMatplotlibを用いて可視化される。
転移学習でよくある間違いとその修正方法
転移学習スクリプトにおけるエラーのほとんどは、数学的な問題ではなく、機械的な問題です。以下は、上記のコードの実行を妨げるエラーとそのそれぞれの意味です。
- 最終層のサイズ不一致: 置き換えられた線形層は、元の分類器によって報告されたin_featuresを受け入れ、len(class_names)個の出力を正確に出力する必要があります。ステップ2のようにモデルを出力することが、両方の数値を確認する最も速い方法です。
- 背骨は決して凍りついていなかった。 requires_grad を True のままにしておくと、VGG19 のすべてのパラメータが更新され、CPU 上での実行速度が極端に低下します。分類器を置き換える前に、これを False に設定してください。
- 正規化の不一致: transforms.Normalizeで使用される平均値と標準偏差は、トレーニング時と推論時で同じ値である必要があります。そうでない場合、予測は目に見える理由もなくずれてしまいます。
- 非推奨の重み引数: torchvision 0.13 以降では、pretrained=True は非推奨の警告を発するため、weights enum の使用が推奨されます。
- num_workers on Windows そしてノート: num_workers=4 の DataLoader ではエントリ ポイントをガードする必要があるため、num_workers=0 に設定します。 Python スポーンエラーまたはピクルスエラーが発生します。
- トレーニングモードでの評価: DropoutとBatchNormが決定論的に動作するように、スコアリングの前にmodel.eval()を呼び出し、その後model.train()に戻してください。
