
貪欲なアルゴリズムと例: とは何か、方法とアプローチ
 編集チーム
⚡ スマートサマリー
貪欲アルゴリズム設計は、再帰、順序付けられたリソース、および停止条件を使用して、各ステップで最適な局所的選択を行うことで最適な解を構築し、スケジューリング、スパニングツリー、最短経路、およびネットワーク最適化問題を効率的に解決します。
貪欲なアルゴリズムとは何ですか?
A 貪欲なアルゴリズム 実行のどの段階においても、リソースの即時利用可能性の最大値に基づいて、リソースのセットを再帰的に分割します。
貪欲法で問題を解決するには、2つの段階があります。
- アイテムのリストをスキャンする
- 最適化
入力配列が段階的に分割されるにつれて、両方のステージは並行して実行されます。
貪欲法に従うには、再帰とコンテキスト切り替えの実務知識が役立ちます。 trace コード。貪欲パラダイムは、必要十分条件のペアで説明できます。
貪欲なパラダイムは XNUMX つの条件によって定義されます。
- それぞれの段階的な選択は、問題を最も受け入れられる解決策へと導くものでなければならない。
- 問題構造は、有限回の貪欲法ステップで停止しなければならない。
理論を理解した上で、貪欲探索アプローチの背景にある歴史を見ていきましょう。
貪欲の歴史 Algorithms
貪欲アルゴリズムの歴史における重要な出来事を以下に挙げます。
- 貪欲アルゴリズムは、1950年代にグラフ探索アルゴリズムのために初めて概念化された。
- エドガー・ダイクストラは、オランダの首都アムステルダムにおける経路を短縮するために、最短経路アルゴリズムを開発した。
- 同じ10年間に、プリムとクルスカルは、重み付き経路に沿った経路コストを最小化して最小全域木を構築する最適化戦略を開発した。
- 70年代、アメリカの研究者であるコーメン、レイザーソン、リベスト、スタインは、古典的な論文の中で貪欲解の再帰的サブストラクチャリングについて記述した。 Introduction to Algorithms 教科書。
- 貪欲探索パラダイムは、2005年にNISTの記録において、独立した最適化戦略として分類された。
- 今日でも、Open Shortest Path First (OSPF) などのウェブプロトコルや多くのパケット交換プロトコルは、ネットワーク上の伝送時間を最小限に抑えるために、貪欲な戦略を採用している。
貪欲な戦略と決断
このロジックは、アルゴリズムが進む方向に基づいて、各段階で「貪欲」か「非貪欲」かの二者択一に帰着する。
例えば、ダイクストラ法は、各ステップでコスト関数を評価することによってインターネット上のホストを特定します。コスト関数が返す値によって、次のパスが「貪欲」か「非貪欲」かが決まります。
つまり、アルゴリズムは局所的に最適ではないステップを踏んだ瞬間に貪欲性を失い、貪欲な問題はそれ以上貪欲なステップが不可能になった時点で停止する。
貪欲なアルゴリズムの特徴
Greedy アルゴリズムの重要な特徴は次のとおりです。
- 順序付けられたリソースのリストには、システムに対する制約を定量化するコストまたは価値の属性が付与されている。
- このアルゴリズムは、制約条件が適用される時間内で、可能な限り多くのリソースを取得します。
- 例えば、活動スケジューリング問題では、資源コストは時間単位で測定され、活動は順番に実行されなければならない。

なぜ貪欲なアプローチを用いるのか?
貪欲なアプローチを使用する理由は次のとおりです。
- 貪欲法にはトレードオフがあり、最適化に適している。
- 最も明白な理由は、実行可能な解決策を即座に生み出すことである。後述する活動選択問題において、現在の活動が終了する前にさらに活動が実行可能な場合、それらを同じ期間内にスケジュールすることができる。
- もう一つの理由は、条件に基づいて問題を再帰的に分割するため、部分的な解決策を統合する必要がないことです。
- 活動選択問題において、再帰的な分割ステップは、リストを一度スキャンし、対象となる活動のみを考慮することによって実現される。
活動選択問題の解決方法
アクティビティスケジューリングの例では、すべてのアクティビティには開始時刻と終了時刻があり、参照用に番号でインデックス付けされています。アクティビティには次の2つのカテゴリがあります。
- 検討対象活動: 残りの活動をさらに組み込む能力を測定するための基準となる活動。
- 残りのアクティビティ: 考慮されているアクティビティよりも前の XNUMX つ以上のインデックスにあるアクティビティ。
活動の実施コストは、その活動の所要時間であり、(終了時間-開始時間)として計算されます。
貪欲範囲とは、検討対象の活動の時間内に実行可能な残りの活動の数を指します。
Archi貪欲なアプローチの構造
ステップ1) 活動コストのリストを、考慮対象となるインデックスとしてインデックス0から順にスキャンします。
ステップ2) 検討対象の活動が終了するまでに、さらに多くの活動が完了できる可能性がある場合は、残りの活動を検索する。
ステップ3) これ以上予定できるアクティビティがない場合は、現在残っているアクティビティが次の検討対象アクティビティとなります。新しい検討対象アクティビティでステップ1とステップ2を繰り返します。アクティビティが残っていない場合は、ステップ4に進みます。
ステップ4) 検討対象のインデックスの和集合を返します。これらはスループットを最大化するアクティビティインデックスです。

Archi貪欲なアプローチの構造
Code 説明
#include<iostream>
#include<stdio.h>
#include<stdlib.h>

#define MAX_ACTIVITIES 12

コードの説明:
- インクルードされるヘッダー ファイル/クラス
- ユーザーが設定可能なアクティビティの最大数。
using namespace std;

class TIME
{
    public:
    int hours;

    public: TIME()
    {
   	 hours = 0;
    }
};

コードの説明:
- ストリーミング操作のための標準名前空間を宣言します。
- TIME のクラス定義
- XNUMX 時間のタイムスタンプ。
- TIME のデフォルトコンストラクター
- 時間変数。
class Activity
{
    public:
    int index;
    TIME start;
    TIME finish;

    public: Activity()
    {
   	 start = finish = TIME();
    }
};

コードの説明:
- Activity のクラス定義。
- 期間を定義するタイムスタンプ。
- デフォルトコンストラクタでは、すべてのタイムスタンプが0に初期化されます。
class Scheduler
{
    public:
    int considered_index,init_index;
    Activity *current_activities = new    Activity[MAX_ACTIVITIES];
    Activity *scheduled;

コードの説明:
- スケジューラ クラス定義のパート 1。
- considered_indexは、配列をスキャンする開始点です。
- init_indexは、セットアップ中にランダムなタイムスタンプを割り当てるために使用されます。
- Activityオブジェクトの配列は、new演算子によって動的に割り当てられます。
- スケジュールされたポインタには、現在の貪欲法の結果が保持されます。
Scheduler()
{
   	 considered_index = 0;
   	 scheduled = NULL;
...
...
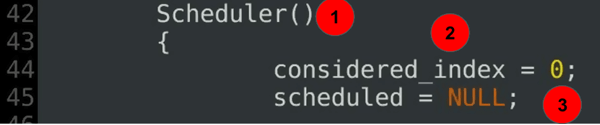
コードの説明:
- スケジューラコンストラクタ ― クラス定義のパート2。
- considered_index は、現在のスキャンの開始位置を示します。
- 貪欲度は最初は定義されていません。
for(init_index = 0; init_index < MAX_ACTIVITIES; init_index++) { current_activities[init_index].start.hours = rand() % 12; current_activities[init_index].finish.hours = current_activities[init_index].start.hours + (rand() % 2); printf("\nSTART:%d END %d\n", current_activities[init_index].start.hours ,current_activities[init_index].finish.hours); } … …
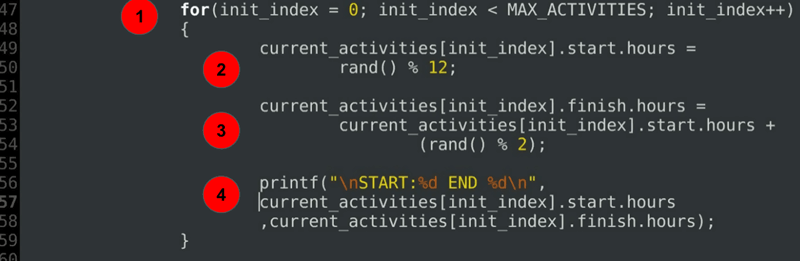
コードの説明:
- forループは、スケジュールされたすべてのアクティビティの開始時刻と終了時刻を初期化します。
- 開始時刻を初期化します。
- 終了時刻を開始時刻以降に初期化します。
- デバッグ文は、割り当てられた期間を出力します。
	public:
   		 Activity * activity_select(int);
};
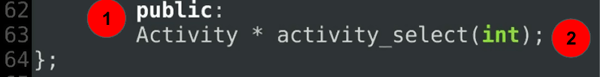
コードの説明:
- 第4部 ― スケジューラクラス定義の最終部分。
- activity_select() は開始インデックスを基準として受け取り、貪欲な探索をサブ問題に分割します。
Activity * Scheduler :: activity_select(int considered_index)
{
    this->considered_index = considered_index;
    int greedy_extent = this->considered_index + 1;
…
…

- スコープ解決演算子(::)は、関数定義をスケジューラクラスにリンクします。
- considered_indexは値渡しされ、greedy_extentはその直後のインデックスで初期化されます。
Activity * Scheduler :: activity_select(int considered_index) { while( (greedy_extent < MAX_ACTIVITIES ) && ((this->current_activities[greedy_extent]).start.hours < (this->current_activities[considered_index]).finish.hours )) { printf("\nSchedule start:%d \nfinish%d\n activity:%d\n", (this->current_activities[greedy_extent]).start.hours, (this->current_activities[greedy_extent]).finish.hours, greedy_extent + 1); greedy_extent++; } … ...

コードの説明:
- コアロジックは、貪欲な範囲がMAX_ACTIVITIESに制限されるというものです。
- 現在の活動の開始時刻と、対象となる活動の終了時刻が照合されます。
- 条件が満たされている間は、オプションのデバッグ文が出力されます。
- 貪欲な範囲は、アクティビティ配列内の次のインデックスに進みます。
...
if ( greedy_extent <= MAX_ACTIVITIES )
    {

   	 return activity_select(greedy_extent);
    }
    else
    {
   	 return NULL;
    }
}

コードの説明:
- この条件式は、すべての活動が網羅されているかどうかを確認します。
- そうでない場合、アルゴリズムは現在のインデックスから貪欲探索を再開します。これは、問題を貪欲に分割する再帰的なステップです。
- はいの場合、制御は呼び出し元に戻り、貪欲さを拡張する余地はなくなります。
int main()
{
    Scheduler *activity_sched = new Scheduler();
    activity_sched->scheduled = activity_sched->activity_select(
   				activity_sched->considered_index);
    return 0;
}

コードの説明:
- メイン関数はスケジューラを呼び出します。
- 新しいスケジューラオブジェクトがインスタンス化されます。
- activity_select() 関数は、貪欲な探索が終了すると、呼び出し元に Activity ポインターを返します。
出力:
START:7 END 7

START:9 END 10

START:5 END 6

START:10 END 10

START:9 END 10

Schedule start:5
finish6
 activity:3

Schedule start:9
finish10
 activity:5
貪欲な手法の限界
貪欲法は、ソート問題のように、各部分問題ごとに最適な解を必要とする問題には適していません。
このような場合、貪欲法は誤りとなる可能性があり、最悪の場合、最適解ではない解を導き出すことになる。
貪欲アルゴリズムの根本的な欠点は、現在の貪欲な状態の先に何があるかを知らずに選択してしまう点にある。
下の図は、貪欲法のこの欠点を示しています。

ここに木として示されている貪欲スキャン(値が大きいほど貪欲度が高い)では、値が40のアルゴリズムは次に29を選択し、最後に12を選択して、合計41になります。
対照的に、分割統治戦略では、25に続いて40が加わり、合計65となり、局所的に貪欲な選択よりも24ポイント高くなります。
貪欲の例 Algorithms
ほとんどのネットワークアルゴリズムは貪欲法に基づいています。一般的な貪欲アルゴリズムの例としては、以下のようなものがあります。
- プリムの最小全域木アルゴリズム
- 巡回セールスマン問題(概算)
- グラフマップの色付け
- クラスカルの最小全域木アルゴリズム
- ダイクストラの最短経路アルゴリズム
- グラフ頂点カバー
- ナップサック問題
- 締め切り付きの作業順序付け
