
INDEX を作成してドロップする Cassandra
 デビッドカーター
⚡ スマートサマリー
インデックスを作成して削除します Cassandra 主キーに含まれていない列でフィルタリングが可能になります。このページでは、CREATE INDEXコマンドとDROP INDEXコマンド、命名規則、利用可能なインデックスの種類、およびインデックスが不適切な場合について説明します。
Cassandra インデックスの作成
コマンド「インデックスの作成」は、ユーザーが指定した列にインデックスを作成します。インデックスを作成する列のデータがすでに存在する場合は、 Cassandra 「create Index」ステートメントの実行中にデータにインデックスを作成します。
- インデックスを作成したら、 Cassandra データが挿入されると、新しいデータに自動的にインデックスが付けられます。
- 主キーにはすでにインデックスが作成されているため、主キーにインデックスを作成できません。
- コレクション列に対するインデックスはサポートされており、検索対象に応じてKEYS、VALUES、またはENTRIES形式を使用できます。
- 列にインデックスを付けないと、 Cassandra その列が主キーでない限り、その列をフィルタリングすることはできません。
そのため、列をフィルタリングするには Cassandraインデックスを作成する必要があります。
構文
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
例:
これは、インデックスを作成せずに「dept」列をフィルタリングしようとしたスナップショットです。 応答として、エラーが返されました。

これは、dept 列にインデックスが作成されたスナップショットです。

CREATE INDEX DeptIndex ON University.Student (dept);
これは、「dept」列が正常にフィルタリングされたスナップショットです。

SELECT * FROM University.Student WHERE dept = 'CS';
インデックス名は省略可能です。省略すると Cassandra インデックスを自動的に生成する。これは、後でインデックスを削除する必要が生じた場合に重要となる。
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra インデックスを削除
コマンド「インデックスを削除」は、指定されたインデックスを削除します。 インデックスの作成時にインデックス名が指定されなかった場合、インデックス名は TableName_ColumnName_idx になります。
- インデックスが存在しない場合は、何も行わずに返す IF EXISTS が使用されない限り、エラーが返されます。
- インデックス名にはキースペース名を指定する必要があります。そうしないと、インデックスは現在のキースペース内で検索されます。
構文
DROP INDEX IF EXISTS KeyspaceName.IndexName;
例:
これは、インデックス DeptIndex を削除する実行されたコマンド「Drop Index」のスナップショットです。
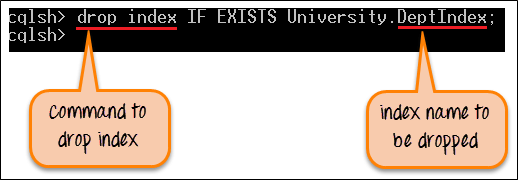
DROP INDEX IF EXISTS University.DeptIndex;
コマンドが正常に実行されると、DeptIndex がキースペースから削除されます。 現在、データを列部門でフィルタリングすることはできません。
削除前にどのインデックスが存在するかを確認するping 1つ目は、テーブルの説明と、出力の下部にあるインデックス定義を読むことです。
DESCRIBE TABLE University.Student;
インデックスの種類 Cassandra
上記のコマンドは標準的なセカンダリインデックスを作成しますが、3つの異なるメカニズムが存在し、それぞれ動作が大きく異なります。
| タイプ | 仕組み | ベスト |
|---|---|---|
| 二次索引 | 各ノードは自身のローカルデータのみをインデックス化するため、パーティションキーのないクエリはすべてのノードにアクセスする必要がある。 | パーティションキーとともにクエリされる、中程度のカーディナリティを持つ列。 |
| SASI指数 | LIKE接頭辞と接尾辞のマッチング、および数値範囲をサポートする添付インデックス。 | テキスト検索パターン。まだ実験段階のため、本番環境で使用する前にテストしてください。 |
| ストレージ添付インデックス(SAI) | 導入された Cassandra 5.0では、列間で1つのインデックス構造を共有することで、書き込みオーバーヘッドを低減しています。 | 上記2つの現代版は Cassandra 5つのクラスター。 |
コレクション列にインデックスを付けるには、インデックスを付ける部分を指定する修飾子を使用します。
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES はセットまたはリストの要素を検索し、KEYS はマップキーを検索し、ENTRIES はキーと値のペアを照合します。コレクションのインデックスについては、 Cassandra コレクション チュートリアル。
インデックスを使用しない場合 Cassandra
セカンダリインデックスは便利ですが、リレーショナルインデックスではありません。また、セカンダリインデックスを誤った場所で使用すると、クラスタリングが遅くなる一般的な原因となります。次の4つの状況では、異なるアプローチが必要です。
- 非常に高い基数性。 メールアドレスなど、ほぼ一意なデータをインデックス化すると、ほぼすべてのパーティションに一致する行が1つずつ保持されるため、クエリはクラスタ全体に分散して実行され、最終的に1つのレコードが返されます。
- カーディナリティが非常に低い。 アクティブまたは非アクティブといった2値フラグにインデックスを作成すると、膨大なインデックスパーティションが生成され、そのうちの1つを読み取るとテーブルの半分が返されます。
- 頻繁に更新されるコラム。 変更があるたびにインデックスエントリが書き込まれ、古いエントリの削除情報(トゥームストーン)も書き込まれるため、トゥームストーンが蓄積されると、時間の経過とともに読み取り速度が低下します。
- パーティションキーのないクエリ。 それがなければ、コーディネーターはすべてのノードに連絡して結果を統合する必要があり、ノードが増えるにつれて拡張性が失われる。
耐久性のある代替案は、検索が必要な列をキーとする 2 番目のテーブルを、最初のテーブルと同時に書き込むことです。これは、クエリ優先の原則に従っています。 Cassandra データモデルルールそして、すべての読み取りを単一ノード上の単一パーティションに保持します。
一般的に、インデックスは、既知のパーティションキーとともにクエリされる、中程度のカーディナリティを持つ列に適しています。それ以外の場合は、専用のテーブルを作成する方が適しています。
