
Cassandra コレクション: CQL での設定、リスト、マップと例
 デビッドカーター
⚡ スマートサマリー
Cassandra コレクションは、セット、リスト、マップの各型を使用して、単一の列内に複数の値を格納します。このページでは、各型、コレクションの作成とデータ投入のためのCQL構文、要素の更新方法、およびコレクションが不適切な場合を判断するサイズ制限について説明します。
何ですか Cassandra コレクション?
Cassandra コレクションはタスクを処理するための良い方法です。複数の要素をコレクションに保存できます。には制限があります Cassandra コレクション
- コレクション列は、単一の値に64KBを超えるデータを格納できません。
- コレクションをクエリする際のオーバーヘッドを避けるため、コレクションのサイズは小さく保ってください。必要な要素が1つだけの場合でも、コレクション全体が読み込まれるためです。
- 64KBを超えるデータを保存すると、最初の64KBしかクエリできないため、データが失われることになる。
- 凍結されていないコレクションは、およそ65,535個の要素に限定されており、各要素は1つの単位としてまとめて読み取られます。
これらの制限は、一つのルールを示しています。コレクションは、行に付随する少数の属性に適しており、使用に伴って増え続ける無制限のリストには適していません。増え続けるものはすべて、独自のテーブルのクラスタリング列に含めるべきです。
の種類 Cassandra コレクション
コレクションには主に3つのタイプがあります。 Cassandra サポート:
- 作成セッションプロセスで
- リスト
- 地図
Cassandra セットコレクション
Set には、クエリ時に並べ替えられた要素を返す要素のグループが格納されます。
構文
以下は、教師の複数の電子メール アドレスを保存する Set コレクションの構文です。
CREATE TABLE University.Teacher (
    id int,
    Name text,
    Email set<text>,
    PRIMARY KEY (id)
);
例:
これは、「Email」列をコレクションとして含むテーブル「Teacher」が作成されたスナップショットです。

これは、データがコレクションに挿入されているスナップショットです。

INSERT INTO University.Teacher (id, Name, Email)
VALUES (1, 'Guru99', {'abc@gmail.com', 'xyz@hotmail.com'});
コレクション全体を書き換えることなく個々の要素を追加または削除できるのが、コレクションを凍結しない主な利点です。
UPDATE University.Teacher SET Email = Email + {'new@guru99.com'} WHERE id = 1;
UPDATE University.Teacher SET Email = Email - {'xyz@hotmail.com'} WHERE id = 1;
Cassandra リストコレクション
要素の順序が重要な場合は、リストが使用されます。
例:
以下は、「教師」テーブルにリスト型の列「コース」が追加された際のスナップショットです。
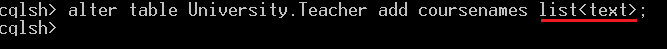
ALTER TABLE University.Teacher ADD coursenames list<text>;
これは、データが「coursenames」列に挿入されているスナップショットです。
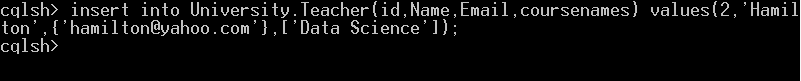
INSERT INTO University.Teacher (id, Name, Email, coursenames)
VALUES (2, 'Hamilton', {'hamilton@hotmail.com'}, ['Data Science']);
以下は、挿入後の現在のデータベースの状態を示すスナップショットです。

要素は追加または前置できますが、インデックスによる前置と更新にはどちらも Cassandra リストを最初に読み込むため、追加するよりも処理速度が遅くなります。
UPDATE University.Teacher SET coursenames = coursenames + ['Machine Learning'] WHERE id = 2;
UPDATE University.Teacher SET coursenames = ['Statistics'] + coursenames WHERE id = 2;
Cassandra マップコレクション
マップは、キーと値のペアを格納するために使用されるコレクション タイプです。 その名前が示すように、あるものを別のものにマッピングします。
たとえば、コース名をその前提コース名と一緒に保存したい場合は、マップ コレクションを使用できます。
例:
以下は、コース名とその前提条件となるコース名に対してマップ タイプが作成されたスナップショットです。

CREATE TABLE University.Course (
    id int,
    prereq map<text, text>,
    PRIMARY KEY (id)
);
これは、マップ コレクション タイプでデータが挿入されているスナップショットです。

INSERT INTO University.Course (id, prereq)
VALUES (1, {'DataScience': 'Database', 'Neural Network': 'Artificial Intelligence'});
単一のエントリを設定または削除するだけで、マップの他の部分には影響を与えません。
UPDATE University.Course SET prereq['Robotics'] = 'Linear Algebra' WHERE id = 1;
DELETE prereq['DataScience'] FROM University.Course WHERE id = 1;
セット vs リスト vs マップ:コレクションの選択
この3種類は見た目は似ているが、注文保証と更新費用が異なる。
| 側面 | 作成セッションプロセスで | リスト | 地図 |
|---|---|---|---|
| 購入 | 値でソート | 挿入順序は保持されます | キーでソート |
| 重複 | 許可されていない | 許可 | キーはユニーク |
| 更新コスト | 安価で、読む必要もありません。 | 追加は安価。先頭への追加とインデックスの更新には読み取りが必要。 | キーあたりの価格が安い |
| ベスト | タグ、メールアドレス、固有のラベル | 重複が意味を持つ順序付けられた手順 | 予測不可能なキーを持つ名前付き属性 |
順序が本当に重要でない限り、リストよりもセットを優先してください。リストのインデックス操作は墓石を作成し、同時書き込み時に予期しない結果を生み出す可能性があるためです。 凍結 3 つのいずれにも、それを 1 つの不変の値として格納します。これにより、コレクションは主キーに表示されるようになりますが、要素レベルの更新はできなくなります。
CREATE TABLE University.Enrolment (
    id int,
    tags frozen<set<text>>,
    PRIMARY KEY (id, tags)
);
コレクションが数十個の要素を超える場合は、要素をクラスタリング列として別のテーブルとしてモデル化し、 Cassandra データモデルルールコレクションの内容でフィルタリングするにはインデックスが必要です。 インデックスの作成と削除 チュートリアル。
