
Tutoriel Scikit-Learn : Comment installer et exemples Scikit-Learn
 Équipe éditoriale
⚡ Résumé intelligent
Scikit-learn est un logiciel libre. Python bibliothèque qui couvre le prétraitement, la classification, la régression, le clustering et la sélection de modèles derrière une interface d'estimation unique et cohérente, ce qui permet de maintenir un flux de travail d'apprentissage automatique complet court, lisible et reproductible, des données brutes aux prédictions notées.
Qu'est-ce que Scikit-learn ?
Scikit-apprendre est un open-source Python bibliothèque pour machine learningIl prend en charge des algorithmes bien établis tels que KNN, le gradient boosting, les forêts aléatoires et les SVM, et il est construit sur la base de NumPy Scikit-learn est largement utilisé dans les compétitions Kaggle ainsi que dans de grandes entreprises technologiques. Il couvre le prétraitement, la réduction de dimensionnalité, la classification, la régression, le clustering et la sélection de modèles.
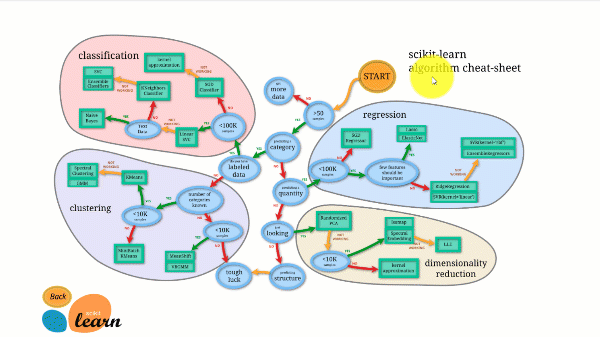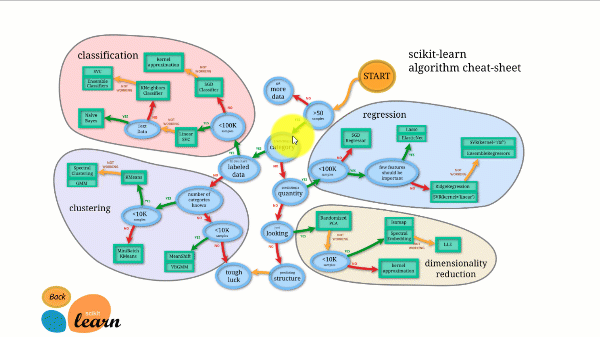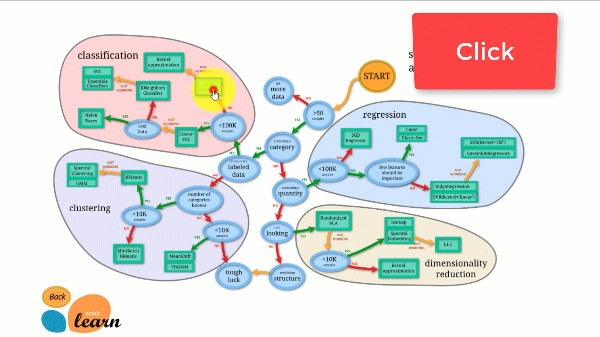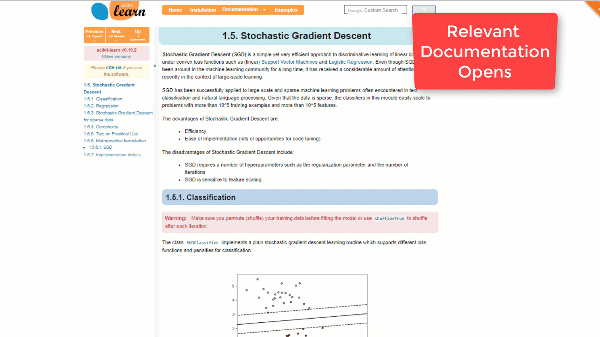
Scikit-learn possède l'une des meilleures documentations parmi les bibliothèques open-source. Elle propose même un graphique d'estimation interactif. Choisir le bon estimateur, qui vous guide de la taille de votre ensemble de données à une liste restreinte d'algorithmes à essayer.
La figure ci-dessous illustre le fonctionnement de Scikit-learn.
Scikit-learn est facile à utiliser et donne d'excellents résultats. Cependant, il s'exécute sur le CPU : le travail est parallélisé sur plusieurs cœurs avec l'argument `n_jobs` plutôt que sur un GPU. Il est possible d'exécuter un algorithme d'apprentissage profond avec, mais c'est rarement optimal, surtout si vous savez déjà comment l'utiliser. TensorFlow.
Comment télécharger et installer Scikit-learn
Maintenant dans ce Python Tutoriel Scikit-learn : vous apprendrez à télécharger et à installer Scikit-learn :
Option 1 : AWS
Scikit-learn peut être utilisé sur AWS. Une image Docker avec scikit-learn préinstallé permet de s'affranchir entièrement de la configuration.
Pour installer la version développeur, exécutez la commande ci-dessous dans Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Option 2 : Mac ou Windows utiliser Anaconda
Pour en savoir plus sur l'installation d'Anaconda, consultez la documentation. Comment télécharger et installer TensorFlow.
Au moment de la rédaction de ce guide, les développeurs de scikit-learn avaient publié une version de développement corrigeant les problèmes présents dans la version stable alors en vigueur. Les étapes ci-dessous utilisent donc cette version de développement. Sur une machine neuve, la version stable actuelle contient déjà tous les transformateurs utilisés ici. pip install -U scikit-learn est assez.
Comment installer scikit-learn avec l'environnement Conda
Si vous avez installé scikit-learn avec l'environnement conda, suivez les étapes ci-dessous pour effectuer la mise à jour vers la version 0.20.
Étape 1) Activer l'environnement TensorFlow
source activate hello-tf
Étape 2) Supprimez scikit-learn à l'aide de la commande conda
conda remove scikit-learn
Étape 3) Installez la version développeur
Installez la version développeur de scikit-learn ainsi que les bibliothèques nécessaires.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
NOTE: Windows les utilisateurs ont besoin Microsoft Visuel C++ 14. Vous pouvez l'obtenir ici.
Exemple Scikit-Learn avec l'apprentissage automatique
Ce didacticiel Scikit est divisé en deux parties :
- Apprentissage automatique avec scikit-learn
- Comment faire confiance à votre modèle avec LIME
La première partie explique en détail comment construire un pipeline, créer un modèle et optimiser les hyperparamètres, tandis que la seconde partie traite de l'interprétation du modèle.
Étape 1) Importez les données
Dans ce tutoriel Scikit-learn, vous utiliserez l'ensemble de données du recensement des adultes.
Le fichier est lu directement depuis le dépôt d'apprentissage automatique de l'UCI dans le code ci-dessous ; aucun téléchargement manuel n'est donc nécessaire. Si les statistiques descriptives vous intéressent, les outils « Dive » et « Overview » méritent d'être explorés. Voir : ce tuto pour en savoir plus sur la plongée et la présentation générale.
Vous importez le jeu de données avec pandas. Notez qu'il est nécessaire de convertir les variables continues au format float.
Cet ensemble de données comprend huit variables catégorielles, répertoriées dans CATE_FEATURES :
- classe ouvrière
- l'éducation
- matrimonial
- occupation
- relations
- breed
- sexe
- pays d'origine
Il comprend également six variables continues, répertoriées dans CONTI_FEATURES :
- âge
- fnlwgt
- num_education
- gain_capital
- perte_de_capital
- heures_semaine
Les listes sont remplies manuellement ici afin de mieux visualiser les colonnes concernées. Voici une méthode plus rapide pour créer une liste de colonnes catégorielles ou continues :
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Voici le code pour importer les données :
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
L'appel à la fonction describe() sur le cadre renvoie les statistiques récapitulatives pour les six colonnes continues :
| âge | fnlwgt | num_education | gain_capital | perte_de_capital | heures_semaine | |
|---|---|---|---|---|---|---|
| compter | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| signifier | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| std | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| min | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25 % | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50 % | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75 % | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| max | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Vous pouvez vérifier le nombre de valeurs uniques de la variable native_country. Un seul foyer provient des Pays-Bas. Ce foyer ne fournit aucune information et générera une erreur lors de l'entraînement.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Vous pouvez exclure cette ligne non informative de l'ensemble de données :
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
Ensuite, vous stockez la position des entités continues dans une liste. Vous en aurez besoin à l'étape suivante pour construire le pipeline.
Le code ci-dessous parcourt tous les noms de colonnes dans CONTI_FEATURES, lit chaque emplacement (c'est-à-dire son numéro de colonne) et l'ajoute à une liste appelée conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
Le bloc suivant effectue la même tâche pour les variables catégorielles.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Examinons maintenant l'ensemble de données lui-même. Chaque variable catégorielle est une chaîne de caractères, et un modèle ne peut pas recevoir une valeur de type chaîne de caractères ; il est donc nécessaire de transformer l'ensemble de données à l'aide de variables indicatrices.
df_train.head(5)
En réalité, il vous faut une colonne par groupe pour chaque caractéristique. Commencez par exécuter le code ci-dessous pour calculer le nombre total de colonnes nécessaires.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
L'ensemble de données comprend 101 groupes, comme indiqué ci-dessus. La variable « classe professionnelle » compte à elle seule neuf groupes. Vous pouvez afficher les noms des groupes avec le code ci-dessous ; la fonction `unique()` renvoie les valeurs distinctes de chaque variable catégorielle.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
L'ensemble de données d'entraînement contiendra donc 101 + 6 colonnes : les groupes one-hot plus les six caractéristiques continues.
Scikit-learn peut se charger de la conversion, en deux étapes :
- Convertissez la chaîne en un identifiant. « State-gov » devient l’identifiant 1, « Self-emp-not-inc » devient l’identifiant 2, et ainsi de suite. LabelEncoder effectue cette opération automatiquement.
- Transposez chaque identifiant dans une nouvelle colonne. L'ensemble de données comporte 101 identifiants de groupe ; il y aura donc 101 colonnes, une pour chaque groupe de variables catégorielles. Scikit-learn propose l'encodeur OneHotEncoder pour cette opération.
Étape 2) Créer l'ensemble d'entraînement/test
Maintenant que l'ensemble de données est prêt, divisez-le en 80/20 : 80 % pour l'ensemble d'entraînement et 20 % pour l'ensemble de test.
Vous pouvez utiliser la fonction `train_test_split`. Le premier argument est le dataframe des caractéristiques et le second, l'étiquette. Vous définissez la taille de l'ensemble de test avec `test_size`.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Étape 3) Construire le pipeline
Le pipeline facilite l'alimentation du modèle avec des données cohérentes. Le principe est de faire transiter les données brutes par un objet unique qui effectue chaque opération séquentiellement.
Avec cet ensemble de données, il est nécessaire de standardiser les variables continues et de convertir les variables catégorielles. Toute opération peut être intégrée à un pipeline : les valeurs manquantes peuvent être remplacées par la moyenne ou la médiane, et de nouvelles variables peuvent être créées.
Vous avez le choix : coder en dur les deux processus ou créer un pipeline. Le codage en dur peut introduire des données de test dans les statistiques d'ajustement et engendrer des incohérences au fil du temps ; le pipeline est donc préférable.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
Le pipeline effectue deux opérations avant d'alimenter le classificateur logistique :
- Normaliser la variable : StandardScaler()
- Convertissez les fonctionnalités catégorielles : OneHotEncoder(sparse=False)
Vous effectuez les deux étapes avec `make_column_transformer`. Lors de la rédaction de ce guide, cette fonction n'était pas présente dans la version publiée de scikit-learn (0.19), c'est pourquoi la version de développement a été utilisée ; elle est incluse dans toutes les versions stables depuis la version 0.20.
La fonction make_column_transformer est simple : vous déclarez les colonnes à transformer et la transformation à appliquer. Pour standardiser les caractéristiques continues, vous transmettez :
- conti_features, StandardScaler() dans make_column_transformer
- conti_features : la liste des colonnes continues
- StandardScaler : normalise ces colonnes
L'objet OneHotEncoder à l'intérieur de make_column_transformer encode automatiquement les étiquettes.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Note de version : Deux arguments du bloc ci-dessus ont évolué. Les versions actuelles s'attendent à traiter d'abord le transformateur, puis les colonnes. clairsemé ce qui a été renommé sortie clairsemée présent dans scikit-learn 1.2 et supprimé dans la version 1.4, donc le code plus récent se lit comme suit : OneHotEncoder(sparse_output=False).
Vous pouvez vérifier le bon fonctionnement du pipeline avec la fonction `fit_transform`. Le résultat devrait avoir la forme 26048, 107.
preprocess.fit_transform(X_train).shape
(26048, 107)
Le transformateur de données est prêt. Vous créez le pipeline avec make_pipeline, et une fois les données transformées, vous les injectez dans la régression logistique.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Entraîner un modèle avec scikit-learn est alors très simple : il suffit d’appeler la fonction `fit` sur le pipeline. Vous pouvez ensuite afficher la précision avec la méthode `score`.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Enfin, vous pouvez prédire les classes avec `predict_proba`, qui renvoie la probabilité de chaque classe. Notez que la somme des deux probabilités est égale à un.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Étape 4) Utilisation de notre pipeline dans une recherche de grille
Le réglage des hyperparamètres, c'est-à-dire les valeurs qui déterminent la structure du modèle, peut être fastidieux et épuisant.
Une méthode d'évaluation du modèle consisterait à modifier la taille de l'ensemble d'entraînement et à mesurer ses performances, en répétant l'exercice dix fois afin d'observer la dispersion des résultats. Cela représente un travail manuel considérable.
En revanche, scikit-learn fournit des fonctions qui effectuent pour vous le réglage des paramètres et la validation croisée.
Validation croisée
La validation croisée consiste à diviser l'ensemble d'entraînement en n sous-ensembles et à évaluer le modèle n fois. Si `cv` est fixé à 10, le modèle est entraîné et évalué dix fois. À chaque itération, le classificateur est entraîné sur neuf sous-ensembles choisis aléatoirement, le dixième étant conservé pour l'évaluation.
Grille de recherche
Chaque classificateur possède des hyperparamètres à optimiser. Vous pouvez tester différentes valeurs une à une ou utiliser une grille de paramètres. La documentation de scikit-learn répertorie tous les paramètres acceptés par le classificateur logistique. Pour accélérer l'entraînement, cet exemple n'optimise que le paramètre C, qui contrôle la régularisation. Ce paramètre doit être positif ; une petite valeur augmente l'importance de la régularisation.
Vous utilisez l'objet GridSearchCV, qui prend en paramètre un dictionnaire des hyperparamètres à optimiser. Indiquez chaque hyperparamètre suivi des valeurs que vous souhaitez tester. Pour optimiser C, vous écrivez :
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — le nom du paramètre est précédé du nom du classificateur en minuscules et de deux traits de soulignement.
Le modèle essaiera quatre valeurs différentes : 0.001, 0.01, 0.1 et 1. Il est entraîné avec 10 plis, c’est-à-dire cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Vous pouvez maintenant entraîner le modèle en utilisant GridSearchCV avec les paramètres grid et cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
Sortie :
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Note de version : le iid L'argument visible dans cette sortie a été déprécié dans scikit-learn 0.22 et supprimé dans 0.24, il devrait donc simplement être supprimé de l'appel GridSearchCV dans les versions actuelles.
Pour accéder aux meilleurs paramètres, utilisez best_params_.
grid_clf.best_params_
Sortie :
{'logisticregression__C': 1.0}
Après avoir entraîné le modèle avec quatre valeurs de régularisation différentes, le paramètre optimal donne :
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
meilleure régression logistique à partir de la recherche par grille : 0.850891
Pour accéder aux probabilités prédites :
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
Modèle XGBoost avec scikit-learn
Essayez maintenant l'un des classificateurs les plus performants du marché. XGBoost est une amélioration de la forêt aléatoire par gradient boosting. Son cadre théorique dépasse le cadre de cet article. Python Ce tutoriel Scikit-learn est utile, mais n'oubliez pas que XGBoost a remporté de nombreuses compétitions Kaggle. Sur un jeu de données de taille moyenne, ses performances peuvent égaler, voire surpasser, celles d'un algorithme d'apprentissage profond.
Le classificateur est difficile à entraîner car il comporte un grand nombre de paramètres. Vous pouvez bien sûr utiliser GridSearchCV pour les sélectionner automatiquement.
Une meilleure option est RandomizedSearchCV. GridSearchCV devient lent lorsque la grille est grande, car l'espace de recherche s'étend à chaque paramètre ajouté. RandomizedSearchCV, quant à lui, échantillonne aléatoirement les valeurs de chaque hyperparamètre à chaque itération, ce qui permet d'évaluer 1 000 combinaisons en 1 000 itérations. Son fonctionnement est par ailleurs très similaire à celui de GridSearchCV.
Vous devez importer xgboost. Si la bibliothèque n'est pas installée, exécutez `pip3 install xgboost`, ou installez-la depuis un répertoire `/etc/xgboost`. Jupyter carnet contenant :
use import sys
!{sys.executable} -m pip install xgboost
Importez ensuite le classificateur et les deux assistants de recherche :
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
La prochaine étape de ce Scikit Python Ce tutoriel explique comment spécifier les paramètres à optimiser. La documentation officielle de XGBoost les répertorie tous. Python Dans le tutoriel Sklearn, vous ne choisissez que deux hyperparamètres avec deux valeurs chacun, car l'entraînement de XGBoost est long et chaque point de grille supplémentaire allonge le temps d'attente.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Vous construisez ensuite un nouveau pipeline avec le classificateur XGBoost et 600 estimateurs. Le paramètre `n_estimators` est ajustable, et une valeur élevée peut entraîner un surapprentissage. Vous pouvez tester d'autres valeurs, mais sachez que cela peut prendre plusieurs heures. Tous les autres paramètres conservent leur valeur par défaut.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Vous pouvez améliorer la validation croisée grâce à l'algorithme de validation croisée K-Folds stratifié. Seuls trois plis sont utilisés ici afin d'accélérer le calcul, au détriment de la qualité ; augmentez ce nombre à 5 ou 10 sur votre machine pour de meilleurs résultats. Le modèle est entraîné sur quatre itérations.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
La recherche aléatoire est prête, vous pouvez donc entraîner le modèle.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Comme vous pouvez le constater, XGBoost obtient de meilleurs résultats que la régression logistique précédente.
print("Meilleur parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
Meilleur parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Créer un DNN avec MLPClassifier dans scikit-learn
Enfin, vous pouvez entraîner un réseau de neurones directement avec scikit-learn. La méthode est identique à celle utilisée pour tout autre classificateur, et l'estimateur est MLPClassifier.
from sklearn.neural_network import MLPClassifier
Le réseau ci-dessous est défini par :
- Solveur d'Adam
- Fonction d'activation ReLU
- Alpha = 0.0001
- Lot de 150
- Deux couches cachées avec respectivement 200 et 100 neurones
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Vous pouvez modifier le nombre de couches pour améliorer le modèle.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
Score de régression DNN : 0.821253
LIME : faites confiance à votre modèle
Maintenant que vous disposez d'un bon modèle, il vous faut un moyen de lui faire confiance. Les algorithmes d'apprentissage automatique, notamment les forêts aléatoires et les réseaux de neurones, sont connus comme des modèles « boîte noire » : ils fonctionnent, mais personne ne peut comprendre pourquoi.
Trois chercheurs ont conçu un outil qui montre comment l'ordinateur parvient à une prédiction. Leur article est : « Pourquoi devrais-je vous faire confiance ? », et l'algorithme qu'ils ont publié s'appelle Local Interpretable Model-Agnostic Explanations (LIME).
Prenons un exemple. Il arrive qu'on ignore la fiabilité d'une prédiction issue de l'apprentissage automatique. Un médecin ne peut accepter un diagnostic simplement parce qu'il a été établi par un ordinateur, et il est indispensable de vérifier la fiabilité d'un modèle avant sa mise en production.
Imaginez pouvoir comprendre pourquoi un classificateur a effectué une prédiction, même pour des modèles aussi complexes que les réseaux de neurones, les forêts aléatoires ou les SVM avec un noyau arbitraire. Il devient bien plus facile de faire confiance à une prédiction lorsque les raisons qui la sous-tendent sont visibles, et tout aussi facile de déterminer quand un modèle n'est pas fiable. LIME vous indique quelles caractéristiques ont influencé la décision du classificateur.
Préparation des données
Vous devez modifier quelques éléments pour faire fonctionner LIME avec PythonCommencez par installer Lime dans le terminal avec la commande `pip install lime`.
Lime utilise un objet LimeTabularExplainer pour approximer le modèle localement. Cet objet nécessite :
- un ensemble de données dans NumPy le format
- Le nom des fonctionnalités : feature_names
- Le nom des classes : class_names
- L'index de la colonne des caractéristiques catégorielles : categorical_features
- Nom du groupe pour chaque variable catégorielle : categorical_names
Créer l'ensemble d'entraînement NumPy
Vous pouvez très facilement copier et convertir df_train de pandas en NumPy.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Obtenez le nom de la classe
L'étiquette est accessible via unique(). Vous devriez voir :
- «<= 50 »
- «> 50 »
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Indexez les colonnes de caractéristiques catégorielles
Utilisez la méthode apprise précédemment pour obtenir le nom de chaque groupe. Encodez l'étiquette avec LabelEncoder et répétez l'opération pour chaque variable catégorielle.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Maintenant que le jeu de données est prêt, vous pouvez créer les différents jeux de données présentés dans les exemples Scikit-learn ci-dessous. Les données sont transformées en dehors du pipeline afin d'éviter les erreurs avec LIME : l'ensemble d'entraînement transmis à LimeTabularExplainer doit être un tableau NumPy sans chaînes de caractères, et la méthode ci-dessus en a déjà produit un.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Vous pouvez créer le pipeline avec les paramètres optimaux trouvés par XGBoost.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Vous recevez un avertissement indiquant qu'il n'est pas nécessaire de créer un encodeur d'étiquettes avant le pipeline. Si vous n'utilisez pas LIME, la méthode décrite dans la première partie de ce tutoriel « Apprentissage automatique avec Scikit-learn » convient. Sinon, suivez cette approche : commencez par créer un jeu de données encodé, puis appliquez l'encodeur one-hot au sein du pipeline.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Avant d'utiliser LIME, créez un tableau NumPy contenant les caractéristiques des lignes mal classées. Vous pourrez ensuite utiliser cette liste pour identifier les erreurs de classification.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Vous créez ensuite une fonction lambda qui récupère la prédiction du modèle pour de nouvelles données. Vous en aurez besoin prochainement.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Vous convertissez le dataframe pandas en un tableau NumPy.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Choisissez maintenant un ménage au hasard dans l'ensemble de test et observez la prédiction ainsi que la méthode utilisée par l'ordinateur pour y parvenir.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Vous pouvez utiliser l'outil d'explication avec `explain_instance` pour examiner le raisonnement sous-jacent au modèle. Le graphique généré est présenté ci-dessous.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Le classificateur a correctement prédit ce ménage : le revenu est effectivement supérieur à 50 000.
Il convient de noter en premier lieu que le classificateur manque de précision. Il prédit un revenu supérieur à 50 64 avec une probabilité de 64 %, cette probabilité étant influencée par la plus-value et la situation matrimoniale. La couleur bleue contribue négativement à la classe positive, tandis que la ligne orange y contribue positivement.
Le système de classification hésite car la plus-value de ce ménage est nulle, alors que celle-ci est généralement un bon indicateur de richesse. De plus, ce ménage travaille moins de 40 heures par semaine. L'âge, la profession et le sexe sont tous des facteurs positifs.
Si le statut matrimonial était célibataire, le classificateur aurait prédit un revenu inférieur à 50 000 (0.64 – 0.18 = 0.46).
Essayez maintenant un autre ménage, un ménage qui a été mal classé. Le tableau explicatif correspondant suit le code.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Le classificateur a prédit un revenu inférieur à 50 000 €, ce qui est erroné. Ce ménage est atypique : il ne présente ni plus-value ni moins-value, la personne est divorcée, proche de la soixantaine et a un niveau d’études élevé (niveau d’études supérieur à 12). Conformément à la tendance générale, le classificateur a attribué à ce ménage un revenu inférieur à 50 000 €.
Testez LIME vous-même et vous constaterez de nombreuses erreurs grossières de la part du classificateur. Le dépôt GitHub de l'auteur de la bibliothèque contient une documentation supplémentaire pour la classification d'images et de textes.
Référence des commandes Scikit-learn
Vous trouverez ci-dessous une liste de commandes utiles qui s'appliquent à scikit-learn version 0.20 et ultérieures.
| Tâche | Fonction ou classe |
|---|---|
| Créer l'ensemble de données d'entraînement/de test | train_test_split |
| Construire un pipeline | |
| Sélectionnez les colonnes et appliquez la transformation | transformer_colonne |
| Type de transformation | |
| Standardiser | Échelle standard |
| Mise à l'échelle min-max | MinMaxScaler |
| Normaliser | Normalizer |
| Imputer les valeurs manquantes | SimpleImputeur |
| Convertir catégorique | OneHotEncoder |
| Ajuster et transformer les données | fit_transformer |
| Faire le pipeline | make_pipeline |
| Modèle de base | |
| Régression logistique | Régression logistique |
| Le modèle XGBoost, intégrant caractéristiques radiomiques et quatre variables cliniques (site de la tumeur primaire [cavité buccale], TNM, âge et tabagisme), s’est avéré être le meilleur modèle de prédiction pour la progression à ans. Ce dernier a permis d’obtenir une AUC de , une sensibilité de , une spécificité de et une précision de . Nos efforts se concentrent désormais sur l’augmentation de la taille de l’échantillon afin de valider ce modèle et d’évaluer les résultats de la survie sans progression, dans le but de fournir aux cliniciens un score de risque pour une catégorisation plus précise des patients sur la base des TDM de diagnostic. | XGBClassificateur |
| Réseau de neurones | Classificateur MLP |
| Grille de recherche | GridSearchCV |
| Recherche aléatoire | RechercheRandomiséeCV |
