
Tutoriel Apache Oozie : Diagramme de flux de travail, Planificateur
 Prafulla Ranadive
⚡ Résumé intelligent
Apache Oozie est le planificateur de flux de travail pour Hadoop qui exécute les tâches dépendantes sous forme de graphes acycliques orientés, combinant un moteur de flux de travail pour les actions MapReduce, Pig et Hive avec un moteur de coordination piloté par le temps et la disponibilité des données.
Qu'est-ce que l'Apache Oozie ?
Apache Oozie est un planificateur de flux de travail pour HadoopIl s'agit d'un système qui gère le flux de travail de tâches dépendantes. Les utilisateurs peuvent y créer des graphes acycliques orientés de flux de travail, exécutables en parallèle et séquentiellement dans Hadoop.
Il se compose de deux parties :
- Moteur de workflow : La responsabilité d'un moteur de workflow est de stocker et d'exécuter des workflows composés de tâches Hadoop, par exemple, MapReduce, Cochon, Ruche.
- Moteur coordinateur : Il exécute les tâches de flux de travail en fonction de planifications prédéfinies et de la disponibilité des données.
Oozie est évolutif et peut gérer l'exécution en temps voulu de milliers de workflows (chacun composé de plusieurs dizaines de tâches) au sein d'un cluster Hadoop. Le schéma ci-dessous illustre la position du planificateur par rapport au cluster et aux tâches qu'il exécute.

Oozie est également très flexible. Il est facile de démarrer, d'arrêter, de suspendre et de relancer des tâches. Oozie simplifie grandement la reprise des workflows ayant échoué. On comprend aisément la difficulté de rattraper les tâches manquées ou ayant échoué en raison d'une interruption de service ou d'une panne. Il est même possible d'ignorer un nœud défaillant spécifique.
État du projet : Apache Oozie a été retiré du service par Apache Software. Foundation en février 2025 et le déménagement vers le Grenier Apache Le développement s'est achevé en avril 2025. La version finale reste la 5.2.1 de février 2021, et le dépôt de code source est désormais en lecture seule. Les clusters existants continuent de l'exécuter, d'où l'intérêt de connaître les mécanismes décrits ci-dessous, mais les nouveaux pipelines sont généralement construits sur Apache Airflow.
Comment fonctionne Oozie ?
Oozie fonctionne comme un service au sein du cluster, et les clients soumettent des définitions de flux de travail pour un traitement immédiat ou ultérieur.
Un flux de travail Oozie est composé de nœuds d'action et de nœuds de contrôle de flux.
Un nœud d'action représente une tâche de flux de travail, par exemple, le déplacement de fichiers dans HDFS, en exécutant une tâche MapReduce, Pig ou Hive, en important des données à l'aide de Squoop, ou en exécutant un script shell ou un programme écrit en Java.
Un nœud de contrôle de flux de contrôle gère l'exécution du flux de travail entre les actions en autorisant des constructions telles que la logique conditionnelle, dans laquelle différentes branches peuvent être suivies en fonction du résultat d'un nœud d'action précédent.
Les nœuds de départ, de fin et d'erreur appartiennent à cette catégorie.
- Noeud de démarrage désigne le début du travail de workflow.
- Nœud final signale la fin du travail.
- Nœud d'erreur indique la survenue d'une erreur et le message d'erreur correspondant à imprimer.
À la fin de l'exécution d'un flux de travail, Oozie utilise une fonction de rappel HTTP pour informer le client de l'état du flux. L'entrée ou la sortie d'un nœud d'action peut également déclencher ce rappel.
Nœuds de contrôle Oozie et types d'actions
Au-delà du début, de la fin et des erreurs, le XML du flux de travail prend en charge un petit vocabulaire de nœuds de contrôle qui structurent le graphique.
- décision: Évalue une expression et oriente le flux de travail vers l'une des branches possibles, l'équivalent d'une instruction switch.
- fourchette: Divise le chemin d'exécution pour que deux actions ou plus s'exécutent en parallèle.
- rejoindre: Attend que chaque branche d'une même fourchette soit terminée avant de continuer.
- tuer: Interrompt immédiatement le flux de travail et enregistre le message d'erreur.
Les nœuds d'action couvrent le travail lui-même, et chacun possède son propre élément XML :
- map-reduce, pig, hive et sqoop Ces actions lancent la tâche Hadoop correspondante.
- Java exécute une classe principale sur le cluster ; coquille et ssh exécuter des scripts.
- fs effectue les tâches de maintenance HDFSping comme déplacer, supprimer, créer un répertoire et modifier les permissions.
- en nous envoyant un mail notifie les destinataires, et sous-flux de travail appelle une autre application de flux de travail.
Exemple de diagramme de flux de travail
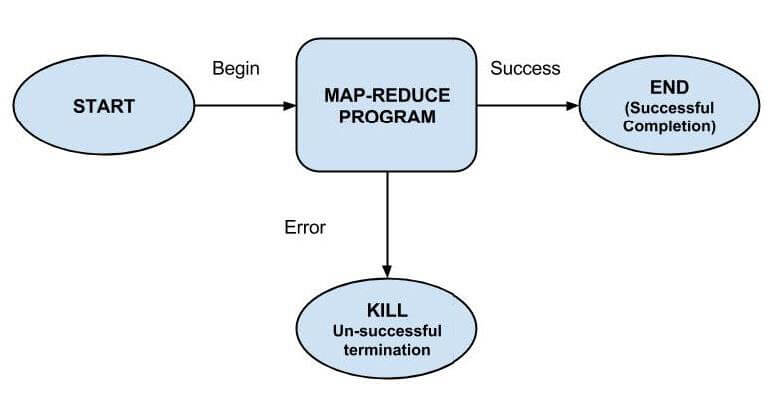
Le diagramme ci-dessous tracil s'agit d'un petit flux de travail partant de son nœud de départ, via une action MapReduce, jusqu'au nœud final ou au chemin d'erreur en cas d'échec de l'action.
Types d'emplois Oozie
Oozie décrit le travail à trois niveaux. Chaque couche englobe celle qui est inférieure, de sorte qu'un ensemble contrôle finalement de nombreux flux de travail individuels.
| Type d'emploi | Ce que cela définit | Déclenché par |
|---|---|---|
| Workflow | Un graphe acyclique orienté de nœuds d'action et de contrôle, écrit dans workflow.xml | Soumission manuelle ou par un coordinateur |
| Coordinatrice | Un planning récurrent pour un flux de travail, avec une heure de début, une heure de fin et une fréquence. | Disponibilité de l'heure et des données d'entrée |
| Lot de serviettes | Un ensemble d'applications de coordination gérées conjointement comme un seul pipeline de données | Une heure de coup d'envoi s'applique à tous ses coordinateurs |
Cette distinction est importante en pratique : un flux de travail répond à la question « qu’est-ce qui s’exécute », un coordinateur répond à la question « quand cela s’exécute », et un ensemble répond à la question « qu’est-ce qui démarre et s’arrête ensemble ».
Packaging et déploiement d'une application de workflow Oozie
Une application de workflow se compose de la définition du workflow et de toutes les ressources associées telles que les fichiers JAR MapReduce, les scripts Pig, etc. Les applications doivent suivre une structure de répertoire simple et sont déployées sur HDFS afin qu'Oozie puisse y accéder.
Un exemple de structure de répertoire est présenté ci-dessous :
<name of workflow>/
├── lib/
│   └── hadoop-examples.jar
└── workflow.xml
Il est nécessaire de placer le fichier workflow.xml (fichier de définition du workflow) à la racine (le répertoire parent portant le nom du workflow). Le répertoire lib contient les fichiers JAR qui renferment les classes MapReduce. Une application de workflow conforme à cette structure peut être générée avec n'importe quel outil de construction, tel qu'Ant ou Maven.
Une telle compilation doit être copiée sur HDFS à l'aide d'une commande, par exemple :
% hadoop fs -put hadoop-examples/target/<name of workflow dir> name of workflow
Étapes pour exécuter une tâche de workflow Oozie
Dans cette section, nous verrons comment exécuter un travail de workflow. Pour exécuter cela, nous utiliserons l'outil de ligne de commande Oozie (un programme client qui communique avec le serveur Oozie).
1. Exporter l'OOZIE_URL variable d'environnement, qui indique à la commande oozie quel serveur Oozie utiliser (ici, nous utilisons un serveur exécuté localement) :
% export OOZIE_URL="http://localhost:11000/oozie"
2. Exécutez la tâche de workflow en utilisant :
% oozie job -config ch05/src/main/resources/max-temp-workflow.properties -run
L'option -config fait référence à un local Java Properties contenant les définitions des paramètres du fichier XML de workflow, ainsi que oozie.wf.application.path, qui indique à Oozie l'emplacement de l'application de workflow dans HDFS.
Exemple de contenu du fichier de propriétés :
nameNode=hdfs://localhost:8020
jobTracker=localhost:8021
oozie.wf.application.path=${nameNode}/user/${user.name}/<name of workflow>
3. Consultez l'état de la tâche de workflow.
L'état d'une tâche de workflow peut être consulté à l'aide de la sous-commande 'job' avec l'option '-info', en spécifiant l'identifiant de la tâche après '-info'.
e.g., % oozie job -info <job id>
Le résultat affiche un statut qui peut être : EN COURS D’EXÉCUTION, TUÉ ou RÉUSSI.
4. Les résultats de l'exécution réussie du flux de travail peuvent être visualisés à l'aide d'une commande Hadoop comme :
% hadoop fs -cat <location of result>
Pourquoi utiliser Oozie ?
L'objectif principal de l'utilisation d'Oozie est de gérer différents types de tâches traitées dans un système Hadoop.
Les dépendances entre les tâches sont définies par l'utilisateur sous forme de graphes acycliques orientés. Oozie exploite ces informations et se charge de leur exécution dans l'ordre spécifié dans le workflow. Ainsi, l'utilisateur gagne du temps sur la gestion complète d'un workflow. De plus, Oozie permet de définir la fréquence d'exécution de chaque tâche.
Caractéristiques d'Oozie
- Oozie dispose d'une API client et d'une interface en ligne de commande permettant de lancer, contrôler et surveiller des tâches depuis un Java .
- Grâce à ses API de service Web, il est possible de contrôler des tâches depuis n'importe où.
- Oozie dispose d'une fonctionnalité permettant d'exécuter des tâches programmées pour s'exécuter périodiquement.
- Oozie propose l'envoi de notifications par e-mail une fois les tâches terminées.
Oozie contre Apache Airflow
Oozie étant obsolète, la plupart des équipes qui évaluent aujourd'hui un ordonnanceur comparent leur solution actuelle à Apache Airflow. Ces deux outils résolvent le même problème, mais de manières opposées.
| Aspect | Apache Oozie | Flux d'air Apache |
|---|---|---|
| Langage de définition | Flux de travail écrits en XML | Les DAG écrits comme Python code |
| Domaine | Construit autour des actions Hadoop telles que MapReduce, Pig, Hive et Sqoop | Usage général, avec des opérateurs pour les services cloud, les bases de données et les conteneurs |
| Planification | Les tâches de coordination sont tributaires du temps et de la disponibilité des données. | Des intervalles de planification et des capteurs qui attendent des conditions externes |
| L'état du projet | Retiré au grenier Apache en 2025 ; version finale 5.2.1 | Projet de haut niveau Apache activement développé |
Oozie reste l'option la plus simple sur un cluster qui l'exécute déjà, car les actions correspondent directement aux composants Hadoop. Airflow est le choix pratique pour tout nouveau projet, en particulier lorsqu'un pipeline s'étend au-delà de Hadoop.
