
Aprendizaje automático supervisado: Algorithms, tipos y ejemplos
 evelyn clarke
⚡ Resumen inteligente
El aprendizaje automático supervisado entrena un algoritmo con ejemplos etiquetados para que pueda predecir resultados para datos que nunca antes ha visto, utilizando regresión para objetivos numéricos y clasificación para objetivos categóricos como spam o fraude.
¿Qué es el aprendizaje automático supervisado?
El aprendizaje automático supervisado es un algoritmo que aprende de datos de entrenamiento etiquetados para predecir resultados con datos imprevistos. En el aprendizaje supervisado, se entrena la máquina con datos bien etiquetados, lo que significa que algunos datos ya están marcados con las respuestas correctas. Se puede comparar con aprender bajo la guía de un supervisor o un profesor.
La creación, el escalado y el despliegue exitosos de modelos de aprendizaje automático supervisado precisos requieren tiempo y la experiencia técnica de un equipo de científicos de datos altamente cualificados. Además, los científicos de datos deben reconstruir los modelos periódicamente para que la información que generan siga siendo válida a medida que cambian los datos subyacentes.
Cómo funciona el aprendizaje supervisado
El aprendizaje automático supervisado utiliza conjuntos de datos de entrenamiento para lograr los resultados deseados. Estos conjuntos de datos contienen entradas y salidas correctas que ayudan al modelo a aprender más rápido. Por ejemplo, desea entrenar una máquina para que le ayude a predecir cuánto tiempo le llevará conducir a casa desde su lugar de trabajo.
Aquí, comienza creando un conjunto de datos etiquetados. Estos datos incluyen:
- Las condiciones climáticas
- Hora del día
- Festividades Estacionales
- Ruta elegida
Todos estos detalles son los datos de entrada en este ejemplo de aprendizaje supervisado. El resultado es el tiempo que tardó en regresar a casa en coche ese día, como se muestra en la imagen a continuación.
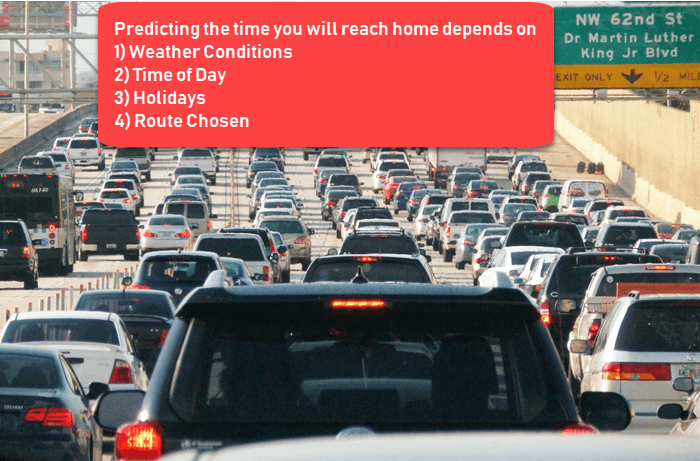
Instintivamente sabes que si llueve, tardarás más en llegar a casa. Pero la máquina necesita datos y estadísticas.
Lo primero que debes crear es un conjunto de entrenamiento. Este contendrá el tiempo total de viaje y factores relacionados como el clima, la hora, etc. Basándose en este conjunto de entrenamiento, tu sistema podría detectar una relación directa entre la cantidad de lluvia y el tiempo que tardarás en llegar a casa.
Así pues, se deduce que cuanto más llueva, más tiempo tardarás en llegar a casa en coche. También se observa una relación entre la hora de salida del trabajo y el tiempo que llevas en la carretera. Cuanto más cerca estés de las 6 de la tarde, más tardarás en llegar a casa.
Es posible que tu máquina encuentre algunas de las relaciones con tus datos etiquetados. Esa fase de aprendizaje se muestra a continuación.
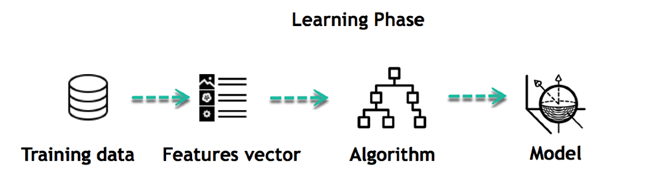
Este es el inicio de tu modelo de datos. Comienza a registrar cómo la lluvia afecta la forma en que la gente conduce y que más personas viajan durante una hora determinada del día.
Tipos de aprendizaje automático supervisado Algorithms
A continuación se muestran los tipos de algoritmos de aprendizaje automático supervisado:
Regresión
La técnica de regresión predice un único valor de salida continuo utilizando datos de entrenamiento.
Ejemplo: puede utilizar la regresión para predecir el precio de la vivienda a partir de datos de entrenamiento. Las variables de entrada serán localidad, tamaño de una casa, etc.
Puntos fuertes: Los resultados son fáciles de interpretar y el algoritmo se puede regularizar para evitar el sobreajuste.
Debilidades: Un modelo lineal no es flexible, por lo que no puede capturar relaciones complejas sin añadirle características.
Aquí hay algunos tipos de regresión. Algorithms:
- Regresión lineal
- Regresión polinomial
- regresión Ridge y Lasso
- Regresión logística (para clasificación)
- Regresión mediante árboles de decisión y bosques aleatorios
- Regresión de vectores de soporte
Regresión logística:
La regresión logística se utiliza para estimar valores discretos a partir de un conjunto de variables independientes. Permite predecir la probabilidad de ocurrencia de un evento ajustando los datos a una función logit. Por ello, también se conoce como regresión logística. Dado que predice una probabilidad, su valor de salida se encuentra entre 0 y 1, y su rendimiento puede ser inferior cuando existen múltiples límites de decisión o no lineales.
Clasificación
La clasificación consiste en agrupar la salida dentro de una clase. Si el algoritmo intenta etiquetar la entrada en dos clases distintas, se denomina clasificación binaria. Seleccionar entre más de dos clases se conoce como clasificación multiclase.
Ejemplo: Determinar si alguien incurrirá o no en mora en el pago del préstamo.
Puntos fuertes: Los árboles de clasificación funcionan muy bien en la práctica.
Debilidades: Al no estar restringidos, los árboles individuales son propensos al sobreajuste.
Aquí hay algunos tipos de clasificación. Algorithms:
- Clasificadores ingenuos de Bayes
- Árboles de decisión
- Máquinas de vectores soporte
- K-Vecinos más cercanos
- Bosque aleatorio y potenciación del gradiente
Clasificadores ingenuos de Bayes
El Bayes ingenuos Este modelo es fácil de construir y muy útil para grandes conjuntos de datos. Se compone de grafos dirigidos acíclicos con un nodo padre y varios nodos hijos. Presupone independencia entre los nodos hijos, separados de su nodo padre.
Árboles de decisión
Los árboles de decisión clasifican una instancia ordenándola según el valor de su característica. En este método, cada nodo representa la característica de la instancia que se va a clasificar, y cada rama representa un valor que el nodo puede asumir. Es una técnica de clasificación muy utilizada.
La misma estructura funciona para la regresión: un árbol de regresión ayuda a estimar valores reales (coste de compra de un coche, número de llamadas, ventas mensuales totales, etc.).
Máquinas de vectores soporte
La máquina de vectores de soporte (SVM, por sus siglas en inglés) es un tipo de algoritmo de aprendizaje introducido en la década de 1990. Este método se basa en los resultados de la teoría del aprendizaje estadístico desarrollada por Vladimir Vapnik y sus colegas.
Las SVM también están estrechamente relacionadas con las funciones kernel, que son un concepto central para la mayoría de las tareas de aprendizaje. El marco kernel y las SVM se utilizan en una variedad de campos. Esto incluye la recuperación de información multimedia, la bioinformática y el reconocimiento de patrones. Cada estimador anterior está documentado con sus parámetros de ajuste en el scikit-aprender referencia.
Técnicas de aprendizaje automático supervisado frente a no supervisado
Colocando el método al lado aprendizaje sin supervisión deja claros sus límites.
| Residencia en | Técnica de aprendizaje automático supervisado. | Técnica de aprendizaje automático no supervisado |
|---|---|---|
| Los datos de entrada | Algorithms se entrenan utilizando datos etiquetados. | Algorithms se utilizan contra datos que no están etiquetados |
| Complejidad computacional | El aprendizaje supervisado es un método más sencillo. | El aprendizaje no supervisado es computacionalmente complejo |
| Exactitud | Método altamente preciso y confiable. | Less método preciso y confiable. |
| algoritmos típicos | Regresión logística, árboles de decisión, SVM, Naive Bayes | K-medias, agrupamiento jerárquico, PCA |
| Cómo se evalúan los resultados | Comparado con las respuestas conocidas (precisión, RMSE) | Evaluado mediante medidas internas y revisión humana. |
Desafíos en el aprendizaje automático supervisado
A continuación, se detallan los desafíos que enfrenta el aprendizaje automático supervisado:
- Las características de entrada irrelevantes en los datos de entrenamiento pueden producir resultados inexactos.
- La preparación y el preprocesamiento de datos siempre es un desafío.
- La precisión se ve afectada cuando se han introducido valores imposibles, improbables e incompletos como datos de entrenamiento.
- Si el experto en cuestión no está disponible, la otra opción es el método de "fuerza bruta". Esto significa que hay que adivinar qué características (variables de entrada) usar para entrenar la máquina, y esa suposición podría ser inexacta.
Ventajas del aprendizaje supervisado
Frente a esos desafíos, estas son las ventajas del aprendizaje automático supervisado:
- Aprendizaje supervisado en Aprendizaje automático te permite recopilar datos o generar una salida de datos a partir de experiencias previas.
- Le ayuda a optimizar los criterios de rendimiento utilizando la experiencia.
- El aprendizaje automático supervisado le ayuda a resolver varios tipos de problemas informáticos del mundo real.
Desventajas del aprendizaje supervisado
A continuación se detallan las desventajas del aprendizaje automático supervisado:
- El límite de decisión podría estar sobreentrenado si su conjunto de entrenamiento no tiene los ejemplos que desea tener en una clase.
- Debe seleccionar muchos buenos ejemplos de cada clase mientras entrena al clasificador.
- Clasificar grandes cantidades de datos puede ser un verdadero desafío.
- La formación para el aprendizaje supervisado necesita mucho tiempo de cálculo.
Mejores prácticas para el aprendizaje supervisado
La siguiente secuencia mantiene un proyecto en marcha. track:
- Antes de hacer cualquier otra cosa, decide qué tipo de datos se utilizarán como conjunto de entrenamiento.
- Decide la estructura de la función aprendida y el algoritmo de aprendizaje.
- Recopile los resultados correspondientes, ya sea de expertos humanos o de mediciones.
- Reserva un conjunto de prueba que el modelo nunca vea e informa la puntuación obtenida.
