
Tutorial de dplyr en R: Combinar y unir datos con ejemplos
 evelyn clarke
⚡ Resumen inteligente
dplyr combina y une marcos de datos en R con cuatro verbos: left_join(), right_join(), inner_join() y full_join(). Su paquete complementario tidyr luego remodela el resultado de la unión usando gather(), spread(), separate() y unite().
Introducción al análisis de datos
Antes de unirse o reorganizarseping El verbo tiene sentido, ayuda a ver dónde encaja la manipulación de datos. El análisis de datos se puede dividir en tres partes:
- Extracdisrupción : Primero, necesitamos recopilar datos de muchas fuentes y combinarlas.
- Transformación: Este paso implica la manipulación de datos. Una vez que hayamos consolidado todas las fuentes de datos, podemos comenzar a limpiar los datos.
- Visualizar las: El último paso es visualizar nuestros datos para comprobar la irregularidad.
El siguiente diagrama muestra cómo se conectan las tres etapas.
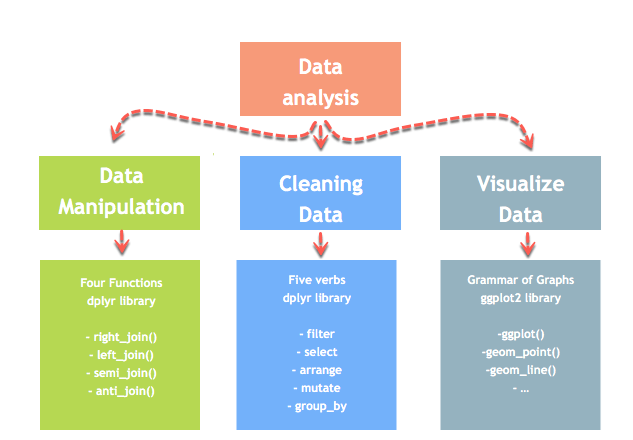
Uno de los mayores desafíos para los científicos de datos es la manipulación de datos. Los datos nunca están disponibles en el formato deseado. Los científicos de datos deben dedicar al menos la mitad de su tiempo a limpiar y manipular los datos. Esta es una de las tareas más críticas de su trabajo. Si el proceso de manipulación de datos no es completo, preciso y riguroso, el modelo no funcionará correctamente.
R dplyr
R cuenta con un paquete llamado dplyr que se encarga de la transformación de datos. Está construido en torno a un pequeño conjunto de verbos básicos —filter(), select(), arrange(), mutate() y summarise()— además de una familia de funciones de unión. Una vez que los datos están preparados, ggplot2 puede visualizarlos.
Aprenderemos cómo usar el paquete dplyr para manipular un Marco de datos. Si R aún no está instalado, siga las instrucciones Pasos de configuración de R y RStudio, luego ejecute install.packages(“dplyr”).
Combinar datos con dplyr
dplyr proporciona una forma agradable y cómoda de combinar conjuntos de datos. Es posible que tengamos muchas fuentes de datos de entrada y, en algún momento, necesitemos combinarlas. Una combinación con dplyr agrega variables a la derecha del conjunto de datos original.
dplyr se une
A continuación se muestran cuatro tipos importantes de uniones que se utilizan en dplyr para combinar dos conjuntos de datos. Los cuatro aceptan los mismos argumentos (las dos tablas y la clave) y se diferencian únicamente en qué filas no coincidentes se conservan:
| Función | Objetivo | Argumentos | Llaves múltiples |
|---|---|---|---|
| unión_izquierda() | Fusionar dos conjuntos de datos. Mantener todas las observaciones de la tabla de origen. | x, y, por = “ID” | x, y, por = c(“ID”, “ID2”) |
| unión_derecha() | Fusionar dos conjuntos de datos. Mantener todas las observaciones de la tabla de destino. | x, y, por = “ID” | x, y, por = c(“ID”, “ID2”) |
| unir internamente() | Combinar dos conjuntos de datos. Excluir todas las filas que no coincidan. | x, y, por = “ID” | x, y, por = c(“ID”, “ID2”) |
| unión_completa() | Combinar dos conjuntos de datos. Conservar todas las observaciones. | x, y, por = “ID” | x, y, por = c(“ID”, “ID2”) |
Estos cuatro verbos se corresponden con las uniones IZQUIERDA, DERECHA, INTERNA y EXTERNA COMPLETA de SQL. Base R alcanza los mismos resultados a través de los argumentos all, all.x y all.y de unir().
Estudiaremos todos los tipos de uniones mediante un ejemplo sencillo.
En primer lugar, construimos dos conjuntos de datos. La Tabla 1 contiene dos variables, ID e y, mientras que la Tabla 2 reúne ID y z. En cada situación, necesitamos tener una Par de claves variable. En nuestro caso, la identificación es nuestra clave variable. La función buscará valores idénticos en ambas tablas y vinculará los valores devueltos a la derecha de la tabla 1. La siguiente figura muestra las dos tablas una al lado de la otra.

library(dplyr)
df_primary <- tribble(
  ~ID, ~y,
   "A", 5,
   "B", 5,
   "C", 8,
   "D", 0,
  "F", 9)
df_secondary <- tribble(
  ~ID, ~z,
   "A", 30,
   "B", 21,
   "C", 22,
   "D", 25,
   "E", 29)
dplyr left_join()
La forma más común de combinar dos conjuntos de datos es mediante la función left_join(). La imagen a continuación muestra que el par clave-valor coincide con las filas A, B, C y D, mientras que E y F quedan sin combinar. Con left_join(), conservamos todas las filas de la tabla original e ignoramos las que no tienen un par clave-valor en la tabla de destino. En nuestro ejemplo, el valor E no existe en la tabla 1, por lo que se elimina esa fila. El valor F proviene de la tabla de origen, por lo que se conserva después de left_join() y devuelve NA en la columna z.
Ejemplo de dplyr left_join()
El siguiente diagrama reproduce lo que sucede durante una operación left_join().

left_join(df_primary, df_secondary, by ='ID')
Salida:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
Tenga en cuenta que cuando ambas tablas tienen una columna con el mismo nombre, dplyr las desambigua con los sufijos .x y .y que se muestran arriba.
dplyr right_join()
La función right_join() funciona exactamente como left_join(). La única diferencia es que se eliminó la fila. El valor E, disponible en el marco de datos de destino, existe en la nueva tabla y toma el valor NA para la columna y.
Ejemplo de dplyr right_join()
El diagrama que aparece a continuación muestra la imagen especular.

right_join(df_primary, df_secondary, by = 'ID')
Salida:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     E    NA    29
dplyr inner_join()
Cuando las observaciones no coincidentes no son de ninguna utilidad, podemos devolver único las filas que existen en ambas conjuntos de datos. Esta es la opción correcta cuando necesitamos un conjunto de datos completo y no queremos imputar los valores faltantes con la media o la mediana.
La función inner_join() resulta útil en este caso. Excluye las filas que no coinciden en ambos lados.
Ejemplo de dplyr internal_join()
El diagrama que aparece a continuación resalta los cuatro identificadores que sobreviven a la unión.

inner_join(df_primary, df_secondary, by ='ID')
Salida:
##
# A tibble: 4 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
dplyr full_join()
Finalmente, la función full_join() conserva todas las observaciones y reemplaza los valores faltantes con NA.
Ejemplo de dplyr full_join()
El diagrama que aparece a continuación muestra todos los ID de ambas tablas que se conservan tras la unión.

full_join(df_primary, df_secondary, by = 'ID')
Salida:
## # A tibble: 6 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
## 6     E    NA    29
Múltiples pares de claves
Por último, pero no menos importante, podemos tener varias claves en nuestro conjunto de datos. Consideremos el siguiente conjunto de datos, donde tenemos los años y una lista de productos comprados por el cliente. La captura de pantalla a continuación muestra las dos tablas y las columnas ID y año que, en conjunto, identifican una fila.
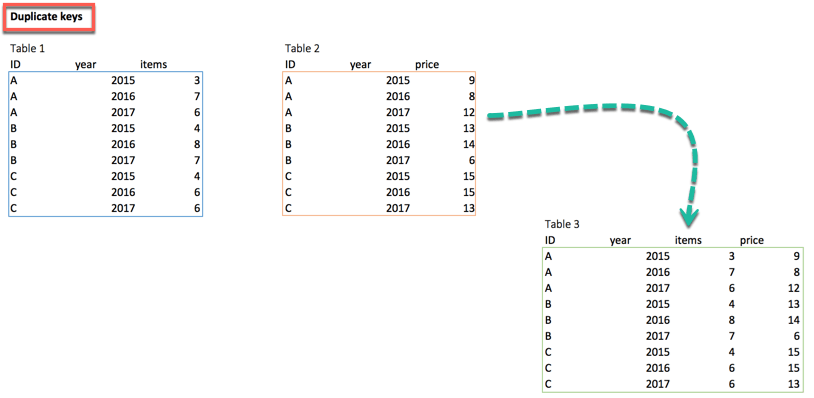
Si unimos ambas tablas solo por ID, cada año se compara con todos los demás y el número de filas se dispara. Para solucionar esto, podemos pasar dos variables clave-valor: ID y año, que aparecen en ambos conjuntos de datos. Podemos usar el siguiente código para fusionar la tabla 1 y la tabla 2:
df_primary <- tribble(
  ~ID, ~year, ~items,
  "A", 2015,3,
  "A", 2016,7,
  "A", 2017,6,
  "B", 2015,4,
  "B", 2016,8,
  "B", 2017,7,
  "C", 2015,4,
  "C", 2016,6,
  "C", 2017,6)
df_secondary <- tribble(
  ~ID, ~year, ~prices,
  "A", 2015,9,
  "A", 2016,8,
  "A", 2017,12,
  "B", 2015,13,
  "B", 2016,14,
  "B", 2017,6,
  "C", 2015,15,
  "C", 2016,15,
  "C", 2017,13)
left_join(df_primary, df_secondary, by = c('ID', 'year'))
Salida:
## # A tibble: 9 x 4
##      ID  year items prices
##   <chr> <dbl> <dbl>  <dbl>
## 1     A  2015     3      9
## 2     A  2016     7      8
## 3     A  2017     6     12
## 4     B  2015     4     13
## 5     B  2016     8     14
## 6     B  2017     7      6
## 7     C  2015     4     15
## 8     C  2016     6     15
## 9     C  2017     6     13
Desde dplyr 1.1.0 (enero de 2023), la misma clave se puede escribir como join_by(ID, año), y dplyr ahora advierte sobre coincidencias inesperadas de muchos a muchos, ya que dplyr 1.1.0 se une al anuncio explica.
Funciones de limpieza de datos en R
La fusión solo resuelve la mitad del problema, ya que la tabla combinada aún debe ser remodelada. A continuación se presentan las cuatro funciones importantes para ordenar (limpiar) los datos:
| Función | Objetivo | Argumentos |
|---|---|---|
| recolectar() | Transforma los datos de ancho a largo | (datos, clave, valor, na.rm = FALSO) |
| desparramar() | Transforme los datos de largo a ancho | (datos, clave, valor) |
| separado() | Dividir una variable en dos | (datos, columna, en, separador = “”, eliminar = VERDADERO) |
| unir() | Unir dos variables en una sola | (datos, columna, conc, sep = “”, eliminar = VERDADERO) |
Nota de versión: gather() y spread() fueron reemplazados por pivot_longer() y pivot_wider() en tidyr 1.0.0, y separate() por la familia separate_wider_delim() en tidyr 1.3.0. Las funciones reemplazadas aún se ejecutan, por lo que todos los ejemplos a continuación funcionan, pero el código nuevo debería preferir las familias más nuevas que se muestran en el viñeta pivotante más ordenada. unite() sigue vigente.
Utilizamos el paquete tidyr, parte de la colección tidyverse para manipular, limpiar y visualizar datos. Si R se instaló con Anaconda, el paquete ya está disponible desde https://anaconda.org/r/r-tidyr.
Si aún no está instalado, ingrese el siguiente comando para instalar tidyr:
install.packages("tidyr")
recolectar()
El objetivo de la función gather() es transformar los datos de formato ancho a formato largo.
Sintaxis
gather(data, key, value, na.rm = FALSE)
Arguments:
-data: The data frame used to reshape the dataset
-key: Name of the new column created
-value: Select the columns used to fill the key column
-na.rm: Remove missing values. FALSE by default
Ejemplo
A continuación, podemos visualizar el concepto de reshaping De ancho a largo. Queremos crear una sola columna llamada "crecimiento", que se rellenará con las filas de las variables trimestrales. La siguiente figura muestra la tabla ancha a la izquierda y la tabla larga redimensionada a la derecha.

library(tidyr)
# Create a messy dataset
messy <- data.frame(
  country = c("A", "B", "C"),
  q1_2017 = c(0.03, 0.05, 0.01),
  q2_2017 = c(0.05, 0.07, 0.02),
  q3_2017 = c(0.04, 0.05, 0.01),
  q4_2017 = c(0.03, 0.02, 0.04))
messy
Salida:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
# Reshape the data
tidier <-messy %>%
gather(quarter, growth, q1_2017:q4_2017)
tidier
Salida:
##    country quarter growth
## 1        A q1_2017   0.03
## 2        B q1_2017   0.05
## 3        C q1_2017   0.01
## 4        A q2_2017   0.05
## 5        B q2_2017   0.07
## 6        C q2_2017   0.02
## 7        A q3_2017   0.04
## 8        B q3_2017   0.05
## 9        C q3_2017   0.01
## 10       A q4_2017   0.03
## 11       B q4_2017   0.02
## 12       C q4_2017   0.04
En la función gather(), creamos dos nuevas variables, quarter y growth, porque nuestro conjunto de datos original tiene una variable de grupo, country, y los pares clave-valor. En tidyr 1.0.0 y posteriores, la misma remodelación se escribe como pivot_longer(messy, cols = q1_2017:q4_2017, names_to = “quarter”, values_to = “growth”).
desparramar()
La función spread() hace lo contrario que gather().
Sintaxis
spread(data, key, value)
arguments:
data: The data frame used to reshape the dataset
key: Column to reshape long to wide
value: Rows used to fill the new column
Ejemplo
Podemos volver a convertir el conjunto de datos ordenado en uno desordenado con spread().
# Reshape the data
messy_1 <- tidier %>%
  spread(quarter, growth)
messy_1
Salida:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
El equivalente moderno es pivot_wider(tidier, names_from = quarter, values_from = growth).
separado()
La función `separate()` divide una columna en dos según un separador. Esta función es útil cuando la variable es una fecha. Nuestro análisis puede requerir que nos centremos en el mes y el año, y queremos separar la columna en dos nuevas variables.
Sintaxis
separate(data, col, into, sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: The column to split
-into: The name of the new variables
-sep: Indicates the symbol used that separates the variable, i.e.:  "-", "_", "&"
-remove: Remove the old column. By default sets to TRUE.
Ejemplo
Podemos dividir el trimestre del año en el conjunto de datos más ordenado aplicando la función separa().
separate_tidier <-tidier %>%
separate(quarter, c("Qrt", "year"), sep ="_")
head(separate_tidier)
Salida:
##   country Qrt year growth
## 1       A  q1 2017   0.03
## 2       B  q1 2017   0.05
## 3       C  q1 2017   0.01
## 4       A  q2 2017   0.05
## 5       B  q2 2017   0.07
## 6       C  q2 2017   0.02
unir()
La función unite() concatena dos columnas en una sola.
Sintaxis
unite(data, col, conc ,sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: Name of the new column
-conc: Name of the columns to concatenate
-sep: Indicates the symbol used that unites the variable, i.e:  "-", "_", "&"
-remove: Remove the old columns. By default, sets to TRUE
Ejemplo
En el ejemplo anterior, separamos el trimestre del año. ¿Qué sucede si queremos combinarlos? Usamos el siguiente código:
unit_tidier <- separate_tidier %>%
  unite(Quarter, Qrt, year, sep ="_")
head(unit_tidier)
Salida:
##   country Quarter growth
## 1       A q1_2017   0.03
## 2       B q1_2017   0.05
## 3       C q1_2017   0.01
## 4       A q2_2017   0.05
## 5       B q2_2017   0.07
## 6       C q2_2017   0.02
El marco de datos reformateado ya está listo para los pasos de modelado que se describen en el resto del documento. Serie de tutoriales de R.
