
Tutorial de Apache Oozie: Diagrama de flujo de trabajo, Planificador
 Prafulla Ranadive
⚡ Resumen inteligente
Apache Oozie es el planificador de flujos de trabajo para Hadoop que ejecuta trabajos dependientes como grafos acíclicos dirigidos, combinando un motor de flujo de trabajo para acciones de MapReduce, Pig y Hive con un motor coordinador impulsado por el tiempo y la disponibilidad de datos.
¿Qué es Apache Oozie?
Apache Oozie es un programador de flujos de trabajo para HadoopSe trata de un sistema que gestiona el flujo de trabajo de tareas dependientes. Aquí, los usuarios pueden crear grafos acíclicos dirigidos de flujos de trabajo, que pueden ejecutarse en paralelo y secuencialmente en Hadoop.
Está formado por dos partes:
- Motor de flujo de trabajo: La responsabilidad de un motor de flujo de trabajo es almacenar y ejecutar flujos de trabajo compuestos por trabajos de Hadoop, por ejemplo: MapReduce, Cerdo, Colmena.
- Motor coordinador: Ejecuta tareas de flujo de trabajo en función de programaciones predefinidas y la disponibilidad de datos.
Oozie es escalable y puede gestionar la ejecución puntual de miles de flujos de trabajo (cada uno compuesto por docenas de tareas) en un clúster Hadoop. El siguiente diagrama muestra la ubicación del planificador en relación con el clúster y las tareas que gestiona.

Oozie también es muy flexible. Permite iniciar, detener, suspender y volver a ejecutar trabajos fácilmente. Además, facilita enormemente la repetición de flujos de trabajo fallidos. Es fácil comprender lo difícil que puede resultar recuperar trabajos perdidos o fallidos debido a interrupciones del servicio o fallos. Incluso es posible omitir un nodo específico que haya fallado.
Estado del proyecto: Apache Oozie fue retirado por Apache Software. Foundation en febrero de 2025 y el traslado a la Ático Apache Finalizado en abril de 2025. La versión final sigue siendo la 5.2.1 de febrero de 2021, y el repositorio de código fuente ahora es de solo lectura. Los clústeres existentes aún lo ejecutan, por lo que vale la pena conocer los detalles a continuación, pero las nuevas canalizaciones normalmente se crean con Apache Airflow.
¿Cómo funciona Oozie?
Oozie se ejecuta como un servicio en el clúster, y los clientes envían definiciones de flujo de trabajo para su procesamiento inmediato o posterior.
Un flujo de trabajo de Oozie consta de nodos de acción y nodos de control de flujo.
Un nodo de acción representa una tarea de flujo de trabajo, por ejemplo, mover archivos a HDFS, ejecutando un trabajo MapReduce, Pig o Hive, importando datos usando sqoopo ejecutar un script de shell o un programa escrito en Java.
Un nodo de control de flujo controla la ejecución del flujo de trabajo entre acciones, permitiendo construcciones como la lógica condicional, en la que se pueden seguir diferentes ramas dependiendo del resultado de un nodo de acción anterior.
Los nodos de inicio, fin y error pertenecen a esta categoría.
- Nodo de inicio designa el inicio del trabajo de flujo de trabajo.
- Nodo final indica el final del trabajo.
- Nodo de error Indica la ocurrencia de un error y el mensaje de error correspondiente que se debe imprimir.
Al finalizar la ejecución de un flujo de trabajo, Oozie utiliza una devolución de llamada HTTP para informar al cliente sobre el estado del flujo de trabajo. La entrada o salida de un nodo de acción también puede activar la devolución de llamada.
Nodos de control y tipos de acciones de Oozie
Más allá de inicio, fin y error, el XML del flujo de trabajo admite un pequeño vocabulario de nodos de control que dan forma al gráfico.
- decisión: Evalúa una expresión y dirige el flujo de trabajo hacia una de varias ramas, el equivalente a una instrucción switch.
- tenedor: Divide la ruta para que dos o más acciones se ejecuten en paralelo.
- unirse: Espera a que todas las ramas de una bifurcación coincidente terminen antes de continuar.
- matar: Finaliza el flujo de trabajo inmediatamente y registra el mensaje de error.
Los nodos de acción abarcan el trabajo en sí, y cada uno tiene su propio elemento XML:
- MapReduce, Pig, Hive y Sqoop Las acciones inician el trabajo Hadoop correspondiente.
- Java ejecuta una clase principal en el clúster; shell y ssh ejecutar scripts.
- fs realiza tareas de mantenimiento de HDFSping tales como mover, eliminar, crear directorio y cambiar permisos.
- o enviar un email. notifica a los destinatarios y flujo de trabajo secundario llama a otra aplicación de flujo de trabajo.
Ejemplo de diagrama de flujo de trabajo
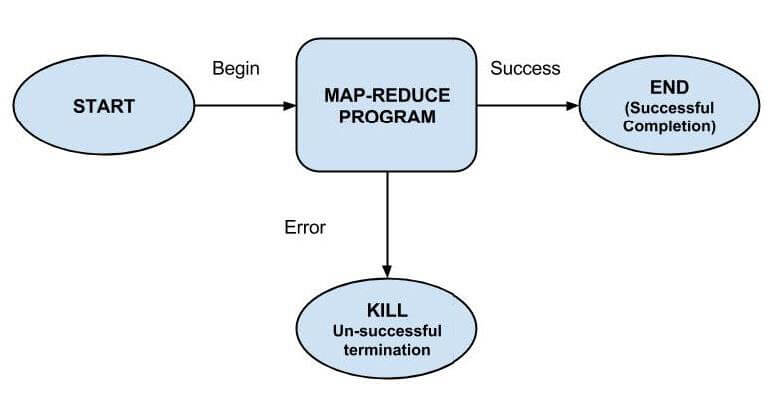
El diagrama a continuación traces un pequeño flujo de trabajo desde su nodo de inicio, a través de una acción MapReduce, hasta el nodo final o la ruta de error cuando la acción falla.
Tipos de trabajos de Oozie
Oozie describe el trabajo en tres niveles. Cada capa envuelve a la que está debajo, por lo que un paquete controla, en última instancia, muchos flujos de trabajo individuales.
| Tipo de empleo | Lo que define | Desencadenado por |
|---|---|---|
| Flujo de trabajo | Un grafo acíclico dirigido de nodos de acción y control, escrito en workflow.xml. | Envío manual o un coordinador |
| Director | Un cronograma recurrente para un flujo de trabajo, con una hora de inicio, una hora de finalización y una frecuencia. | Disponibilidad de la hora del reloj y de los datos de entrada |
| Formentera Bundle | Un conjunto de aplicaciones coordinadoras gestionadas conjuntamente como una única canalización de datos. | Un horario de inicio que se aplicó a todos sus coordinadores. |
La distinción es importante en la práctica: un flujo de trabajo responde a la pregunta "¿qué se ejecuta?", un coordinador responde a la pregunta "¿cuándo se ejecuta?" y un paquete responde a la pregunta "¿qué comienza y termina juntos?".
Empaquetado e implementación de una aplicación de flujo de trabajo de Oozie
Una aplicación de flujo de trabajo consta de la definición del flujo de trabajo y todos los recursos asociados, como archivos JAR de MapReduce, scripts de Pig, etc. Las aplicaciones deben seguir una estructura de directorios simple y se implementan en HDFS para que Oozie pueda acceder a ellas.
A continuación se muestra un ejemplo de estructura de directorios:
<name of workflow>/
├── lib/
│   └── hadoop-examples.jar
└── workflow.xml
Es necesario mantener workflow.xml (un archivo de definición de flujo de trabajo) en el directorio raíz (el directorio padre que contiene el nombre del flujo de trabajo). El directorio lib contiene archivos JAR con clases MapReduce. Una aplicación de flujo de trabajo que cumpla con esta estructura se puede compilar con cualquier herramienta de compilación, por ejemplo, Ant o Maven.
Dicha compilación debe copiarse a HDFS mediante un comando, por ejemplo:
% hadoop fs -put hadoop-examples/target/<name of workflow dir> name of workflow
Pasos para ejecutar un trabajo de flujo de trabajo de Oozie
En esta sección, veremos cómo ejecutar un trabajo de flujo de trabajo. Para ejecutar esto, usaremos la herramienta de línea de comandos de Oozie (un programa cliente que se comunica con el servidor de Oozie).
1. Exportar el OOZIE_URL variable de entorno, que le indica al comando oozie qué servidor Oozie usar (en este caso estamos usando uno que se ejecuta localmente):
% export OOZIE_URL="http://localhost:11000/oozie"
2. Ejecute el trabajo de flujo de trabajo utilizando:
% oozie job -config ch05/src/main/resources/max-temp-workflow.properties -run
La opción -config se refiere a un local Java archivo de propiedades que contiene definiciones para los parámetros en el archivo XML del flujo de trabajo, así como oozie.wf.application.path, que le indica a Oozie la ubicación de la aplicación de flujo de trabajo en HDFS.
Contenido de ejemplo del archivo de propiedades:
nameNode=hdfs://localhost:8020
jobTracker=localhost:8021
oozie.wf.application.path=${nameNode}/user/${user.name}/<name of workflow>
3. Obtén el estado del trabajo del flujo de trabajo.
El estado de una tarea de flujo de trabajo se puede consultar mediante el subcomando 'job' con la opción '-info', especificando el ID de la tarea después de '-info'.
e.g., % oozie job -info <job id>
La salida muestra un estado que puede ser uno de los siguientes: EJECUTÁNDOSE, TERMINADO o CORRECTO.
4. Los resultados de una ejecución exitosa del flujo de trabajo se pueden ver utilizando un comando de Hadoop como el siguiente:
% hadoop fs -cat <location of result>
¿Por qué utilizar Oozie?
El objetivo principal de utilizar Oozie es gestionar los diferentes tipos de trabajos que se procesan en un sistema Hadoop.
El usuario especifica las dependencias entre tareas mediante grafos acíclicos dirigidos. Oozie procesa esta información y se encarga de su ejecución en el orden correcto, según lo especificado en el flujo de trabajo. De esta forma, se ahorra tiempo al usuario al gestionar el flujo de trabajo completo. Además, Oozie permite especificar la frecuencia de ejecución de cada tarea.
Características de Oozie
- Oozie tiene una API de cliente y una interfaz de línea de comandos que se pueden usar para iniciar, controlar y monitorear trabajos desde una Java .
- Mediante sus API de servicio web, se pueden controlar los trabajos desde cualquier lugar.
- Oozie dispone de una función para ejecutar tareas programadas para realizarse periódicamente.
- Oozie dispone de una función para enviar notificaciones por correo electrónico una vez finalizados los trabajos.
Oozie contra Apache Airflow
Dado que Oozie ya no se utiliza, la mayoría de los equipos que evalúan un planificador hoy en día comparan sus sistemas actuales con Apache Airflow. Ambas herramientas resuelven el mismo problema desde perspectivas opuestas.
| Aspecto | apache oozie | Flujo de aire Apache |
|---|---|---|
| Lenguaje de definición | Flujos de trabajo escritos en XML | DAGs escritos como Python código |
| <b></b><b></b> | Construido en torno a acciones de Hadoop como MapReduce, Pig, Hive y Sqoop. | De propósito general, con operadores para servicios en la nube, bases de datos y contenedores. |
| Programación | Los puestos de coordinador están condicionados por el tiempo y la disponibilidad de datos. | Intervalos programados más sensores que esperan condiciones externas |
| Estado del proyecto | Retirado al Apache Attic en 2025; versión final 5.2.1 | Proyecto Apache de alto nivel en desarrollo activo |
Oozie sigue siendo la opción más sencilla en un clúster que ya lo ejecuta, ya que las acciones se corresponden directamente con los componentes de Hadoop. Airflow es la opción práctica para cualquier novedad, especialmente cuando una canalización se extiende más allá de Hadoop.
