
Tutorial de Hadoop Pig: ¿Qué es Apache Pig? Architectura, ejemplo
 Prafulla Ranadive
⚡ Resumen inteligente
Apache Pig es una plataforma de alto nivel para analizar grandes conjuntos de datos en Hadoop, que combina el lenguaje de flujo de datos Pig Latin con un entorno de ejecución que compila cada script en MapReduce, Tez o Spark trabajos automáticamente.
Este tutorial comienza con la idea detrás de Apache Pig, luego explica cómo instalarlo y cómo ejecutar un script completo de Pig Latin de principio a fin.
¿Qué es el cerdo apache?
El cerdo es un nivel alto lenguaje de programación Útil para analizar grandes conjuntos de datos. Pig fue el resultado del esfuerzo de desarrollo en Yahoo!
En un marco de trabajo MapReduce, los programas deben traducirse en una serie de etapas Map y Reduce. Sin embargo, este no es un modelo de programación con el que los analistas de datos estén familiarizados. Por lo tanto, para salvar esta brecha, se necesita un enfoque integral.tracLa construcción llamada Pig se construyó encima de Hadoop.
Apache Pig permite centrarse en el análisis de grandes conjuntos de datos y dedicar menos tiempo a escribir programas MapReduce. Al igual que los cerdos, que comen de todo, el lenguaje de programación Apache Pig está diseñado para trabajar con cualquier tipo de datos. ¡De ahí su nombre: Pig! La mascota del proyecto, que aparece a continuación, ilustra esta idea.

El proyecto sigue activo. Apache Pig 0.18.0 fue lanzado el 15 de septiembre de 2025 y agrega soporte para Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 y Python 3, según la Página de versiones de Apache PigEl tutorial que aparece a continuación se escribió originalmente para la versión 0.12.1, mucho más antigua, por lo que algunos pasos incluyen una nota donde se indica que la versión actual se comporta de manera diferente.
Cerdo Architectura
La arquitectura de Pig consta de dos componentes:
- Jerga, que es un idioma
- Un entorno de ejecución, para ejecutar programas de Pig Latin.
Un programa Pig Latin consiste en una serie de operaciones o transformaciones que se aplican a los datos de entrada para producir una salida. Estas operaciones describen un flujo de datos que es traducido a una representación ejecutable por el entorno de ejecución Hadoop Pig. Debajo, los resultados de estas transformaciones son una serie de MapReduce tareas que un programador desconoce. Así, en cierto modo, Pig en Hadoop permite al programador centrarse en los datos en lugar de en la naturaleza de la ejecución.
Pig Latin es un lenguaje relativamente rígido que utiliza palabras clave familiares del procesamiento de datos, por ejemplo, Join, Group y Filter. El diagrama a continuación traces un script desde el shell Grunt a través del analizador, el optimizador y el compilador en su camino hacia el motor de ejecución.

Modos de ejecución
Pig en Hadoop tiene dos modos de ejecución, y el tutorial de instalación que se muestra más adelante utiliza ambos:
- Modo local: En este modo, el lenguaje Hadoop Pig se ejecuta en un único JVM y utiliza el sistema de archivos local. Este modo solo es adecuado para el análisis de conjuntos de datos pequeños mediante Pig en Hadoop.
- Modo MapReduce: En este modo, las consultas escritas en Pig Latin se traducen a trabajos MapReduce y se ejecutan en un clúster Hadoop (el clúster puede ser pseudodistribuido o totalmente distribuido). El modo MapReduce con un clúster totalmente distribuido es útil para ejecutar Pig en grandes conjuntos de datos.
Esos dos son el par clásico. Las versiones actuales en realidad exponen seis tipos de ejecución, o exectypes, cada uno seleccionado con el mismo -x bandera, como se documenta en el Guía de inicio rápido de Pig 0.18.0.
| Tipo de ejecución | Comando | Dónde se desarrolla el trabajo |
|---|---|---|
| Local | cerdo -x local | Una única JVM frente al sistema de archivos local |
| Tez local | cerdo -x tez_local | Una única JVM que utiliza el entorno de ejecución Tez (experimental) |
| Spark local | cerdo -x spark_local | Una única JVM que utiliza el Spark tiempo de ejecución (experimental) |
| MapReduce | cerdo o cerdo -x mapreduce | Un clúster Hadoop con HDFS; esta es la configuración predeterminada. |
| Tez | cerdo -x tez | Un clúster Hadoop que ejecuta el motor Tez. |
| Spark | cerdo -x chispa | A Spark, clúster YARN o Mesos con HDFS |
Tipos de datos y Pig Latin Operatoros
Antes de escribir un script, es útil saber qué información puede almacenar Pig y qué puede hacer con ella. El modelo de datos está completamente anidado, lo que permite a Pig leer archivos de registro y otros datos de entrada poco estructurados que una tabla relacional rechazaría.
Pig Latin ofrece dos familias de tipos:
- Tipos escalares:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerybigdecimalEl script de ejemplo más adelante declara cada columna comochararray. - Tipos complejos: a tupla es un conjunto ordenado de campos y se comporta como una fila; bolsa es una colección desordenada de tuplas y se comporta como una tabla; mapa es un conjunto de pares clave y valor cuya clave debe ser un
chararray.
Los operarios se dividen en un número reducido de puestos, y unos pocos de ellos se encargan de casi todos los oleoductos:
| Operator | ¿Qué hace? |
|---|---|
| CARGAR / ALMACENAR | Lee una relación del sistema de archivos y escribe el resultado. |
| FILTRO | Conservar solo las tuplas que coincidan con una condición. |
| PARA CADA UNO… GENERAR | Trabaje columna por columna, creando nuevos campos. |
| GRUPO / COGRUPO | Agrupe una relación, o dos o más relaciones, por una clave. |
| ÚNETE | Combinar relaciones con una unión interna o externa |
| UNIÓN / DIVISIÓN | Fusionar relaciones o dividir una en varias. |
| ORDENAR POR / DISTINTO / LÍMITE | Ordenar, eliminar duplicados y limitar el número de tuplas. |
| VOLCAR / DESCRIBIR / EXPLICAR / ILUSTRAR | Inspeccione los resultados, los esquemas, los planes de ejecución y las ejecuciones de ejemplo. |
Los cuatro operadores de inspección también tienen atajos de Grunt, lo que ahorra tiempo.ping durante la depuración: \d para DUMP, \de para DESCRIBIR, \e para EXPLICAR y \i para ILLUSTRAR.
Requisitos previos
Pig es una herramienta del lado del cliente. Analiza un script, planifica el trabajo y envía tareas, pero no proporciona almacenamiento ni un clúster propio, por lo que primero debe existir una instalación funcional de Hadoop. La lista de requisitos de Apache es corta.
| Componente | Requisito | Por que es necesario |
|---|---|---|
| Hadoop | Hadoop 2.x o 3.x, con HADOOP_HOME exportado | Proporciona HDFS y el motor de ejecución. Sin HADOOP_HOME, Pig 0.18.0 recurre a un Hadoop 2.7.3 integrado. |
| Java | Java 1.7 o posterior, con JAVA_HOME configurado en la raíz de instalación. | Pig y los demonios de Hadoop son Java programas |
| Python (opcional) | Python 2.7 | Solo necesario para la transmisión en directo Python funciones definidas por el usuario |
| Hormiga (opcional) | Hormiga 1.8 | Solo es necesario al compilar o recompilar Pig desde el código fuente. |
Dos puntos prácticos acompañan a esa lista. Primero, ejecute todo como un usuario de Linux que ya tenga un directorio de inicio en HDFS y permiso para escribir en él; este tutorial utiliza hduser, la cuenta creada durante la configuración de Hadoop. En segundo lugar, inicie el clúster antes de lanzar Pig en modo MapReduce, ya que Pig falla inmediatamente si NameNode y ResourceManager están inactivos. Si Hadoop aún no está instalado, trabaje a través de Cómo instalar Hadoop de antemano.
Cómo descargar e instalar Pig
Ahora, en este tutorial de Apache Pig, aprenderemos cómo descargar e instalar Pig:
Antes de comenzar con el proceso propiamente dicho, asegúrese de tener Hadoop instalado. Cambie el usuario a 'hduser' (el ID utilizado durante la configuración de Hadoop; puede cambiar al ID de usuario utilizado durante su propia configuración de Hadoop).

Paso 1) Descargue la última versión estable de Pig Hadoop desde cualquiera de los sitios espejo disponibles en
https://pig.apache.org/releases.html
Seleccione el archivo tar.gz (y no src.tar.gz) para descargar, como se muestra a continuación.

Paso 2) Una vez completada la descarga, navegue hasta el directorio que contiene el archivo tar descargado y mueva el archivo tar a la ubicación donde desea configurar Pig Hadoop. En este caso, lo moveremos a /usr/local.

Acceda al directorio que contendrá los archivos de Pig Hadoop.
cd /usr/local
ExtracEl contenido del archivo tar es el siguiente.
sudo tar -xvf pig-0.12.1.tar.gz

Paso 3) Modifique el archivo ~/.bashrc para agregar variables de entorno relacionadas con Pig.
Abra el archivo ~/.bashrc con cualquier editor de texto de su elección y realice las modificaciones que se indican a continuación.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Paso 4) Ahora, configure este entorno utilizando el siguiente comando.
. ~/.bashrc

Paso 5) Necesitamos recompilar Pig para que sea compatible con Hadoop 2.2.0.
Aquí están los pasos para hacerlo.
Ve al directorio principal de Pig.
cd $PIG_HOME
Instalar hormiga.
sudo apt-get install ant

Nota: La descarga comenzará y consumirá tiempo según la velocidad de su conexión a internet.
Recompilar Pig.
sudo ant clean jar-all -Dhadoopversion=23

Tenga en cuenta que en este proceso de recompilación se descargan varios componentes, por lo que el sistema debe estar conectado a Internet.
Además, en caso de que este proceso se quede bloqueado en algún punto y no vea ningún movimiento en la línea de comandos durante más de 20 minutos, pulse Ctrl + c y vuelva a ejecutar el mismo comando.
En nuestro caso, tarda 20 minutos.

Este paso de recompilación pertenece a la era 0.12.1, cuando los jar enviados se compilaron contra Hadoop 1 y el -Dhadoopversion=23 La opción flag cambió la compilación de Ant a la línea Hadoop 0.23 y 2.x. Apache Pig 0.18.0 incluye binarios que ya se ejecutan en Hadoop 2.7 y versiones posteriores, así como en Hadoop 3, por lo que en una versión actual normalmente puede descomprimir el archivo tarball y pasar directamente a la prueba que se muestra a continuación.
Paso 6) Pruebe la instalación de Pig usando el comando
pig -help

Ejemplo de script de cerdo
Una vez instalado Pig, el resto de este tutorial de Apache Pig ejecuta un script completo. Usaremos scripts de Pig para averiguar la cantidad de productos vendidos en cada país.
Entrada: Nuestro conjunto de datos de entrada es un archivo CSV, VentasEne2009.csv.
Paso 1) Iniciar Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Paso 2) Pig in Big Data toma un archivo de HDFS en modo MapReduce y almacena los resultados de nuevo en HDFS.
Copie el archivo SalesJan2009.csv (almacenado en el sistema de archivos local en ~/input/SalesJan2009.csv) al directorio principal de HDFS (Hadoop Distributed File System).
En este ejemplo de Apache Pig, el archivo se encuentra en la carpeta especificada. Si el archivo está almacenado en otra ubicación, utilice ese nombre.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Verifique si el archivo se copió realmente o no.
$HADOOP_HOME/bin/hdfs dfs -ls /

Paso 3) Configuración del cerdo.
Primero, diríjase a $PIG_HOME/conf y guarde una copia del archivo de propiedades original.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Abra el archivo pig.properties con el editor de texto que prefiera y especifique la ruta del archivo de registro usando pig.logfile.
sudo gedit pig.properties

El registrador utilizará este archivo para registrar los errores.
Paso 4) Ejecuta el comando 'pig', que iniciará el indicador de comandos de Pig, una consola interactiva para realizar consultas a Pig.
pig

Paso 5) En la consola de comandos de Grunt para Pig, ejecute los siguientes comandos de Pig en orden.
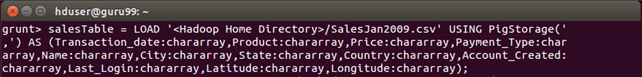
— A. Cargue el archivo que contiene los datos.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Presione Enter después de este comando.
— B. Agrupar los datos por el campo País.
GroupByCountry = GROUP salesTable BY Country;

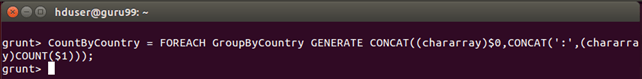
— C. Para cada tupla en 'GroupByCountry', genere la cadena resultante con el formato Nombre del país: Número de productos vendidos.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Presione Enter después de este comando.
— D. Almacene los resultados del flujo de datos en el directorio 'pig_output_sales' en HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Este comando tardará un tiempo en ejecutarse. Una vez finalizado, debería ver la siguiente pantalla.

Paso 6) El resultado se puede ver a través de la interfaz de comandos como
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Los resultados también pueden consultarse a través de una interfaz web.
Abra http://localhost:50070/ en un navegador web.
El puerto 50070 es la interfaz web de NameNode en Hadoop 2. Hadoop 3 trasladó la misma página al puerto 9870, así que utilice esa dirección si su clúster ejecuta Hadoop 3.

Ahora seleccione 'Explorar el sistema de archivos' y navegue hasta /user/hduser/pig_output_sales.

Abra part-r-00000 para leer los pares de país y cantidad de producto que generó el script.

Apache Pig vs Hive vs MapReduce
Pig rara vez se evalúa por sí solo. La pregunta habitual es si un trabajo pertenece a Pig, en Colmena o en un programa MapReduce escrito a mano, ya que los tres terminan siendo trabajos en el mismo clúster.
| Aspecto | MapReduce (Java) | Cerdo apache | Colmena Apache |
|---|---|---|---|
| Fácil de usar | Java API | Pig Latin, un lenguaje de scripting para el flujo de datos. | ColmenaQL, un dialecto SQL |
| Nivel de abstracdisrupción | Bajo | Media | Alto |
| Usuario típico | Java developer | Ingeniero o investigador de datos | Analista con conocimientos de SQL |
| Datos que le convienen | Cualquier cosa, manejada manualmente | Estructurado y semiestructurado; el esquema es opcional en el momento de la carga. | Tablas estructuradas registradas en un metastore |
| Code volumen | La mayoría de las líneas | Menos líneas | Menos líneas para una consulta |
| Se ejecuta como | Un trabajo MapReduce | Compila a MapReduce, Tez o Spark recibas nuevas vacantes en tu correo | Compila a MapReduce, Tez o Spark recibas nuevas vacantes en tu correo |
| Mejores en | Control total y lógica personalizada | Pipelines ETL de múltiples pasos | Consultas e informes ad hoc |
En la práctica, la división es sencilla. Recurra a Hive cuando los datos ya parezcan una tabla y la pregunta parezca SQL. Recurra a Pig cuando la entrada sea desordenada, cuando la canalización sea una cadena de transformaciones en lugar de una sola consulta, o cuando el mismo script tenga que ramificarse y volver a unirse. Recurra a MapReduce solo cuando ninguno de los dos sea adecuado.tracLa ción puede expresar la lógica, porque el número de líneas crece rápidamente.
El cerdo también se integra perfectamente con el resto del ecosistema. Sqoop y Flume aterrizar los datos sin procesar, Pig o Hive darles forma, y un planificador como apache oozie encadena los pasos en una secuencia repetible. Para obtener una visión más amplia de dónde encajan estas herramientas, consulte la guía para grandes volúmenes de datos y el resumen de herramientas de big dataPara una alternativa comercial de ETL a los scripts escritos a mano, consulte Talend.
