
Cómo instalar y configurar HIVE Metastore con MYSQL
 Equipo editorial
⚡ Resumen inteligente
Hive metastore almacena cada definición de tabla, nombre de columna y tipo de datos detrás de Apache Hive, y mover ese repositorio de la base de datos Derby predeterminada a MySQL es lo que permite que varios usuarios se conecten a la vez.
¿Qué es HIVE Metastore?
Hive metastore es un repositorio que almacena metadatos (nombres de columnas, tipos de datos, comentarios, etc.) relacionados con Colmena Apache usando MySQL or PostgreSQL. Este metastore de Hive se implementa mediante tablas en una base de datos relacional.
En el metastore no se almacenan las filas en sí. Los registros permanecen en HDFS, y el metastore solo registra dónde reside cada tabla y cómo se llaman sus columnas, por lo que su pérdida afecta al esquema, no a los datos.
Por qué utilizar MySQL en Hive como Metastore
El backend de metastore es opcional, no una parte fija de Hive, y la configuración predeterminada es deliberadamente minimalista. Tres limitaciones hacen que casi todas las instalaciones lo descarten.
- Por defecto, Hive incluye la base de datos Derby como metastore.
- Derby solo puede admitir un único usuario activo a la vez.
- Derby no se recomienda para entornos de producción.
Entonces, la solución aquí es
- Usar MySQL como almacenamiento de metadatos en el backend para conectar a varios usuarios con Hive a la vez.
- MySQL es la mejor opción para el metastore independiente
Cómo instalar y configurar Hive Metastore para MySQL Database
Los nueve pasos que se describen a continuación se ejecutan en orden en una máquina que ya tiene Hadoop y Hive instalados. Cada paso finaliza con una captura de pantalla de la salida real de la terminal o la consola.
Paso 1) Instalar MySQL Server
En este paso, vamos a realizar dos tareas.
- Instalación de mysql-server
- Comprobando el servidor MySQL y su proceso
Usando el sudo apt-get install mysql-server comando, podemos descargar MySQL servidor. Instalar MySQL como se muestra en la captura de pantalla a continuación.

Después de una instalación exitosa, MySQL Se ejecutará como se muestra en la captura de pantalla a continuación, donde la comprobación del proceso confirma que el servicio está activo.

Paso 2) Instalar MySQL Java Conector
Instalación de la MySQL Java conector. Esto es para Java dependencias y propósitos de conexión, porque Hive alcanza MySQL a través de JDBC. La siguiente captura de pantalla muestra la instalación del paquete.

Paso 3) Crear un enlace suave para el conector
Creando un enlace simbólico para el conector en el directorio lib de Hive. Este es el enlace simbólico entre Java y MySQLy es lo que coloca el archivo JAR del controlador en el classpath de Hive. El comando y su resultado aparecen a continuación.

Paso 4) Configuración MySQL almacenamiento en Hive
El MySQL Es necesario abrir la consola como usuario root antes de poder crear cualquier usuario de Hive, como se muestra a continuación.

- Escriba mysql –u root –p seguido de la contraseña.
- Aquí, –u representa el nombre de usuario root y –p denota la contraseña.
- Después de ingresar el comando anterior, el usuario debe ingresar una contraseña válida y luego presionar Enter.
- Entonces entrará en MySQL modo shell
Paso 5) Crear nombre de usuario y contraseña
Creación de un nombre de usuario y contraseña para MySQLy otorgando privilegios. La captura de pantalla a continuación muestra las tres instrucciones que se ejecutan dentro del MySQL cáscara.

Tenemos que ejecutar los comandos como se muestra a continuación,
mysql> CREATE USER 'hiveuser'@'%' IDENTIFIED BY 'hivepassword';
mysql> GRANT all on *.* to 'hiveuser'@localhost identified by 'hivepassword';
mysql>  flush privileges;
On MySQL 8. La forma combinada de la segunda instrucción ya no se analiza correctamente, porque se eliminó IDENTIFIED BY de GRANT. Primero cree la cuenta y luego otórguele el permiso, y repita la línea CREATE USER tanto para el host localhost como para el host comodín.
Paso 6) Configurar hive-site.xml
- Después del paso 5 se asigna un nombre de usuario y una contraseña al MySQL base de datos y otorga privilegios.
- Aquí configuraremos algunas propiedades en Hive para obtener una conexión con el MySQL base de datos.
El archivo de configuración se abre desde el directorio conf de Hive, como se muestra en la siguiente captura de pantalla.

La captura de pantalla que aparece a continuación muestra el archivo final con las cuatro propiedades ya incluidas.

De la captura de pantalla anterior, observamos lo siguiente. Aquí estamos definiendo 4 propiedades que son necesarias para establecer MySQL como el metastore en Hive.
Estos son los siguientes:
- Esta propiedad es para la conexión URLAquí estamos definiendo la conexión.URL en esta propiedad. Actúa como la cadena de conexión JDBC y también representa la ubicación del metastore.
- Esta propiedad es para el nombre del controlador de conexión. Aquí, com.mysql.jdbc.Driver es el valor que debemos mencionar en la etiqueta de valor.
- Esta propiedad se utiliza para definir el nombre de usuario de la conexión. En este caso, definimos "hiveuser" como el nombre de usuario.
- Esta propiedad se utiliza para indicar la contraseña de conexión. En este caso, definimos "hivepassword" como la contraseña del usuario.
Una vez que las propiedades se colocan en hive-site.xml, debemos guardar manualmente (Ctrl+S) y cerrar el archivo. Después de cerrar este archivo, debemos crear una tabla de Hive y verificar los detalles de la tabla en MySQL almacenamiento.
Coloque este código en hive-site.xml
colmena-sitio.xml
<configuration>
	<property>
		<name>javax.jdo.option.ConnectionURL</name>
		<value>jdbc:mysql://localhost/metastore?createDatabaseIfNotExist=true</value>
		<description>metadata is stored in a MySQL server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionDriverName</name>
		<value>com.mysql.jdbc.Driver</value>
		<description>MySQL JDBC driver class</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionUserName</name>
		<value>hiveuser</value>
		<description>user name for connecting to mysql server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionPassword</name>
		<value>hivepassword</value>
		<description>password for connecting to mysql server</description>
	</property>
</configuration>
Los dos valores anteriores dependen de la versión del conector que se esté utilizando. MySQL Connector/J 8 cambió el nombre de la clase del controlador a com.mysql.cj.jdbc.Driver, y también espera una configuración explícita de puerto y SSL, por lo que una versión moderna URL Normalmente se lee jdbc:mysql://localhost:3306/metastore?createDatabaseIfNotExist=true&useSSL=false. Dado que la contraseña está en texto plano, el archivo solo debería ser legible por la cuenta de servicio de Hive.
Paso 7) Crear tabla
Cree la tabla “guru99” en Hive, como se muestra en la consola de Hive a continuación.

De la captura de pantalla anterior, podemos observar lo siguiente
- Creación de una tabla llamada “guru99” con dos nombres de columna
- Se mencionan los nombres de las columnas con sus tipos de datos, uno de ellos un entero y el otro una cadena de caracteres.
En el siguiente paso, vamos a comprobar si está almacenado en MySQL o no.
Paso 8) Ingrese a MySQL modo shell
En primer lugar, se selecciona la base de datos del metastore, y a continuación se muestra el listado de tablas.

De la captura de pantalla anterior, podemos observar lo siguiente
- Primero tenemos que seleccionar la base de datos con “usar metastore”.
- Una vez seleccionado el metastore, podemos comprobar las tablas que contiene utilizando el comando "show tables", como se muestra en la captura de pantalla.
- Cualesquiera que sean las tablas que se creen en Hive, los metadatos correspondientes a esas tablas se almacenan en TBLS en el MySQL base de datos de CRISPR Medicine News
- La tabla “guru99” se crea en Hive, por lo que los metadatos correspondientes se almacenan en MySQL bajo TBLS
Paso 9) Ingrese seleccione * de TBLS
Comprobando si la tabla creada está presente en MySQL o no. La consulta y su resultado aparecen en la captura de pantalla a continuación.
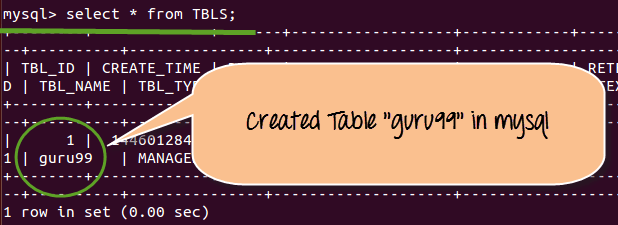
Al ingresar select * desde TBLS, se mostrarán las tablas que creamos en el modo shell de Hive.
De la captura de pantalla anterior podemos observar lo siguiente:
- El nombre de la tabla “guru99” que se creó en Hive se puede mostrar en MySQL modo shell
- Además, también proporcionará información como la hora de creación de la tabla, la hora de acceso y otras propiedades, como se muestra en la captura de pantalla anterior.
Cómo inicializar el esquema del metastore de Hive con schematool
El indicador createDatabaseIfNotExist en la conexión URL crea una base de datos de metastore vacía, pero no crea las aproximadamente setenta tablas que Hive espera dentro de ella. En Hive 1.x y versiones posteriores, esa tarea corresponde a la utilidad schematool y se omite.ping Es la razón más común por la que un metastore recién configurado se niega a iniciarse.
$HIVE_HOME/bin/schematool -dbType mysql -initSchema
El comando lee las mismas cuatro propiedades del archivo hive-site.xml, se conecta con la cuenta de usuario de Hive y ejecuta el script SQL incluido que coincide con la versión de Hive. Una ejecución exitosa finaliza con un mensaje de confirmación, tras lo cual se puede verificar el estado en cualquier momento.
$HIVE_HOME/bin/schematool -dbType mysql -info
Las banderas que se muestran a continuación abarcan todo el ciclo de vida de un esquema de metastore.
| Opción | ¿Qué hace? |
|---|---|
| -dbType | Indica el tipo de backend, como mysql, derby, postgres, oracle o mssql. |
| -inicializar esquema | Crea las tablas del metastore para la versión actual de Hive. |
| -información | Informa la versión del esquema registrada en la base de datos. |
| -actualizarEsquema | Migra un esquema existente después de una actualización de Hive. |
| -validar | Comprueba el esquema en busca de tablas faltantes y discrepancias de versión. |
Una propiedad relacionada que conviene conocer antes del primer inicio. Cuando hive.metastore.schema.verification es verdadero, Hive compara la versión del esquema en MySQL contra sí mismo y se niega a ejecutarse en caso de discrepancia. Esa comprobación es una medida de seguridad, por lo que la respuesta correcta es ejecutar la actualización en lugar de desactivarla. Lo mismo MySQL El backend es utilizado por la instalación de Hive que se describe en instalar Hive en Ubuntu.
Errores comunes del metastore de Hive y cómo solucionarlos.
La mayoría de los fallos en esta etapa producen uno de un puñado de mensajes, y cada uno apunta a un paso específico superior en lugar de a Hive en sí.
| Síntoma | Causa y solución |
|---|---|
| No se encontró información de versión en el metastore. | El esquema nunca se creó. Ejecute schematool con -initSchema contra la misma base de datos especificada en la conexión. URL |
| Excepción ClassNotFoundException para el controlador JDBC | El archivo JAR del conector no se encuentra en el directorio lib de Hive, o bien se está utilizando Connector/J 8 y la clase ahora es com.mysql.cj.jdbc.Driver. Vuelva a comprobar el enlace simbólico del paso 3. |
| Acceso denegado para el usuario hiveuser. | Los privilegios se otorgaron a un solo host. Cree la cuenta tanto para localhost como para el host comodín y luego ejecute flush privileges. |
| Error de sintaxis cerca de IDENTIFIED BY | MySQL 8. Se eliminó IDENTIFIED BY de la instrucción GRANT. Primero ejecute CREATE USER y después GRANT. |
| No se permite la recuperación de la clave pública. | Connector/J 8 rechaza de forma predeterminada un handshake no cifrado. Añada useSSL=false y allowPublicKeyRetrieval=true al JDBC. URL en una red de confianza |
| Faltan tablas después de una actualización de Hive. | El esquema aún coincide con la versión anterior. Ejecute schematool con -upgradeSchema en lugar de deshabilitar la verificación del esquema. |
Una vez que el metastore responde de manera confiable, las definiciones de tabla que registra se crean con las instrucciones descritas en Tabla de creación, modificación y eliminación de Hive.
